
- AIの基本的な賢さは、誰でも同じように買えます。競合がまねできないのは、自社の実際の業務から生まれるデータです。
- 最も価値のあるデータは、整ったデータベースよりも、作業伝票やメール、あちこちに散らばったファイルの中にあることが多いものです。
- テクノロジーのことを考える前に、どのデータがどこにあり、誰が管理しているかの一覧を作るところから始めてください。
1. 基本的な賢さが買えるようになると、自社だけの知識の価値が上がる
自社と競合が同じAIを使えば、手に入る賢さも同じです。競合がまねできない唯一のものは、自社の中でしか起きないことです。顧客がどんな不満を口にしたか、どの仕事で問題が起きたか、技術者がそれをどう直したか、といったことです。これはお金では買えません。
汎用的なモデルは、文章を書く力も、要約や分析の力も、どんどん上がっています。しかし、自社がどんな顧客を優良顧客と考えているか、どんな条件のときにプロジェクトが遅れるか、どんな回答なら顧客が離れずにいてくれるかは知りません。こうした情報は実際の業務から生まれるもので、インターネット上にはありません。
データの堀(Data Moat)になるデータとは、成果と結びついていて、品質がよく、正しい権限のもとで使え、意思決定に還元されているデータのことです。量の多さはあまり関係ありません。競合はAIの機能なら数か月でまねできるかもしれませんが、何年もかけて積み上げたフィードバックの履歴や、自社ならではの理解をまねるのは困難です。
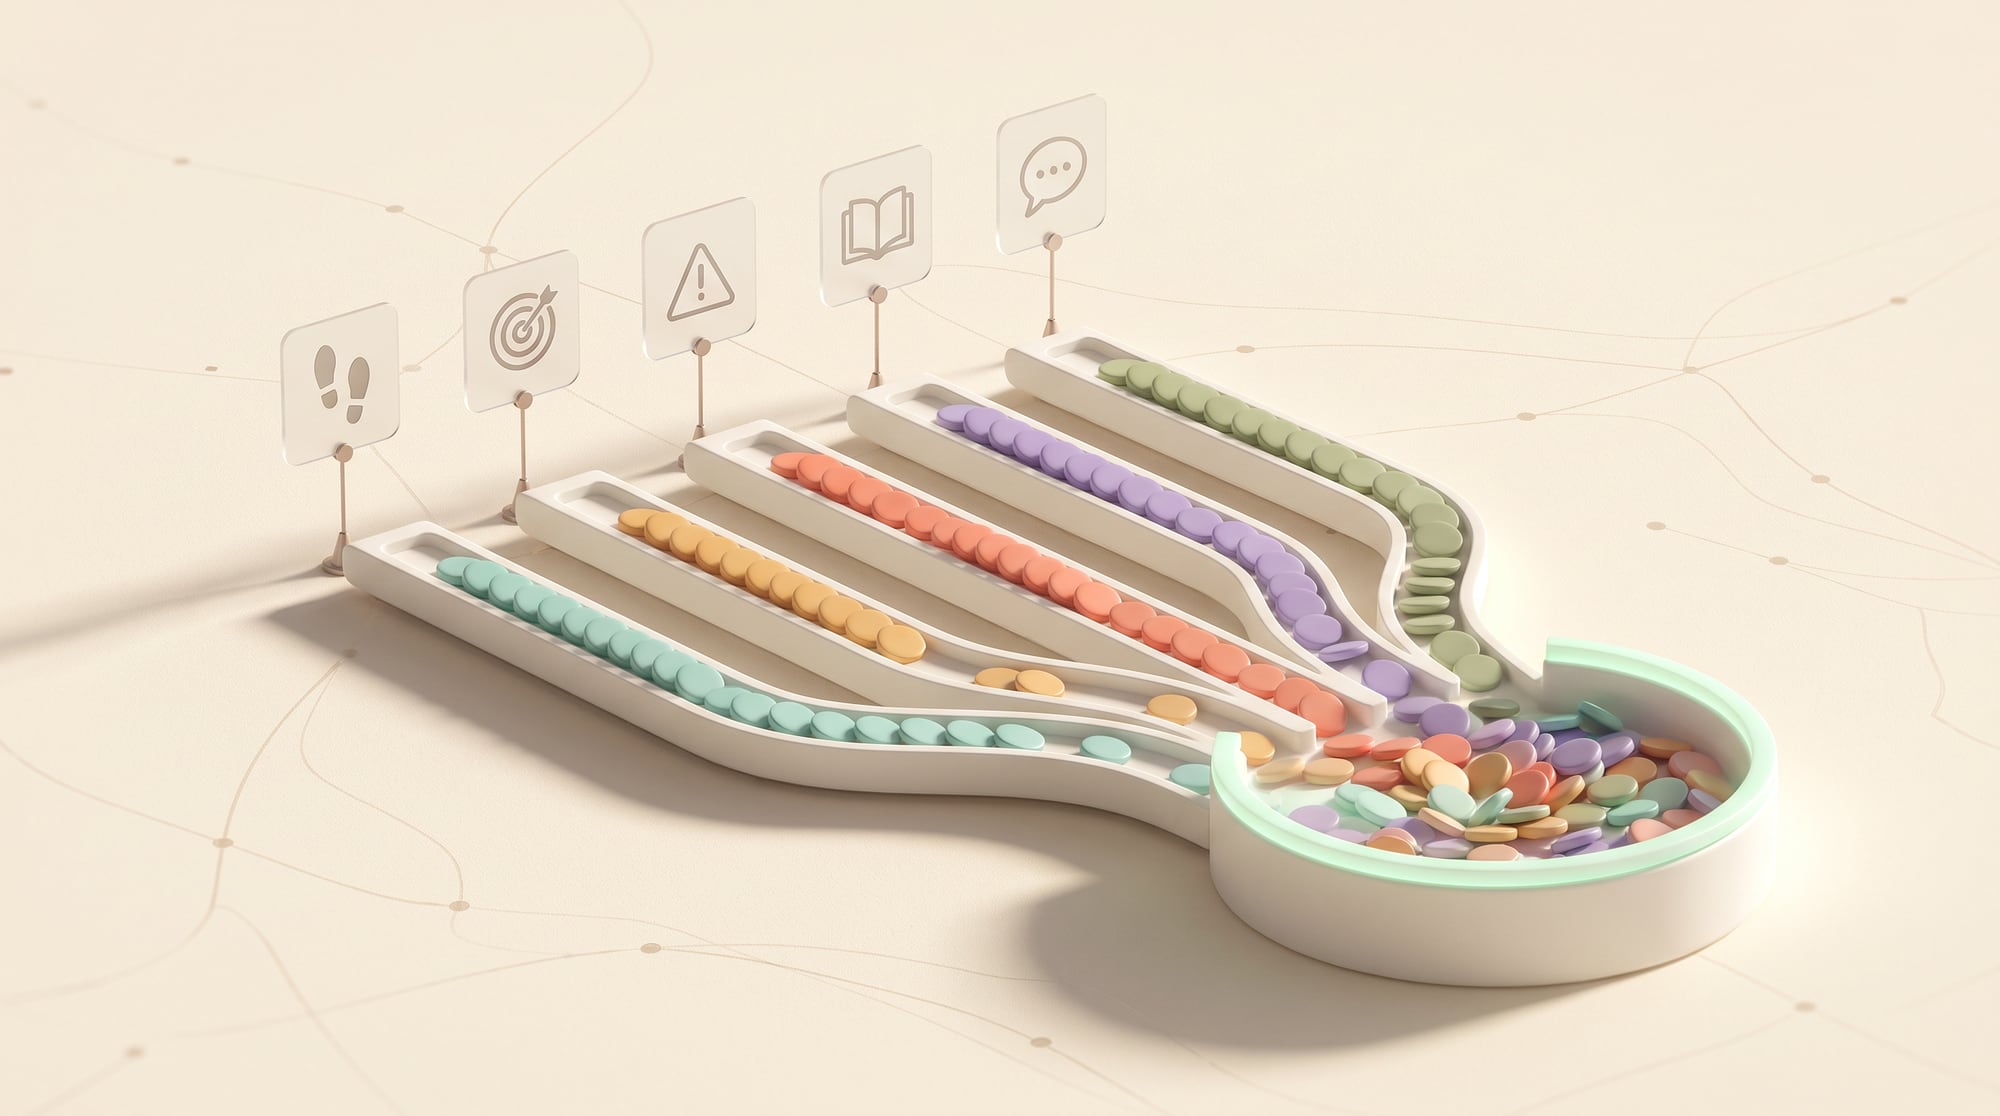
2. 差を生む5種類のデータ
データの価値はさまざまです。誰でもインターネットで見つけられる情報は、ほとんど役に立ちません。一方、自社でどんなケースがどう決着したかの記録は、ほかでは手に入りません。
- Behavioral Data:顧客が好きだと言うものより、実際に何をしたかを示すデータです。
- Outcome Data:どの解決策が売上、継続利用、品質の向上、コスト削減につながったかを示すデータです。
- Exception Data:どのケースが標準から外れ、専門家がそれをどう解決したかを示すデータです。
- Domain Knowledge:業界の人が知っているルール、理由、トレードオフです。
- Feedback Data:下書きへの修正、却下、そして成果物が合わなかった理由です。
大量のマーケティング資料より、商談で顧客から出た反論とその結果を結びつけた記録のほうが、価値が高いこともあります。データが価値を持つのは、判断のための問いに答えたり、ワークフローを改善したりするのに役立つときです。大きさだけでは価値になりません。
3. 経営者の視点でデータを棚卸しする
すべてのデータベースを調べて回るのではなく、ユースケースから始めます。リード(見込み客)の優先順位づけや代替商品の提案といった重要な判断を1つ選び、使うデータ、その出どころ、責任者、品質、利用権限、結びつく成果を書き出します。そのうえで、数字や回答がどこから来て、いつ更新されるのかをたどれるデータリネージを整えます。
| データ | 責任者 | 品質 | AIでの利用権限 | 結びつく成果 |
|---|---|---|---|---|
| 顧客履歴 | 営業オペレーション | 主要な項目の85%が埋まっている | 社内利用のみ | Conversion/Retention |
| 問い合わせチケット | サポート部門 | 文章の質はよいが、分類がばらばら | 個人を特定できる情報(PII)のマスキングが必要 | Resolution/CSAT |
| マニュアル | 製品部門 | 一部が古くなっている | グループごとに利用可 | Answer Quality |
データをCritical、Useful、Archiveの3段階に分けます。すべてを一度にきれいにしようとしないでください。最初のワークフローに必要なデータに投資し、あとで広げられる標準をつくります。責任者のいないデータを、正解データ(Ground Truth)として使ってはいけません。
4. 散らばったファイルをナレッジレイヤーに変える
開発チーム向け · システム構成
ナレッジレイヤーには、承認済みのコンテンツ、メタデータ、バージョン、発効日、責任者、アクセスポリシーが必要です。ステータスを管理しないまますべてのファイルをベクトルデータベースに入れると、AIが古い価格や廃止された規定を拾ってしまうおそれがあります。情報源の優先順位と、データが食い違ったときの答え方を決めておきます。
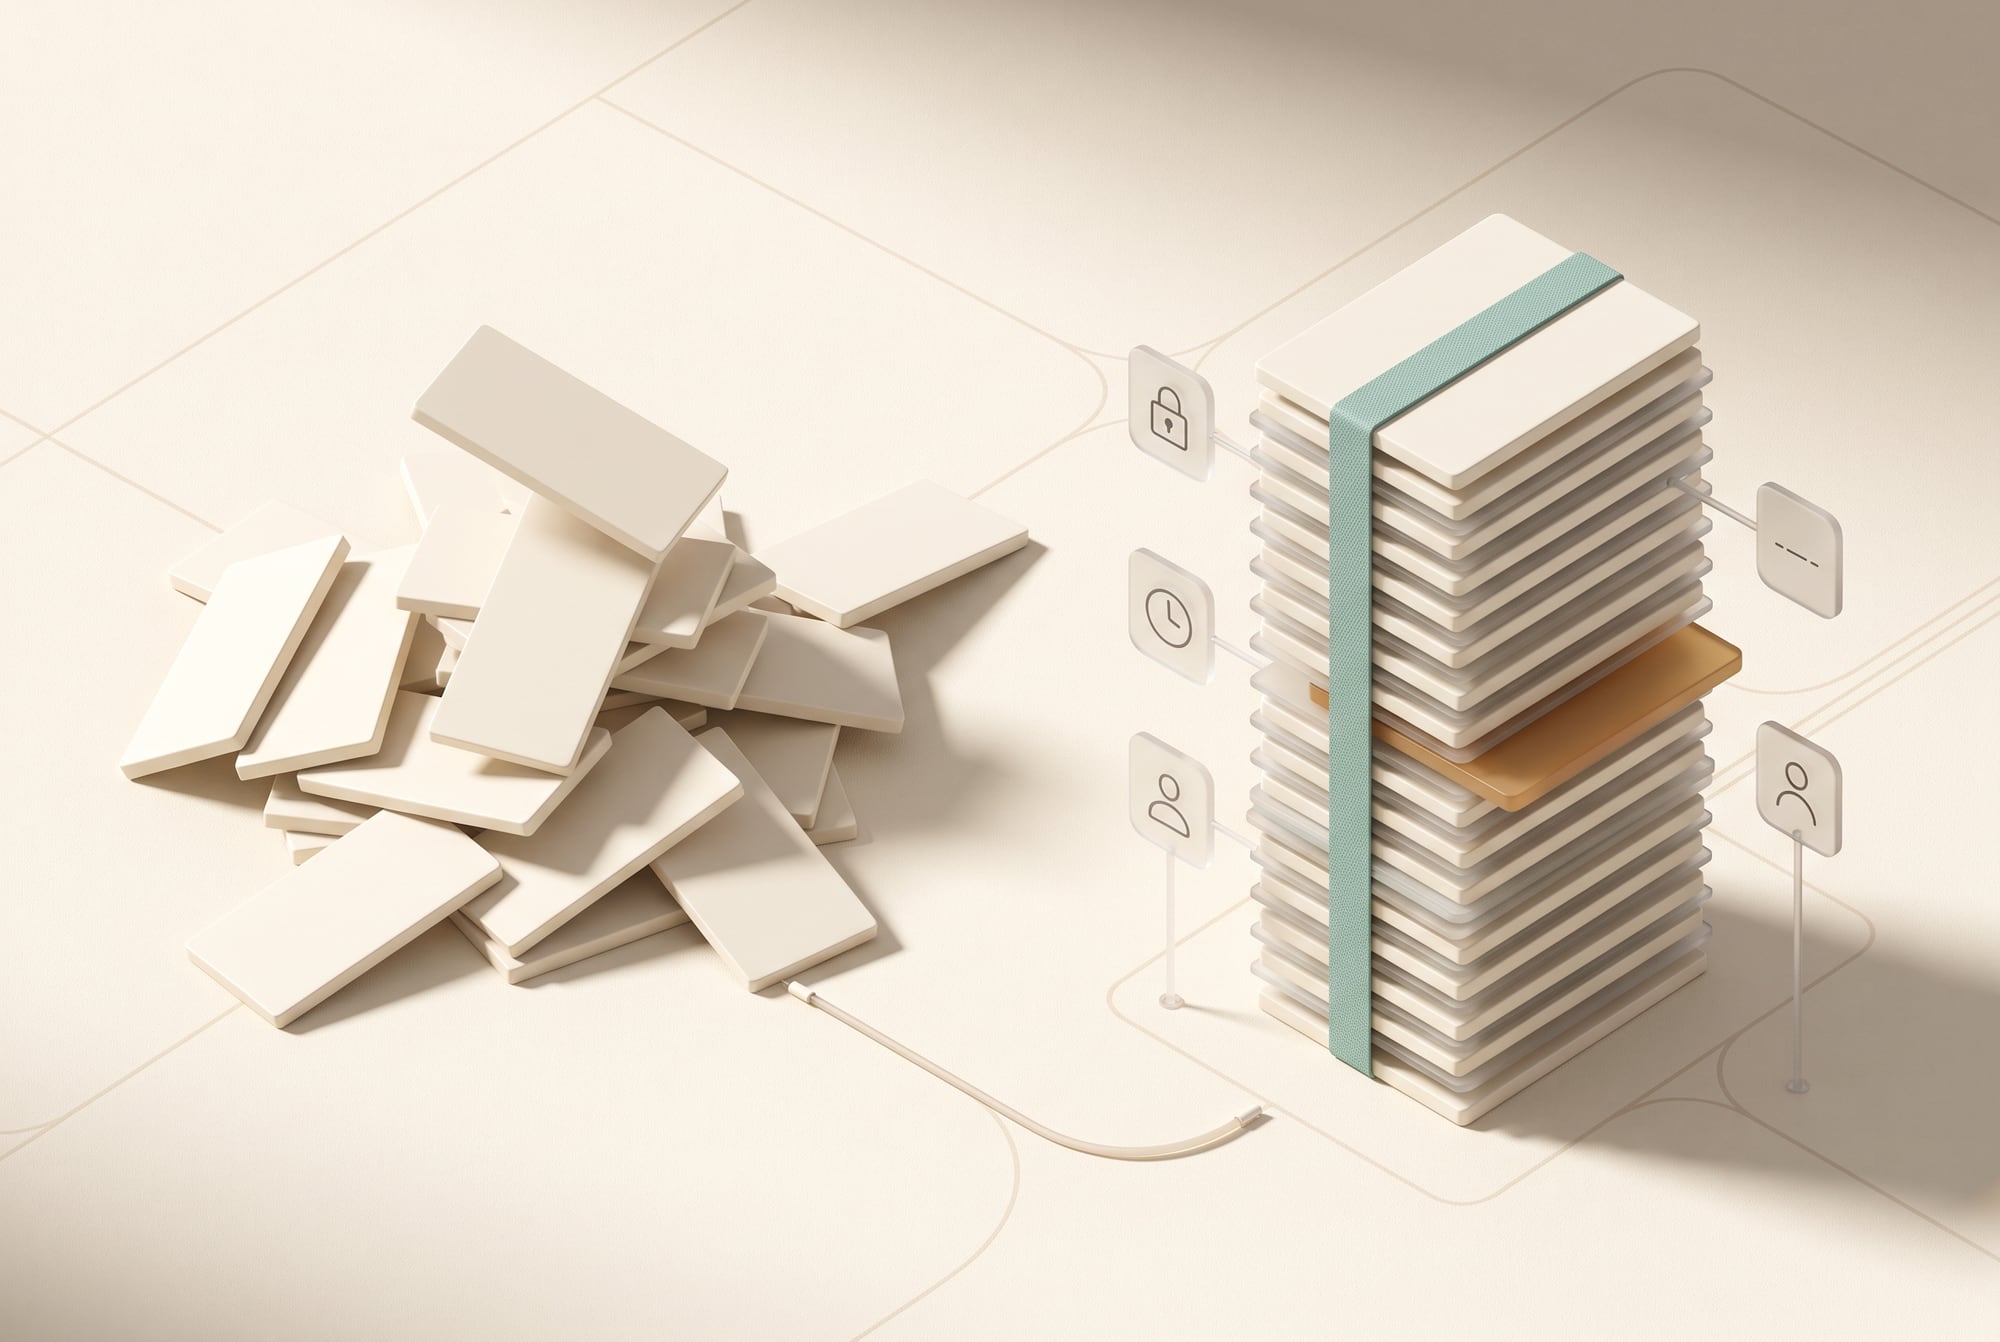
事実、規定、事例、意見を分けます。事実は基幹システムから取り、規定には承認者を置きます。事例は型を教えるためのもので、ルールとして扱いません。意見は意見だとわかるように示します。システムは出典を示し、日付を表示して、利用者が確かめられるようにします。
開発チーム向け · 技術的な詳細
コンテンツのライフサイクル(Draft → Review → Approved → Deprecated)を設け、責任者にリマインダーが届くようにします。ナレッジの管理は継続的な運用業務で、一度きりの移行プロジェクトでは終わりません。
5. 取引のたびに良くなるフィードバックのフライホイールをつくる
人がAIの出力を直したら、最終版だけを残すのはやめましょう。何を直したか、誤りの種類、理由を記録し、顧客セグメントや成果と結びつけます。たとえば、手直ししたメッセージで成約に至った、ある回答で同じ問い合わせが減った、といった結果です。このデータは、プロンプト、ルール、ナレッジ、評価の改善に使います。
フィードバックを、すべて自動的に学習に回すべきではありません。人の修正が間違っていることもあれば、特殊なケースのこともあるからです。手本とするデータ(ゴールデンデータ)には、抜き取り検査と承認の手順が必要です。質が高く多様なフィードバックを選び、特定の利用者グループによるバイアスを抑えます。
6. 権限、品質、信頼も堀の一部になる
開発チーム向け · 技術的な詳細
同意がない、あるいは漏えいのおそれがあるといった理由で使えないデータは、資産とは言えません。利用目的の制限、保存期間、マスキング、役割に応じたアクセス権限を定めます。業務運用、分析、モデル改善に使うデータは分けて管理し、1つの許可ですべての目的をまかなえるとは考えないようにします。
重要な項目について、網羅性、鮮度、正確さといったデータ品質のSLAを定め、基準を外れたときの責任者も決めます。監視の仕組みでは、顧客の行動パターンが変わったのにルールが古いまま、といったドリフトに気づけるようにします。また、関連する規定に沿って、顧客が自分のデータを訂正できる手段も用意します。
開発チーム向け · 技術的な詳細
エクスポートとデータポータビリティを確保し、ナレッジを1社のベンダーに縛りつけないようにします。情報源、メタデータ、評価は移行できる形式で保存し、データの堀が乗り換えのきかないサービスの中に閉じ込められず、自社の手元に残るようにします。
7. 行き先のないデータプロジェクトにせず、事業の成果につなげる
- コストを下げる:ナレッジが充実すれば、自動で解決できる割合が上がり、レビューが減ります。
- 売上を伸ばす:行動データと成果データを組み合わせると、勧めるべき提案とタイミングがわかります。
- 新しい商品をつくる:例外のパターンから、まだ誰も解決していない問題が見えてきます。
- スイッチングコストを高める:透明性を保ち、許可を得たうえで、顧客自身のデータを使うほど結果が良くなります。
- リスクを減らす:データリネージと根拠の記録が、監査や判断の説明に役立ちます。
開発チーム向け · 技術指標
どのデータ施策にも、価値仮説と指標を設けます。たとえば、検索時間を40%短縮する、一次解決率を15ポイント上げる、成約率を高めるリードスコアを作る、といったものです。取り込んだファイルの数やデータベースの大きさを、価値の代わりに使ってはいけません。
8. データの堀を築く18か月のロードマップ
開発チーム向け · システム構成
1〜3か月目:ユースケースを選び、重要なデータを棚卸しし、責任者を決めて品質を測ります。4〜6か月目:データリネージを備えたナレッジレイヤーを構築し、最初のワークフローを試します。7〜12か月目:フィードバックを成果と結びつけ、ゴールデンデータセットと評価の仕組みを作ります。13〜18か月目:製品をまたいで展開し、再利用できるデータプロダクトを作り、新しい商品やサービスの可能性を検討します。
まとめ:データの堀は、成果と結びつき、責任者と利用権限が決まっていて、フィードバックの循環がある自社だけのデータから生まれます。ファイルをたくさん貯めても堀にはなりません。会社は重要な判断から着手し、ナレッジレイヤーを構築し、修正の記録を構造化して残すべきです。モデルが入れ替わっても、自社の知識と学習の仕組みは差を生み続けます。
散らばったファイルを、システムが使える資産に変える
会社にとって最も価値のあるデータは、整ったデータベースより、技術者が手書きした作業伝票、営業担当が顧客に返したメール、上司が手元に保存しているファイルの中にあることが多いものです。こうした知識の持ち主は、私たちではなく社内のチームです。DNA Makerの役割は、データの棚卸しを手伝い、どのデータがどこにあり、誰が管理していて、どのデータがどんな判断に実際に使え、どのデータは品質が足りずにまだ使えないのかを見えるようにすることです。この段階で、会社には思っていた以上に良い材料があるものの、まだ機械が読めない形のままだとわかることがよくあります。
社内のチームと一緒に進める作業
次に、メタデータとアクセス権限がはっきりした保管の仕組みを設計し、新しいデータが途切れず流れ込むデータパイプラインを整えます。さらに、出典を示しながら質問に答えるRAG(検索拡張生成)の検索層を作り、社員が回答を信頼でき、さかのぼって確認もできるようにします。データを本当の強みに変えるのは、フィードバックの循環です。誰かが回答を直したり、仕事を完了させたりするたびに、システムはそれを保管庫に取り込まなければなりません。文書の保管場所が探しにくく、社員が電話で聞き合うほうを選んでいるなら、そこから一緒に始められます。
SOFTWARE ENGINEERING GLOSSARY
ソフトウェア開発用語集
ここに挙げる用語は、社内のデータをシステムで使える形に変える話をするときに役立ちます。
| 用語 | 意味 | わかりやすい例 | 開発チームへの質問 |
|---|---|---|---|
| Metadata | 誰が作ったか、いつ作ったか、どの商品に関するものかといった、データを説明するデータで、検索や絞り込みに使う | このマニュアルがどの機種向けで、いつ最後に更新されたかを記録しておく | メタデータがなければ、システムはどの文書がまだ有効かをどうやって判断するのですか? |
| RAG | AIが一般的な知識から推測する代わりに、会社の実際のデータを検索して回答を組み立てる方法 | 機械の設定方法を尋ねると、システムが最新版のマニュアルから答える | 回答はどの文書のどの版をもとにしていますか?情報が見つからないとき、システムは何と答えますか? |
| Citation | 回答の出典を示し、後から確かめられるようにすること | 回答に、参照したマニュアルのページへのリンクがついている | 利用者が回答を疑ったとき、どうやって確かめられますか? |
| Data Pipeline | データが元の場所からシステムで使う場所まで流れる経路で、途中でデータのクリーニングも行う | 毎晩、その日の作業伝票をナレッジの保管庫に取り込む | 元のデータの形式が変わったら、システムは気づいて通知しますか? |
| Data Retention | データをどれくらいの期間保存し、いつ削除するかを定めた方針 | 顧客との会話を、法律と社内規定が定める期間だけ保存する | 何を、どれくらいの期間保存していますか?この方針は誰が承認しましたか? |