
- AI의 기본 지능은 누구나 똑같이 살 수 있습니다. 경쟁사가 베낄 수 없는 것은 회사가 실제로 일하면서 쌓은 데이터입니다.
- 가장 값진 데이터는 깔끔하게 정리된 데이터베이스보다 작업 일지, 이메일, 여기저기 흩어진 파일 속에 있는 경우가 많습니다.
- 기술을 고민하기 전에, 어떤 데이터가 어디에 있고 누가 책임지는지 목록부터 만드십시오.
1. 기본 지능을 돈으로 살 수 있게 되면 고유한 지식의 가치가 올라갑니다
자사와 경쟁사가 같은 AI를 쓰면 얻는 지능도 같습니다. 경쟁사가 베낄 수 없는 것은 자사 안에서만 일어나는 일입니다. 고객이 무엇을 불평했는지, 어떤 작업이 잘못됐는지, 기술자가 어떻게 고쳤는지 같은 것들입니다. 이런 지식은 돈 주고 살 수 없습니다.
범용 모델은 글쓰기, 요약, 분석 실력이 계속 좋아지고 있습니다. 하지만 회사가 우량 고객을 어떻게 정의하는지, 어떤 조건에서 프로젝트가 늦어지는지, 어떤 답변이 고객을 붙잡는지는 모릅니다. 이런 정보는 실제 업무에서 생기고, 인터넷에는 없습니다.
데이터 해자(Data Moat)를 갖췄다는 것은 성과와 연결되어 있고, 품질이 좋고, 정당한 권한으로 쓸 수 있으며, 다시 의사결정에 반영되는 데이터가 있다는 뜻입니다. 양이 많은지는 별 상관이 없습니다. 경쟁사가 AI 기능은 몇 달 만에 따라 할 수 있어도, 여러 해 동안 쌓인 피드백 이력과 고유한 이해는 따라 하기 어렵습니다.
2. 차이를 만드는 다섯 가지 데이터
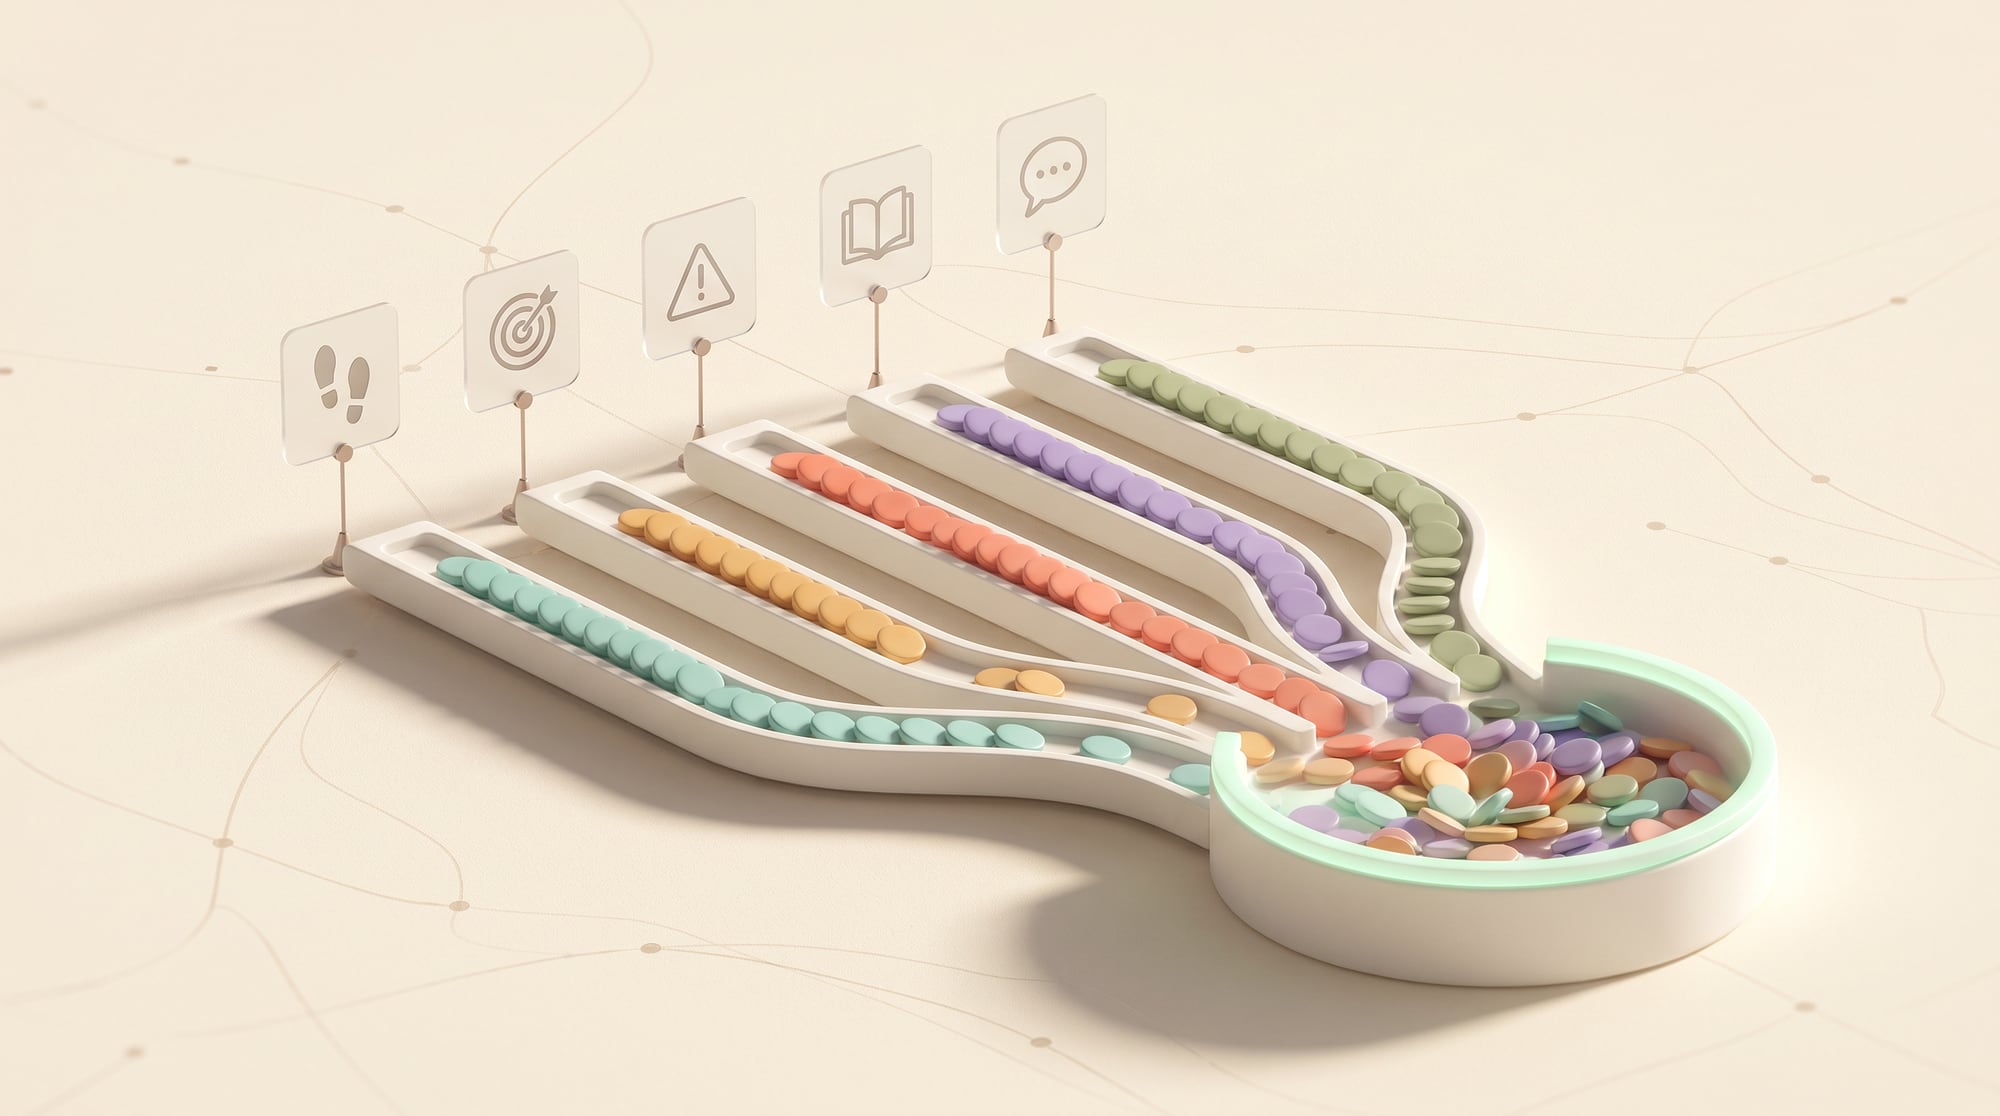
데이터의 가치는 제각각입니다. 누구나 인터넷에서 찾을 수 있는 정보는 거의 도움이 되지 않고, 자사에서 어떤 유형의 건이 어떻게 마무리됐는지 적은 기록은 귀합니다.
- 행동 데이터(Behavioral Data): 고객이 입으로 말하는 선호와 달리 실제로 보이는 행동
- 성과 데이터(Outcome Data): 어떤 해결책이 매출, 재이용, 품질 향상, 비용 절감으로 이어졌는지
- 예외 데이터(Exception Data): 어떤 건이 표준을 벗어났고 전문가가 어떻게 해결했는지
- 도메인 지식(Domain Knowledge): 업계 사람들이 아는 규칙, 그 이유, 트레이드오프
- 피드백 데이터(Feedback Data): 초안을 고친 내용, 반려한 기록, 결과물이 맞지 않았던 이유
마케팅 문서가 산더미처럼 있어도, 영업 현장에서 나온 고객의 반론을 결과와 함께 기록한 이력보다 가치가 낮을 수 있습니다. 데이터는 의사결정 질문에 답하고 워크플로를 개선하는 데 도움이 될 때 가치가 생깁니다. 크기만으로는 가치가 생기지 않습니다.
3. 회사 대표의 눈으로 데이터 목록(Data Inventory) 만들기
모든 데이터베이스를 조사하는 대신 활용 사례 하나에서 시작하십시오. 리드(잠재 고객) 우선순위 정하기나 대체 상품 추천처럼 중요한 결정 하나를 고른 다음, 그 결정에 쓰이는 데이터와 출처, 책임자, 품질, 사용 권한, 연결된 성과를 적습니다. 숫자나 답변이 어디서 오고 언제 업데이트되는지 보여 주는 데이터 계보(Data Lineage)도 그려 두십시오.
| 데이터 | 책임자 | 품질 | AI 사용 권한 | 연결된 성과 |
|---|---|---|---|---|
| 고객 이력 | 영업 운영팀 | 주요 항목 85% 채워짐 | 사내 한정 | Conversion/Retention |
| 문의 티켓 | 고객 지원팀 | 본문은 양호, 분류가 들쭉날쭉함 | 개인 식별 정보(PII) 마스킹 필수 | Resolution/CSAT |
| 매뉴얼 | 제품팀 | 일부 내용이 낡음 | 그룹별로 사용 가능 | Answer Quality |
데이터를 핵심(Critical), 유용(Useful), 보관(Archive) 등급으로 나누십시오. 모든 데이터를 한꺼번에 정리하려 하지 말고, 첫 워크플로에 필요한 데이터에 먼저 투자하면서 확장할 수 있는 기준을 세우십시오. 책임자가 없는 데이터는 정답 데이터(Ground Truth)로 써서는 안 됩니다.
4. 흩어진 파일을 지식 계층(Knowledge Layer)으로 바꾸기
개발팀 참고 · 시스템 구조
Knowledge Layer에는 승인된 콘텐츠와 Metadata, Version, Effective Date, Owner, Access Policy가 있어야 합니다. 상태 관리 없이 모든 파일을 Vector Database에 넣으면 AI가 옛 가격이나 폐지된 정책을 가져다 쓸 수 있습니다. 출처 간 우선순위와, 데이터가 서로 충돌할 때 어떻게 답할지를 정해 둡니다.
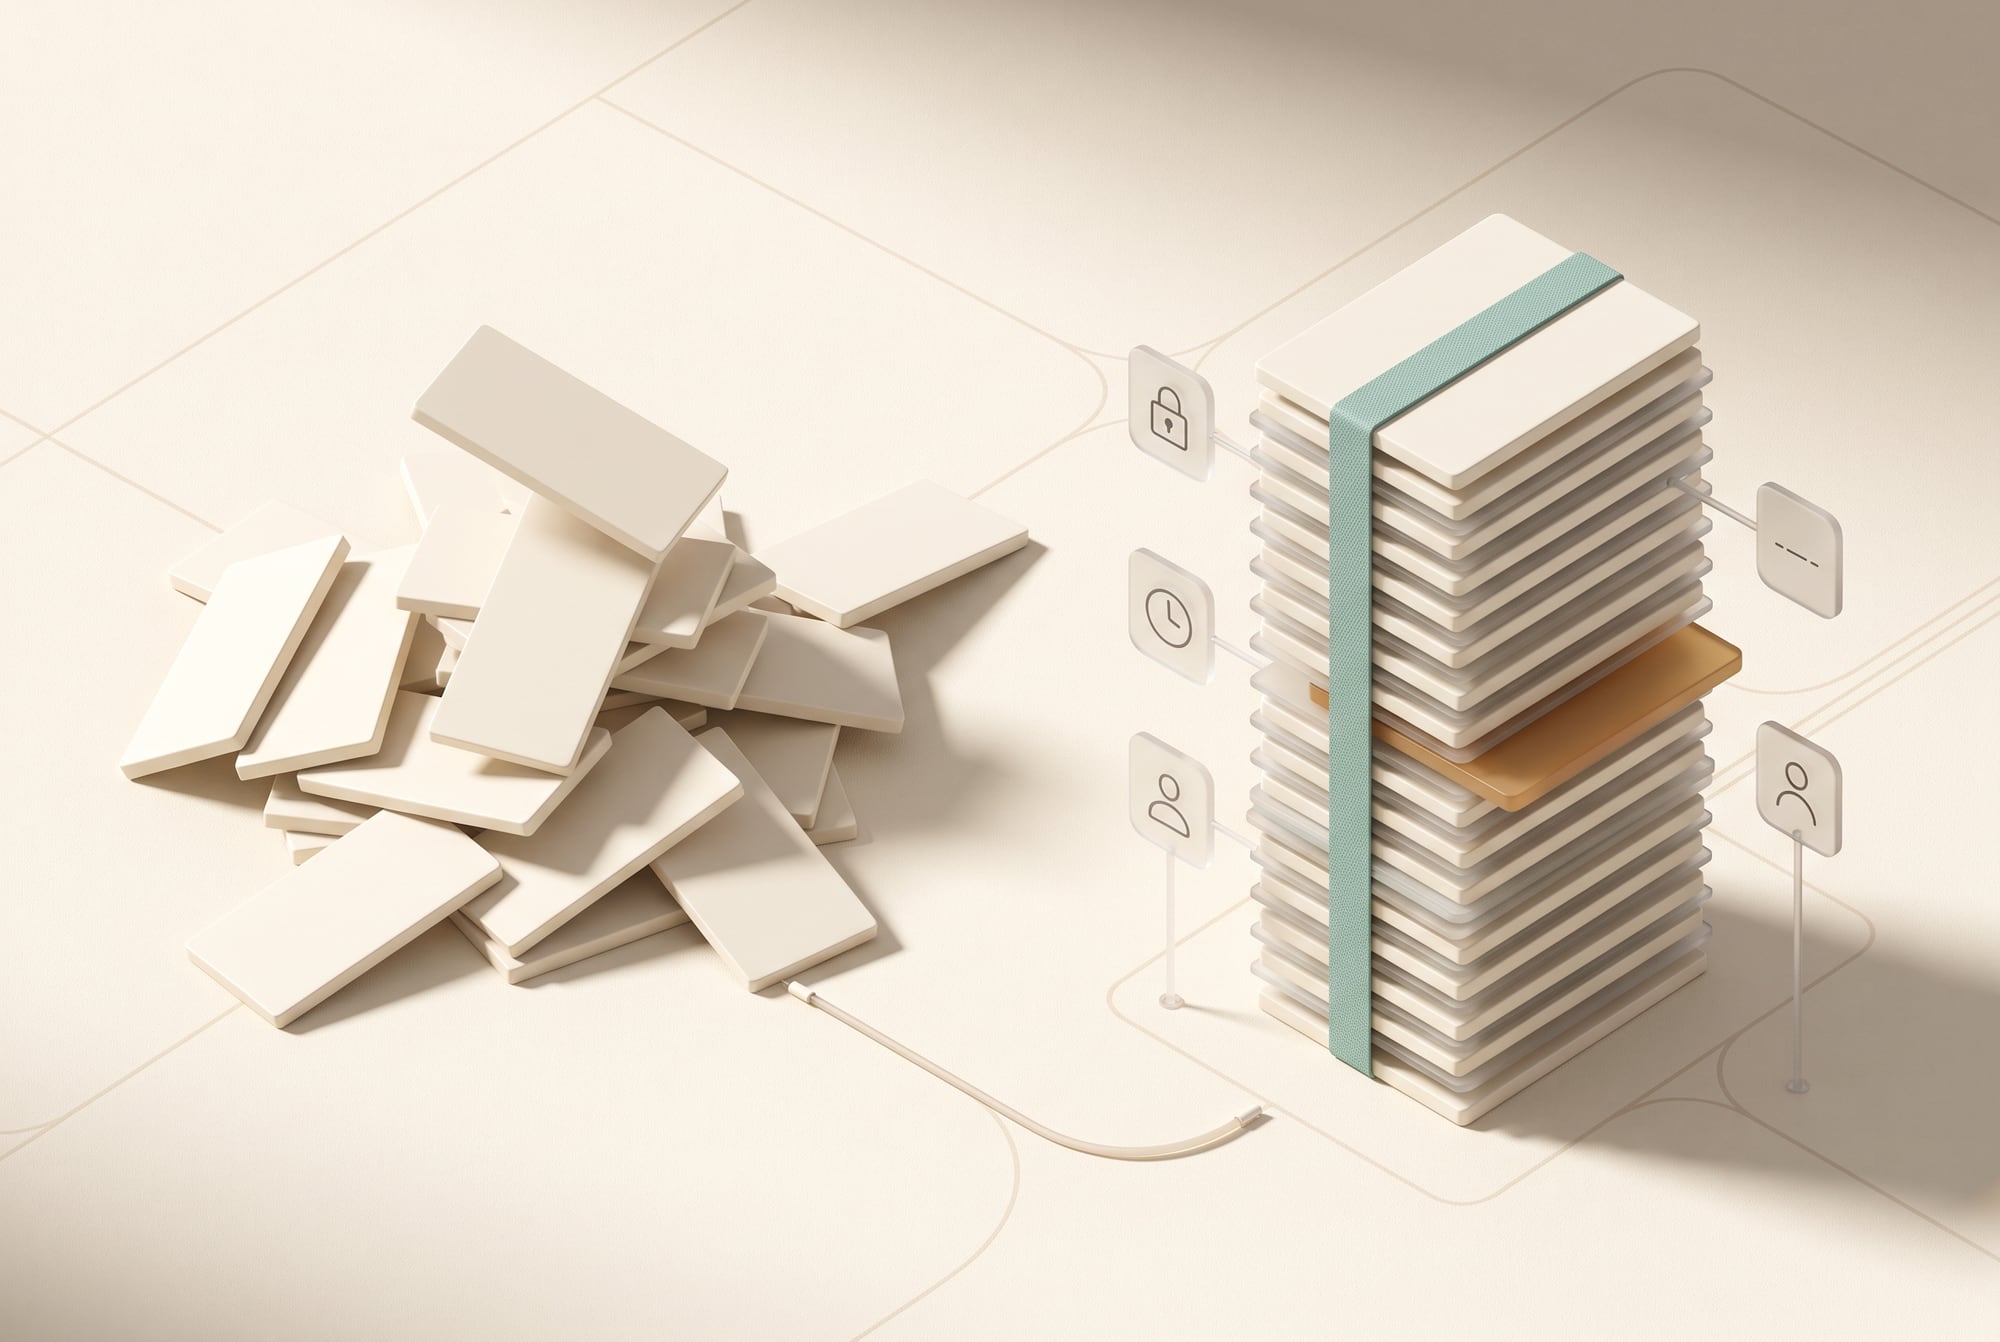
사실, 정책, 예시, 의견을 구분하십시오. 사실은 기간 시스템에서 와야 하고, 정책에는 승인자가 있어야 합니다. 예시는 패턴을 가르치는 데 쓰지만 규칙은 아니며, 의견에는 의견이라는 표시를 붙여야 합니다. 시스템은 출처를 밝히고 날짜를 보여 주어 사용자가 확인할 수 있게 해야 합니다.
개발팀 참고 · 기술 세부 사항
Content Lifecycle(Draft → Review → Approved → Deprecated)을 만들고, Owner에게 Reminder를 보냅니다. Knowledge 관리는 계속 이어지는 운영 업무이며, 한 번으로 끝나는 Migration 프로젝트처럼 다룰 수 없습니다.
5. 거래할 때마다 좋아지는 피드백 플라이휠(Feedback Flywheel) 만들기
사람이 AI의 결과물을 고쳤다면 최종본만 남기지 마십시오. 무엇을 고쳤는지, 어떤 유형의 오류였는지, 왜 고쳤는지를 기록하고, 이를 고객군과 성과에 연결하십시오. 수정한 메시지로 거래가 성사됐다거나, 고친 답변 덕분에 같은 문의가 줄었다는 식입니다. 이 데이터로 프롬프트, 규칙, 지식, 평가 기준을 다듬습니다.
피드백을 전부 자동으로 학습에 넣어서는 안 됩니다. 사람이 잘못 고쳤을 수도 있고, 특수한 경우였을 수도 있습니다. 기준 데이터(Golden Data)로 쓸 것은 표본을 뽑아 검토하고 승인해야 합니다. 품질이 높고 다양한 피드백을 골라, 한 사용자 집단에서 오는 편향을 줄이십시오.
6. 권한, 품질, 신뢰도 해자의 일부입니다
개발팀 참고 · 기술 세부 사항
Consent가 없거나 유출 위험 때문에 쓸 수 없는 데이터는 자산이 아닙니다. Purpose Limitation, Retention, Masking, 역할별 Access를 정합니다. Operation, Analytics, Model Improvement용 데이터를 분리하고, 권한 하나가 모든 목적을 포괄한다고 가정하지 않습니다.
주요 항목에는 완전성, 최신성, 정확성 같은 기준을 담은 데이터 품질 SLA(서비스 수준 협약)를 만들고, 기준에 어긋났을 때 책임질 사람을 정하십시오. 모니터링은 고객의 행동 패턴은 바뀌었는데 규칙은 그대로인 경우 같은 변화(Drift)를 잡아내야 합니다. 관련 규정에 따라 고객이 자기 데이터를 고칠 수 있는 길도 열어 두어야 합니다.
개발팀 참고 · 기술 세부 사항
Export와 Portability를 확보하고, Knowledge를 한 Vendor에 묶어 두지 않습니다. Source, Metadata, Evaluation을 옮길 수 있는 형식으로 보관해, Data Moat가 빠져나올 수 없는 서비스 안에 갇히지 않고 회사에 남게 합니다.
7. 갈 곳 없는 데이터 프로젝트를 피하고 데이터를 비즈니스 성과로 바꾸기
- 비용 절감: 좋은 지식 기반이 있으면 자동 해결률이 높아지고 검토가 줄어듭니다.
- 매출 증대: 행동 데이터와 성과 데이터를 합치면 알맞은 제안과 타이밍을 추천할 수 있습니다.
- 상품 개발: 예외 패턴을 보면 아직 아무도 풀지 못한 문제가 드러납니다.
- 전환 비용(Switching Cost) 높이기: 투명하게 알리고 동의를 받은 상태에서, 고객마다 그 고객의 데이터로 결과가 좋아지게 합니다.
- 위험 줄이기: 데이터 계보와 근거 자료가 감사에 대응하고 결정을 설명하는 데 도움이 됩니다.
개발팀 참고 · 기술 지표
모든 Data Initiative에는 Value Hypothesis와 Metric이 있어야 합니다. 검색 시간 40% 단축, First-contact Resolution 15포인트 향상, Conversion을 높이는 Lead Score 구축 같은 것입니다. 가져온 파일 수나 Database 크기를 가치의 대용으로 쓰지 마십시오.
8. 18개월 데이터 해자 구축 로드맵
개발팀 참고 · 시스템 구조
1~3개월 차: Use Case를 고르고, 핵심 데이터의 Inventory를 만들고, Owner를 지정하고, 품질을 측정합니다. 4~6개월 차: Lineage를 갖춘 Knowledge Layer를 만들고 첫 Workflow를 테스트합니다. 7~12개월 차: Feedback을 Outcome과 연결하고 Golden Dataset과 Evaluation을 만듭니다. 13~18개월 차: 여러 제품으로 넓히고, Reusable Data Product를 만들며, 새로운 상품과 서비스의 기회를 평가합니다.
요약: 데이터 해자는 성과와 연결되고, 책임자와 사용 권한과 피드백 순환을 갖춘 고유한 데이터에서 생깁니다. 파일을 많이 쌓는다고 생기지는 않습니다. 회사는 중요한 결정에서 출발해 지식 계층을 만들고, 수정 내용을 체계적으로 기록해야 합니다. 그러면 모델이 바뀌어도 회사의 지식과 학습 체계가 계속 차이를 만들어 냅니다.
흩어진 파일을 시스템이 쓸 수 있는 자산으로 바꿉니다
회사에서 가장 값진 데이터는 대개 깔끔한 데이터베이스가 아닌 곳에 있습니다. 기술자가 손으로 쓴 작업 일지, 영업팀이 고객에게 보낸 이메일, 팀장이 혼자 보관하는 파일 같은 곳입니다. 이 지식의 주인은 저희가 아니라 회사의 팀입니다. DNA Maker는 데이터 목록 작업을 도와, 무엇이 어디에 있고 누가 책임지는지, 어떤 데이터가 어떤 결정에 실제로 쓰일 수 있는지, 어떤 데이터는 아직 품질이 모자라 쓸 수 없는지 보이게 합니다. 이 단계에서 회사가 생각보다 좋은 자료를 많이 갖고 있지만 아직 기계가 읽을 수 없는 형태로 남아 있다는 사실이 드러나는 경우가 많습니다.
회사 팀과 함께 하는 작업
그다음 메타데이터와 접근 권한이 분명한 저장 구조를 설계하고, 새 데이터가 꾸준히 들어오도록 데이터 파이프라인을 만들고, 출처를 밝히며 답하는 RAG(검색 증강 생성) 검색 계층을 구축합니다. 그래야 직원이 답을 믿을 수 있고 직접 확인할 수도 있습니다. 데이터를 실제 강점으로 바꾸는 것은 피드백 순환입니다. 누군가 답변을 고치거나 작업을 마무리할 때마다 시스템이 그 내용을 다시 저장소에 담아야 합니다. 문서 보관함이 너무 찾기 어려워서 직원들이 차라리 서로 전화로 묻는다면, 그 보관함에서 시작하면 됩니다.
SOFTWARE ENGINEERING GLOSSARY
소프트웨어 엔지니어링 용어집
사내 데이터를 시스템이 쓸 수 있게 만드는 일을 이야기할 때 쓰는 용어입니다.
| 용어 | 의미 | 쉬운 예시 | 개발팀에 물어봐야 할 질문 |
|---|---|---|---|
| Metadata | 누가 언제 만들었고 어느 제품에 해당하는지처럼 데이터를 설명해, 검색하고 걸러 낼 수 있게 하는 데이터 | 이 매뉴얼이 어느 기계 모델에 해당하고 언제 마지막으로 고쳤는지 기록합니다. | 메타데이터가 없으면 시스템은 어떤 문서가 아직 유효한지 어떻게 압니까? |
| RAG | AI가 일반 지식으로 짐작하는 대신 회사의 실제 데이터를 찾아 답을 구성하게 하는 방법 | 기계 설정 방법을 물으면 시스템이 최신 매뉴얼에서 내용을 가져와 답합니다. | 답변은 어떤 문서의 어느 버전을 근거로 하고, 정보를 찾지 못하면 시스템은 뭐라고 답합니까? |
| Citation | 답변의 출처를 밝혀 나중에 확인할 수 있게 하는 것 | 답변에 참고한 매뉴얼 페이지 링크가 붙어 있습니다. | 사용자가 답변을 믿지 못하면 어떻게 더 확인할 수 있습니까? |
| Data Pipeline | 데이터가 원천에서 시스템이 쓰는 곳까지 흘러가는 경로와, 그 과정의 정제 작업 | 매일 밤 그날의 작업 일지를 지식 저장소로 가져옵니다. | 원천 데이터의 형식이 바뀌면 시스템이 알아채고 알림을 보냅니까? |
| Data Retention | 데이터를 얼마나 오래 보관하고 언제 삭제할지 정한 정책 | 고객 대화를 법과 회사 정책이 정한 기간 동안 보관합니다. | 무엇을 얼마나 오래 보관하고, 이 정책은 누가 승인했습니까? |