
- ความฉลาดพื้นฐานของ AI ใครก็ซื้อได้เท่ากัน สิ่งที่คู่แข่งลอกไม่ได้คือข้อมูลจากการทำงานจริงของคุณ
- ข้อมูลที่มีค่าที่สุดมักไม่ได้อยู่ในฐานข้อมูลสวย ๆ แต่อยู่ในใบงาน อีเมล และไฟล์ที่กระจัดกระจาย
- เริ่มจากทำบัญชีว่าอะไรอยู่ที่ไหนและใครเป็นเจ้าของ ก่อนจะคิดเรื่องเทคโนโลยี
1. เมื่อความฉลาดพื้นฐานซื้อได้ ความรู้เฉพาะจะมีค่าขึ้น
ถ้าคุณกับคู่แข่งใช้ AI ตัวเดียวกัน ความฉลาดที่ได้มาก็เท่ากัน สิ่งเดียวที่เขาลอกไม่ได้คือสิ่งที่เกิดขึ้นในบริษัทคุณเท่านั้น เช่น ลูกค้าเคยบ่นอะไร งานไหนเคยพัง และช่างแก้ด้วยวิธีไหน นั่นคือของที่เงินซื้อไม่ได้
โมเดลทั่วไปเขียน สรุป และวิเคราะห์ได้ดีขึ้นเรื่อย ๆ แต่ไม่รู้ว่าบริษัทกำหนดลูกค้าคุณภาพอย่างไร เงื่อนไขใดทำให้โครงการล่าช้า หรือคำตอบแบบไหนรักษาลูกค้าได้ ข้อมูลเหล่านี้เกิดจากการทำงานจริงและไม่อยู่ในอินเทอร์เน็ต
Data Moat ไม่ได้หมายถึงมีข้อมูลจำนวนมาก แต่คือมีข้อมูลที่เชื่อม Outcome, คุณภาพดี ใช้ได้อย่างถูกสิทธิ์ และถูกป้อนกลับเข้าสู่การตัดสินใจ คู่แข่งอาจลอกฟีเจอร์ AI ได้ในไม่กี่เดือน แต่ลอกประวัติ Feedback และความเข้าใจเฉพาะที่สะสมหลายปีได้ยาก
2. ข้อมูลห้าประเภทที่สร้างความแตกต่าง
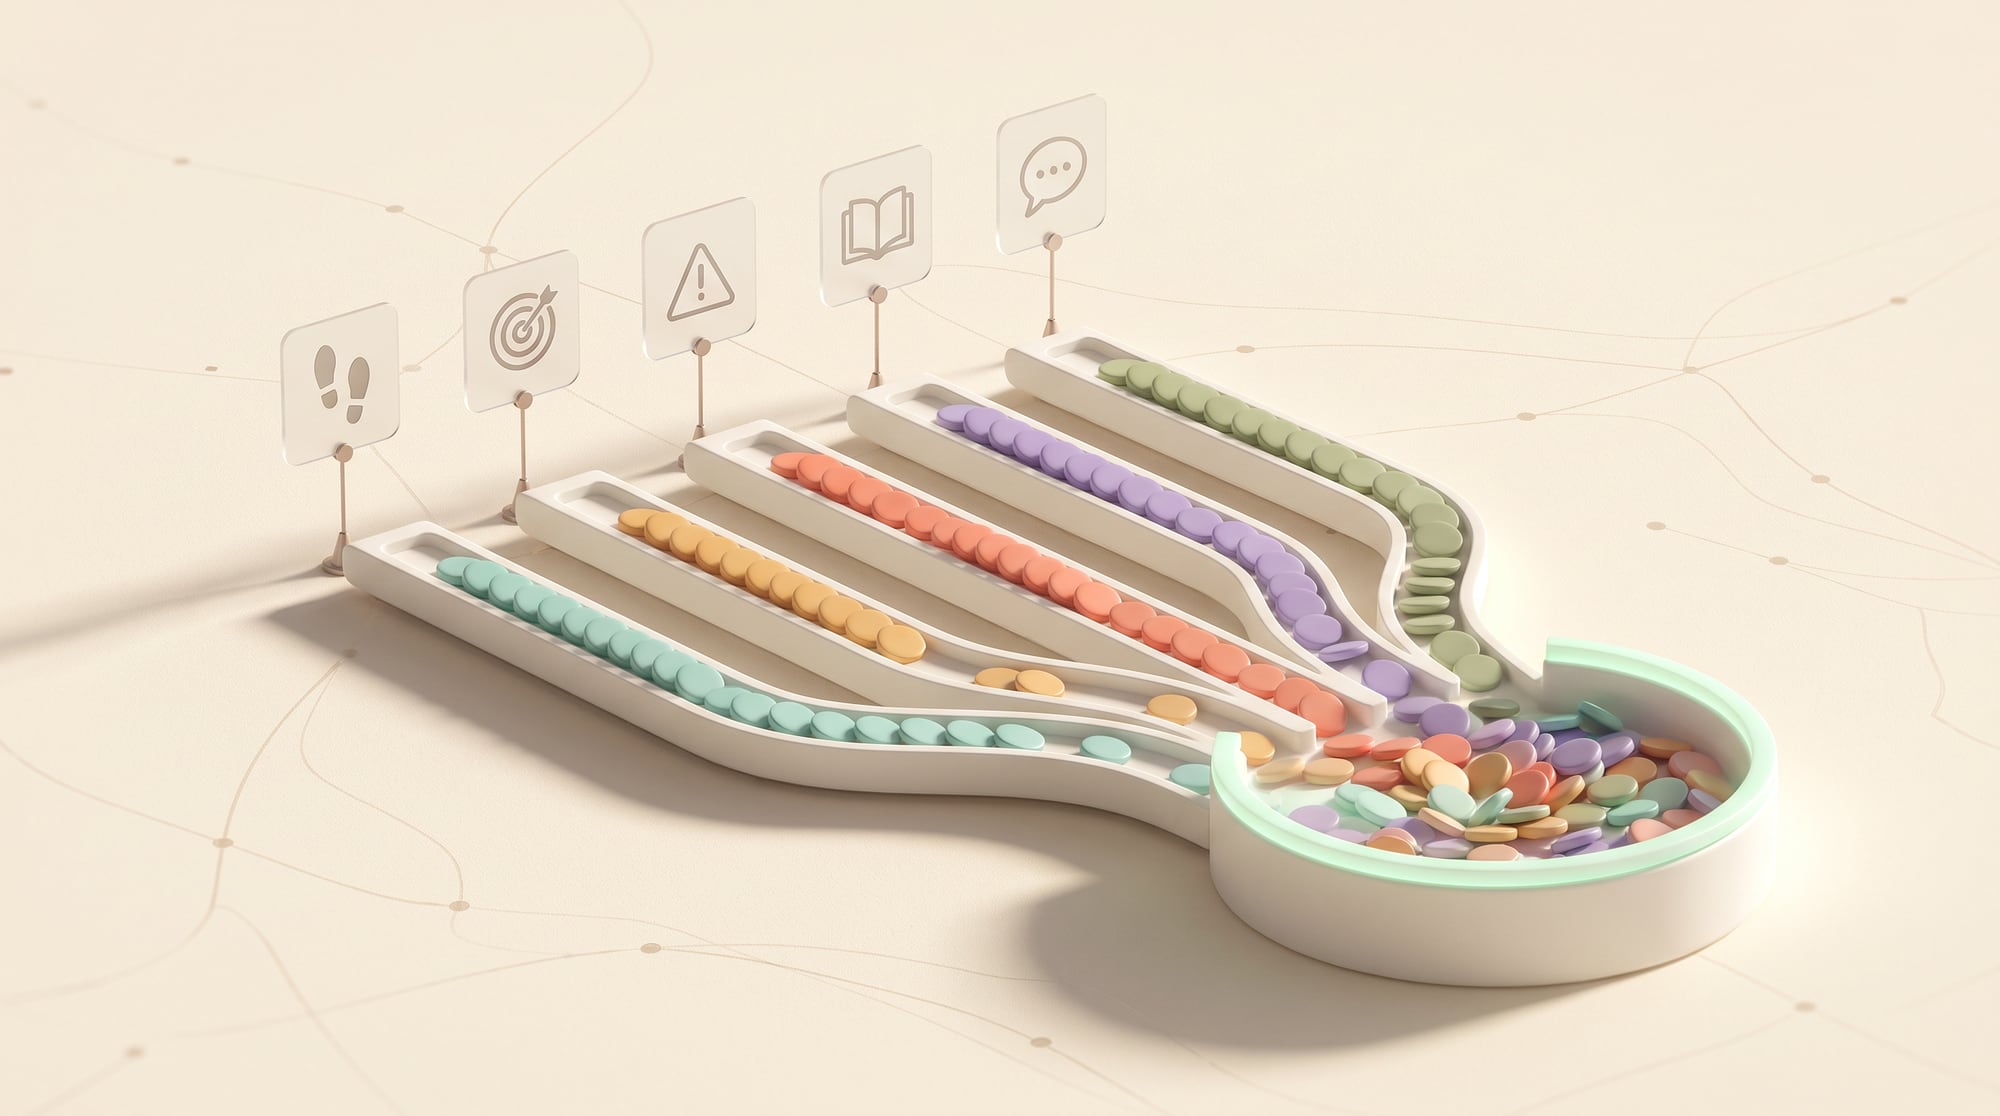
ไม่ใช่ข้อมูลทุกชนิดจะมีค่าเท่ากัน ข้อมูลที่ใครก็หาได้จากอินเทอร์เน็ตแทบไม่ช่วยอะไร ส่วนบันทึกว่าเคสแบบไหนจบอย่างไรในบริษัทคุณ คือของหายาก
- Behavioral Data: ลูกค้าทำอะไรจริง ไม่ใช่เพียงบอกว่าชอบอะไร
- Outcome Data: วิธีแก้ใดนำไปสู่ยอดขาย การใช้ซ้ำ คุณภาพ หรือการประหยัด
- Exception Data: กรณีใดออกนอกมาตรฐานและผู้เชี่ยวชาญแก้อย่างไร
- Domain Knowledge: กติกา เหตุผล และ Trade-off ที่คนในอุตสาหกรรมรู้
- Feedback Data: การแก้ Draft การปฏิเสธ และเหตุผลที่ผลลัพธ์ไม่เหมาะ
เอกสาร Marketing จำนวนมากอาจมีค่าน้อยกว่าประวัติข้อโต้แย้งการขายที่เชื่อมกับผลลัพธ์ ข้อมูลมีค่าเมื่อช่วยตอบคำถามตัดสินใจและปรับ Workflow ไม่ใช่เพราะมีขนาดใหญ่
3. ทำ Data Inventory แบบเจ้าของกิจการ
เริ่มจาก Use Case ไม่ใช่สำรวจทุกฐานข้อมูล เลือกการตัดสินใจสำคัญ เช่น จัดลำดับ Lead หรือแนะนำสินค้าทดแทน แล้วระบุข้อมูลที่ใช้ แหล่ง เจ้าของ คุณภาพ สิทธิ์ และ Outcome ทำ Data Lineage ว่าตัวเลขหรือคำตอบมาจากไหนและอัปเดตเมื่อไร
| ข้อมูล | เจ้าของ | คุณภาพ | สิทธิ์ใช้ AI | เชื่อม Outcome |
|---|---|---|---|---|
| ประวัติลูกค้า | Sales Ops | ช่องสำคัญครบ 85% | ภายในเท่านั้น | Conversion/Retention |
| Ticket | Support | ข้อความดี หมวดไม่สม่ำเสมอ | ต้อง Mask PII | Resolution/CSAT |
| คู่มือ | Product | บางส่วนหมดอายุ | ใช้ได้ตามกลุ่ม | Answer Quality |
กำหนด Tier: Critical, Useful และ Archive อย่าทำความสะอาดทุกอย่างพร้อมกัน ลงทุนกับข้อมูลที่ Workflow แรกต้องใช้และสร้างมาตรฐานที่ขยายได้ ข้อมูลที่ไม่มีเจ้าของไม่ควรถูกใช้เป็น Ground Truth
4. เปลี่ยนไฟล์กระจัดกระจายเป็น Knowledge Layer
สำหรับทีมพัฒนา · โครงสร้างระบบ
Knowledge Layer ต้องมีเนื้อหาที่อนุมัติ Metadata, Version, Effective Date, Owner และ Access Policy การนำไฟล์ทั้งหมดเข้า Vector Database โดยไม่จัดสถานะทำให้ AI อาจหยิบราคาเก่าและนโยบายที่ยกเลิก ควรกำหนดลำดับแหล่งและวิธีตอบเมื่อข้อมูลขัดกัน
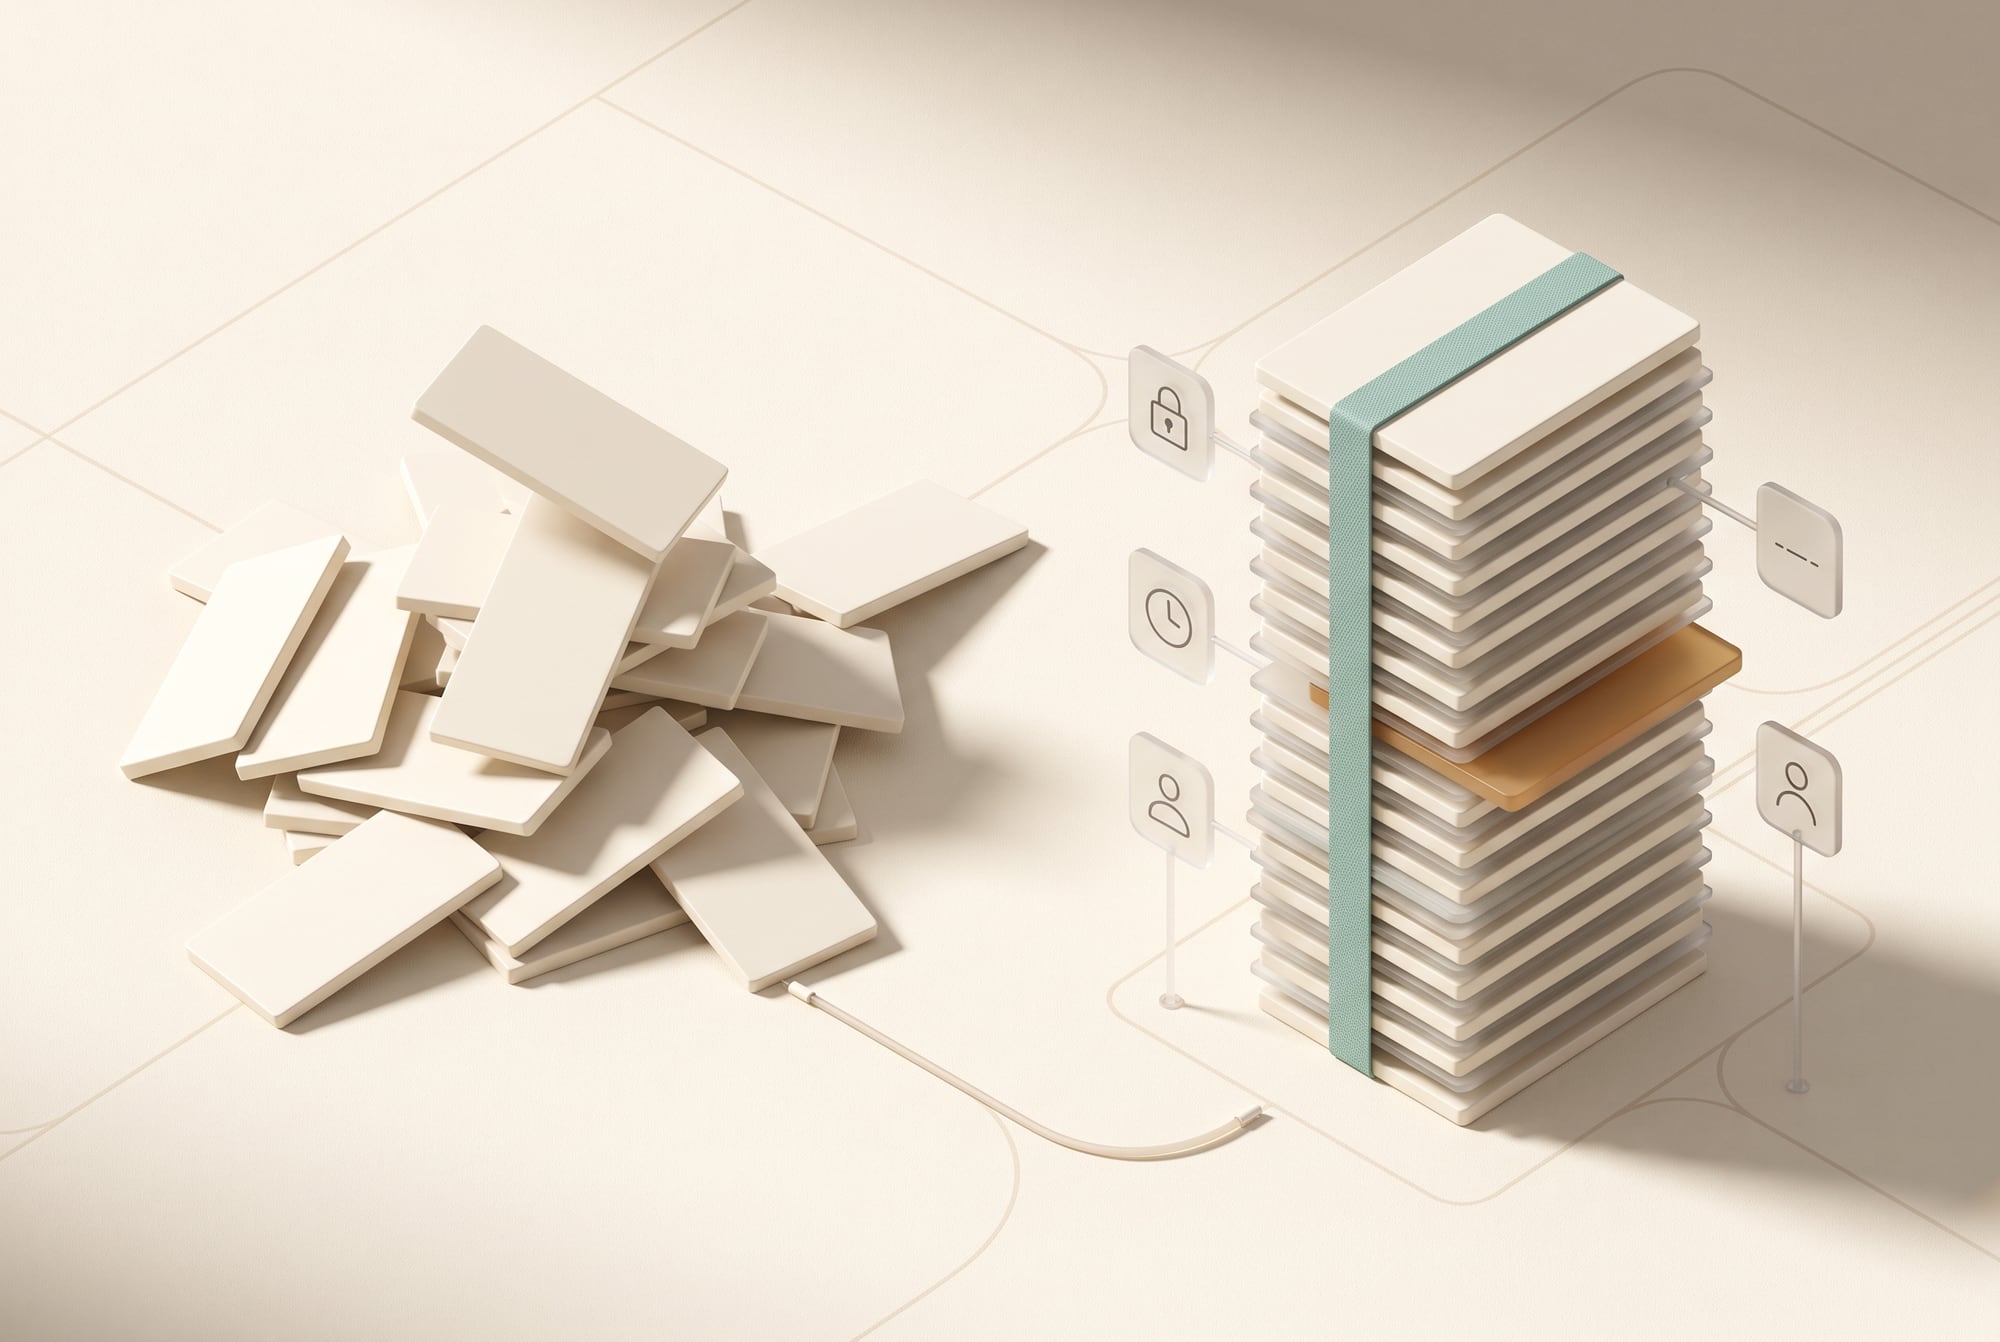
แยก Fact, Policy, Example และ Opinion Fact ต้องมาจากระบบหลัก Policy มีผู้อนุมัติ Example ใช้สอนรูปแบบแต่ไม่ใช่กฎ Opinion ควรถูกระบุว่าเป็นความเห็น ระบบต้องอ้างแหล่งและแสดงวันที่เพื่อให้ผู้ใช้ตรวจได้
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
สร้าง Content Lifecycle: Draft → Review → Approved → Deprecated พร้อม Reminder เจ้าของ การดูแล Knowledge เป็นงานปฏิบัติการต่อเนื่อง ไม่ใช่โครงการ Migration ครั้งเดียว
5. สร้าง Feedback Flywheel ที่ดีขึ้นทุกธุรกรรม
เมื่อคนแก้ผล AI อย่าเก็บเพียงเวอร์ชันสุดท้าย เก็บสิ่งที่แก้ ประเภทข้อผิดพลาด และเหตุผล เชื่อมกับ Segment และ Outcome เช่น ข้อความที่แก้แล้วปิดการขายหรือคำตอบที่ลด Ticket ซ้ำ ข้อมูลนี้ใช้ปรับ Prompt, Rule, Knowledge และ Evaluation
Feedback ไม่ควรถูกนำไปฝึกโดยอัตโนมัติทั้งหมด เพราะคนอาจแก้ไม่ถูกหรือเป็นกรณีพิเศษ ต้องมี Sampling และ Approval สำหรับ Golden Data เลือก Feedback ที่มีคุณภาพสูงและหลากหลาย ลด Bias จากผู้ใช้กลุ่มเดียว
6. สิทธิ์ คุณภาพ และความไว้วางใจคือส่วนของ Moat
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
ข้อมูลที่ใช้ไม่ได้เพราะไม่มี Consent หรือเสี่ยงรั่วไม่ใช่สินทรัพย์ กำหนด Purpose Limitation, Retention, Masking และ Access ตามบทบาท แยกข้อมูลสำหรับ Operation, Analytics และ Model Improvement ไม่สมมติว่าสิทธิ์หนึ่งครอบคลุมทุกวัตถุประสงค์
สร้าง Data Quality SLA สำหรับ Field สำคัญ เช่น ความครบ ความสด และความถูกต้อง พร้อมผู้รับผิดชอบเมื่อผิด Monitoring ต้องเห็น Drift เช่น Pattern ลูกค้าเปลี่ยนแต่ Rule ยังเดิม และต้องมีทางให้ลูกค้าแก้ข้อมูลของตนตามข้อกำหนดที่เกี่ยวข้อง
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
ควรมี Export และ Portability ไม่ผูก Knowledge กับ Vendor เดียว เก็บ Source, Metadata และ Evaluation ในรูปแบบที่ย้ายได้ เพื่อให้ Data Moat อยู่กับบริษัท ไม่อยู่ในบริการที่เปลี่ยนไม่ได้
7. เปลี่ยนข้อมูลเป็นผลธุรกิจ ไม่ใช่โครงการ Data ที่ไม่มีปลายทาง
- ลดต้นทุน: Knowledge ที่ดีทำให้ Auto Resolution สูงและ Review น้อย
- เพิ่มรายได้: Behavioral + Outcome ช่วยแนะนำข้อเสนอและ Timing
- สร้างสินค้า: Exception Pattern เปิดเผยปัญหาที่ยังไม่มีใครแก้
- เพิ่ม Switching Cost: ผลลัพธ์ดีขึ้นตามข้อมูลของลูกค้าโดยมีความโปร่งใสและสิทธิ์
- ลดความเสี่ยง: Lineage และ Evidence ช่วย Audit และอธิบายการตัดสินใจ
สำหรับทีมพัฒนา · ตัวชี้วัดเชิงเทคนิค
ทุก Data Initiative ควรมี Value Hypothesis และ Metric เช่น ลดเวลาค้น 40 เปอร์เซ็นต์ เพิ่ม First-contact Resolution 15 จุด หรือสร้าง Lead Score ที่เพิ่ม Conversion อย่าใช้จำนวนไฟล์ที่นำเข้าหรือขนาด Database เป็นตัวแทนคุณค่า
8. Roadmap 18 เดือนสร้าง Data Moat
สำหรับทีมพัฒนา · โครงสร้างระบบ
เดือน 1–3: เลือก Use Case, Inventory ข้อมูลสำคัญ, ตั้ง Owner และวัดคุณภาพ เดือน 4–6: สร้าง Knowledge Layer กับ Lineage และทดสอบ Workflow แรก เดือน 7–12: เชื่อม Feedback กับ Outcome สร้าง Golden Dataset และ Evaluation เดือน 13–18: ขยายข้ามผลิตภัณฑ์ สร้าง Reusable Data Product และประเมินโอกาสข้อเสนอใหม่
สรุป: Data Moat เกิดจากข้อมูลเฉพาะที่เชื่อมกับผลลัพธ์ มีเจ้าของ สิทธิ์ และวงจร Feedback ไม่ได้เกิดจากการสะสมไฟล์ให้มาก บริษัทควรเริ่มที่การตัดสินใจสำคัญ สร้าง Knowledge Layer และเก็บการแก้ไขอย่างมีโครงสร้าง เมื่อโมเดลเปลี่ยน ความรู้และระบบเรียนรู้ของบริษัทยังคงสร้างความต่างต่อได้
เปลี่ยนไฟล์ที่กระจัดกระจายให้กลายเป็นสินทรัพย์ที่ระบบใช้ได้
ข้อมูลที่มีค่าที่สุดของบริษัทมักไม่ได้อยู่ในฐานข้อมูลสวยงาม แต่อยู่ในใบงานที่ช่างเขียนมือ อีเมลที่ฝ่ายขายตอบลูกค้า และไฟล์ที่หัวหน้าเก็บไว้เอง เจ้าของความรู้เหล่านี้คือทีมของคุณ ไม่ใช่เรา หน้าที่ของ DNA Maker คือช่วยทำ Data Inventory ให้เห็นว่าอะไรอยู่ที่ไหน ใครเป็นเจ้าของ ข้อมูลชุดใดใช้ตัดสินใจอะไรได้จริง และชุดใดยังขาดคุณภาพจนใช้ไม่ได้ ขั้นนี้มักเปิดเผยว่าบริษัทมีของดีมากกว่าที่คิด แต่ยังอยู่ในรูปที่เครื่องอ่านไม่ได้
งานที่เราลงมือทำร่วมกับทีมของคุณ
จากนั้นเราจึงออกแบบระบบจัดเก็บที่มี Metadata และสิทธิ์เข้าถึงชัดเจน ทำ Data Pipeline ให้ข้อมูลใหม่ไหลเข้าอย่างสม่ำเสมอ และสร้างชั้นค้นหาแบบ RAG ที่ตอบคำถามพร้อมอ้างอิงแหล่งที่มา เพื่อให้พนักงานเชื่อคำตอบได้และตรวจย้อนได้ สิ่งที่ทำให้ข้อมูลกลายเป็นข้อได้เปรียบจริงคือวงจรป้อนกลับ ทุกครั้งที่มีคนแก้คำตอบหรือปิดงาน ระบบต้องเก็บสิ่งนั้นกลับเข้าคลัง ถ้าคุณมีคลังเอกสารที่ค้นหายากจนพนักงานเลือกจะโทรถามกันเอง นั่นคือจุดตั้งต้นที่เราช่วยได้
SOFTWARE ENGINEERING GLOSSARY
คลังคำศัพท์การพัฒนาซอฟต์แวร์
คำศัพท์กลุ่มนี้ใช้คุยเรื่องการเปลี่ยนข้อมูลภายในให้ระบบใช้งานได้
| คำศัพท์ | คืออะไร | ตัวอย่างที่เข้าใจง่าย | คำถามที่ผู้บริหารควรถามทีมพัฒนา |
|---|---|---|---|
| Metadata | ข้อมูลกำกับข้อมูล เช่น ใครสร้าง เมื่อใด ใช้กับสินค้าใด ทำให้ค้นหาและกรองได้ | ระบุว่าคู่มือนี้ใช้กับเครื่องรุ่นใดและปรับปรุงล่าสุดเมื่อใด | ถ้าไม่มี Metadata ระบบจะรู้ได้อย่างไรว่าเอกสารใดใช้ได้อยู่? |
| RAG | วิธีให้ AI ค้นข้อมูลจริงของบริษัทมาประกอบคำตอบ แทนการเดาจากความรู้ทั่วไป | ถามวิธีตั้งเครื่อง แล้วระบบดึงจากคู่มือฉบับล่าสุดมาตอบ | คำตอบอ้างอิงเอกสารฉบับใด และถ้าไม่พบข้อมูลระบบตอบว่าอย่างไร? |
| Citation | การอ้างอิงแหล่งที่มาของคำตอบเพื่อให้ตรวจสอบย้อนได้ | คำตอบแนบลิงก์ไปยังหน้าคู่มือที่ใช้ | ถ้าผู้ใช้ไม่เชื่อคำตอบ เขาตรวจสอบต่อได้อย่างไร? |
| Data Pipeline | เส้นทางที่ข้อมูลไหลจากต้นทางไปยังที่ที่ระบบใช้งาน พร้อมการทำความสะอาด | ดึงใบงานประจำวันเข้าคลังความรู้ทุกคืน | ถ้าข้อมูลต้นทางเปลี่ยนรูปแบบ ระบบรู้และแจ้งเตือนหรือไม่? |
| Data Retention | นโยบายว่าเก็บข้อมูลไว้นานเท่าใดและลบเมื่อใด | เก็บบทสนทนาลูกค้าตามระยะเวลาที่กฎหมายและนโยบายกำหนด | เราเก็บอะไรไว้นานแค่ไหน และใครอนุมัตินโยบายนี้? |