
- システムダウンには、アクセスをさばききれなくなる、データが消える、誰も気づかないまま壊れる、の3種類があり、それぞれ備え方が違います。
- 一度も復元を試したことのないバックアップは、まだバックアップがあるとは言えません。
- 経営者が自分で答えるべき質問は2つです。システムがどのくらいの時間止まってもよいかと、データを何時間分までさかのぼって失ってもよいかです。技術チームはこの答えに沿って設計します。
企業が経験する3種類のシステムダウン
キャンペーン当日の午後8時ちょうど、数千人の顧客が一斉にサイトにアクセスします。ページは読み込み中のまま止まり、マーケティングチームがチャットグループで何が起きているのかと尋ねても、誰も答えられません。システムダウンと聞いて多くの人が思い浮かべるのはこの光景です。ただ、より大きな損害を出すダウンは、たいていもっと静かに起きます。
1つ目は、アクセスをさばききれなくなるケースです。普段の利用者なら余裕で受け止められるシステムでも、これまでにない数の人が同時に入ってくると、使えなくなるほど遅くなります。詰まるのはたいていデータベースで、Webサーバーを増やしても解決しません。
2つ目は、データが消えるケースです。原因は、社員が誤って別のテーブルを削除することから、サーバーの故障、すべてのファイルを暗号化するランサムウェアまでさまざまです。ランサムウェアの場合、バックアップが常に本番システムにつながっていると、被害はバックアップにまで広がります。
3つ目は、誰も気づかないまま壊れるケースです。ページは開けるのに、重要な処理の一部が止まっています。顧客の支払いは完了したのに注文が記録されない、確認メールが送られない、といった状態です。このケースが最も高くつきます。誰かが気づくまでに何時間もたち、1件ずつ追いかけて直す必要があるからです。
バイブコーディングで作ったアプリには、画面はすべてそろっています。けれども、監視の仕組みもバックアップもなく、午前2時に起こされる担当者もいません。誰もAIにそれを作るよう指示しておらず、デモの段階では欠けていることに誰も気づかなかったからです。
備えの4つの層と、見せてもらうべき証拠
金曜の夜に備えができているレストランは、厨房が1時間に何皿出せるかを知っています。店の様子を見ている人がいて、ガスが切れたときの予備のコンロがあり、停電したら誰が判断するかを全員が知っています。オンラインのシステムにも同じ4つが必要です。どれにも、経営者が技術を理解していなくても見せてもらえる証拠があります。
| 備えの層 | 経営者の質問 | 見せてもらうべき証拠 |
|---|---|---|
| 処理能力 | 同時に何人のユーザーまでなら遅くならずに受け止められるか | 直近の負荷テストの結果(数値とテスト日つき) |
| 異常の把握 | 今システムに異常が起きたら、先に気づくのは顧客か、自社か | 監視画面と、設定済みのアラートの一覧 |
| 復旧 | 今データベースが消えたら、いつの時点のデータまで取り戻せて、何時間かかるか | 直近の復元訓練の記録 |
| 障害対応 | 土曜の夜にシステムが止まったら、誰が判断し、誰が顧客に知らせるか | 運用手順書(Runbook)と、実在の担当者名が入った当番表 |
復旧の層では、経営者が2つの質問に答える必要があります。1つ目は、事業が許容できない損害を受けるまでに、システムがどのくらい止まっていてよいかです。エンジニアはこれをRTO(目標復旧時間)と呼びます。2つ目は、どのくらい前までのデータなら失ってもよいかで、これをRPO(目標復旧時点)と呼びます。1分間に何十件も注文を受ける店では、RPOが1日では困ります。1日分の注文がすべて消えるのと同じだからです。一方、月に1回更新する会社のWebサイトなら、1日でも十分です。この2つの値を短くするほど費用は上がるので、数字は事業の側から決めるべきです。
昔から使われているバックアップの原則が3-2-1です。コピーを3つ作り、2種類の媒体に保存し、そのうち1つを社外に置きます。ランサムウェアに襲われたときに生き残るのは、社外にあって本番システムにつながっていないコピーです。
開発チーム向け · 技術的な詳細
注文と決済の経路にSLOを設定し、エラー率、P95のレイテンシ、決済成功率など、顧客が実際に体験する症状をもとにアラートを出します。数分ごとに注文を模擬実行する合成監視(Synthetic Check)を用意し、バックアップはポイントインタイム方式にして、自動のリストアテストと組み合わせます。負荷テストは想定ピークを上回る水準で行い、注文はキュー経由で受け付けて、データベースが遅くなっても注文が失われないようにします。
架空のケース
化粧品ブランドと、キャンペーン開始からの25分間
自社サイトで販売している化粧品ブランドが、午後8時にキャンペーンを始めました。8時4分にサイトが遅くなり始め、8時10分には決済ページが止まりました。一部の顧客は代金が引き落とされたのに、注文番号を受け取れませんでした。銀行からの決済確認の通知が、システムが応答しない間に届いたためです。チームが問題に気づいたのは8時25分、SNSページのコメントからで、サーバーを再起動できたのは8時40分でした。翌朝、社員3人が銀行の引き落とし記録とシステムの注文を1件ずつ照らし合わせることになりました。
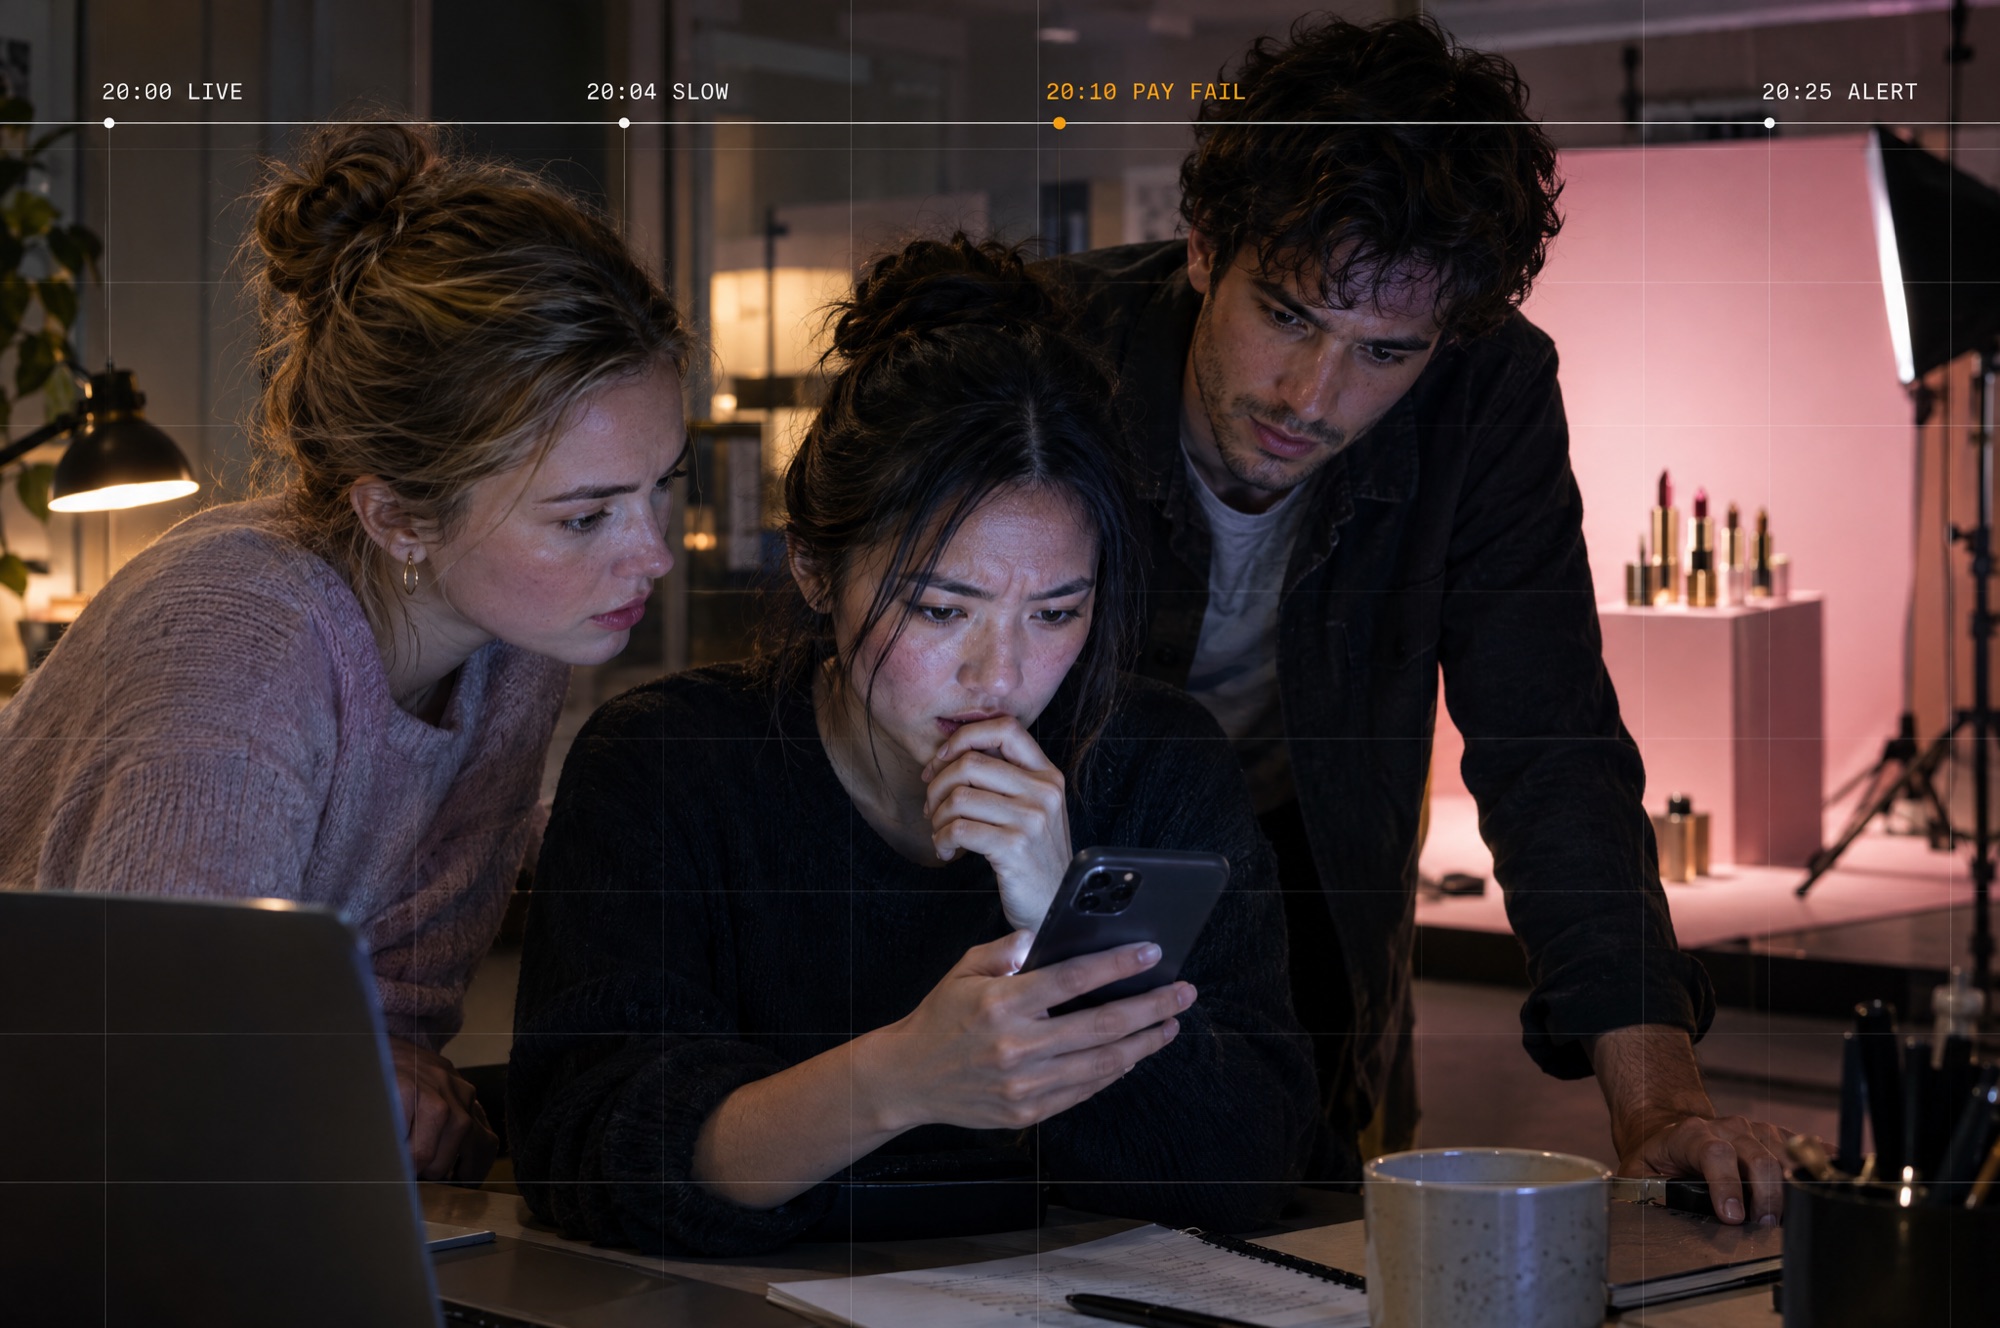
それぞれの層の備えがあれば何が変わったかを振り返ってみます。キャンペーンの1週間前に負荷テストをしていれば、データベースが詰まる箇所だとわかったはずです。決済成功率に結びつけたアラートがあれば、チームは2分以内に気づけました。注文を受け付けるキューは、システムが戻るまで銀行からの通知を保持できたでしょう。運用手順書に誰がSNSページで告知するかが書いてあれば、障害の最中に相談する必要もありませんでした。
四半期ごとに復元訓練をする
- 本番データベースの最新のバックアップを選びます。
- 本番システムとは別のサーバーに復元し、開始から使える状態になるまでの時間を計ります。
- バックアップに入っている最新の注文がいつ時点のものか、顧客数が本番システムと一致するか、ログインして注文を開けるかの3点を確認します。
- かかった時間と、失われたデータの期間を記録し、経営者が決めた値と比べます。
- つまずいた箇所を直し、次の訓練の日程を決めます。
証拠になるのは、日付、かかった時間、実施者の名前が入った訓練の記録です。訓練でよくある見落としは、データベースだけをバックアップしていて、商品画像のファイル、顧客がアップロードした書類、システムの設定は別の場所にあり、一度もバックアップされていなかったというものです。
事業に見合う備えはどのレベルか
マーケットプレイスや既製のネットショップ作成サービスで販売している店は、このことをほとんど考えなくて済みます。サービスの提供会社がすでに面倒を見ているからです。この記事が扱うのは、自社のシステムを持ち、どの層まで備えるかを自分で決めなければならない企業です。
使える考え方は、1時間あたりの損害額を見積もることです。ピーク時の1時間あたりの売上に、対応に追われるチームの人件費と、戻ってこなくなる顧客の分を加え、それを各層の備えにかかる費用と比べます。損害額が小さい企業でも、少なくとも復元を試したバックアップと基本的なアラートは用意すべきです。どちらも費用は高くなく、取り返しのつかない損害を防げるからです。
筋の通った投資の順番は、まずバックアップと復元訓練、次にお金が動く経路の監視です。その後、大きなキャンペーンの前に負荷テストを行い、運用手順書を書いて障害対応を訓練します。最後に、止まることが許されない事業向けに、自動で切り替わる予備のシステムを用意します。これをフェイルオーバー(Failover)と呼びます。
次の段階に進むべきタイミング
- ピーク時の1時間あたりの売上が、その層の備えにかかる費用を上回っている
- これまでシステムが受けた以上のアクセスが見込まれるキャンペーンがある
- チームより先に顧客が気づいた障害が過去にある
- サービス提供時間を定めた契約を法人顧客と結んでいる
投資した後に追うべき数字は、障害の発生からチームが気づくまでの時間、気づいてからシステムが戻るまでの時間、顧客が先に気づいた障害の件数、直近の復元訓練の結果です。監視を導入してもチームが気づくまでの時間が縮まらないなら、アラートがまだサーバーの数値に結びついていて、顧客が体験していることには結びついていないということです。サーバーを買い足す前に、そこを直してください。
次の大きなキャンペーンまでにシステムを備える
事業がどこまで停止を許容できるかを決めるのは、自社の経営層です。マーケティング部門はキャンペーンの予定を知っていて、カスタマーサービス部門はシステムに問題が起きたときに顧客が何を尋ねてくるかを知っています。DNA Makerはこの3部門から答えを集め、システムの目標に落とし込みます。止まってはいけない時間帯、注文から決済、注文確認までの監視すべき経路、障害時の判断の順序です。
私たちのチームはアーキテクチャを点検し、負荷テストとストレステストで詰まる箇所を探します。お金が動く経路には監視とアラートを設定し、バックアップの周期を決めて復元訓練を行い、災害復旧(DR)計画と運用手順書を社内のチームと一緒に作ります。高可用性(High Availability)が必要なシステムには、拡張の仕組みと予備のサーバーを設計します。数か月以内に大きなキャンペーンを控えているなら、キャンペーンの予定表と、前回システムに問題が起きたときの記録を持って、ご相談ください。作業は最もリスクの高い箇所から始めます。
SOFTWARE ENGINEERING GLOSSARY
ソフトウェア開発用語集
システムがどこまで耐えられるべきかを技術チームと取り決めるときに使う用語です。最初の2つは、事業部門が決めるべき数字です。
| 用語 | 意味 | わかりやすい例 | 開発チームへの質問 |
|---|---|---|---|
| RTO | 障害の発生から使える状態に戻るまでに、システムが止まっていてよい最長の時間 | 決済ページは30分以内に復旧させる、と店が決める | 設定したRTOは、訓練で実際に達成できたことがありますか? |
| RPO | バックアップから復元するときに、失ってもよいデータの期間 | 15分ごとにバックアップしていれば、復元しても失われる注文は直近15分の分に限られる | 今復元するとしたら、戻ってくる最新のデータは何時時点のものですか? |
| Backup | 本番システムとは別に保管するデータのコピー。実際のデータが壊れたり消えたりしたときに復元に使う | 注文データベースを毎晩別の場所にコピーし、30日分をさかのぼって保管する | バックアップはどこに保管されていて、誰がアクセスできますか?最後に復元を試したのはいつですか? |
| Load Test | 大勢のユーザーが同時にアクセスする状況を再現し、どこまで受け止められるか、どこで詰まるかを測ること | キャンペーンの1週間前に、5,000人の顧客が同時に購入ボタンを押す状況を再現する | 何人のユーザーからシステムが遅くなり始めますか?詰まるのはどの部分ですか? |
| Runbook | あらかじめ想定した障害に対応するための手順書。作業する人と判断する人を明記する | 決済ページが止まったら、誰が何を確認し、誰がSNSページで告知するか、どんな文面を使うかを手順書が示す | この手順書を使って最後に訓練したのはいつですか?当番表に載っている人は読んでいますか? |
| Disaster Recovery | データセンターの停止やデータの暗号化といった大きな障害が起きたときに、サービスを復旧するための計画と仕組み | クラウド事業者のリージョン全体が停止したとき、チームが別のリージョンにあるコピーからシステムを立ち上げる | この計画はどんな種類の障害を対象にしていますか?計画の発動を指示するには誰が必要ですか? |
| Failover | メインのサーバーが止まったときに、予備のサーバーやシステムへ自動的に切り替えること | メインのデータベースが停止し、システムが1分以内に予備へ切り替わる。顧客は何もしなくてよい | 切り替えを本番システムで試したことはありますか?切り替えの間にデータは失われませんか? |