
- AI 的基础能力,谁都能买到同样的水平;竞争对手复制不了的,是您在实际业务中产生的数据。
- 最有价值的数据往往散落在工单、邮件和各种文件里,很少整整齐齐地存放在数据库中。
- 在考虑技术之前,先盘点清楚:什么数据在哪里,由谁负责。
1. 基础智能人人买得到,专有知识就更值钱
如果您和竞争对手用的是同一个 AI,得到的智能水平也一样。对方唯一抄不走的,是只在您公司发生过的事:客户抱怨过什么,哪些工作出过问题,技术人员是怎么修好的。这些是花钱买不到的。
通用模型写作、总结和分析的能力越来越强,但它不知道公司怎样界定优质客户、哪些条件会让项目延误、什么样的回答能留住客户。这些数据来自实际工作,网上找不到。
数据量大并不等于有数据护城河(Data Moat)。护城河指的是这样的数据:与业务结果挂钩,质量好,使用权限合规,并且能回流到决策中。竞争对手也许几个月就能抄走 AI 功能,但多年积累的反馈记录和专有的业务理解很难复制。
2. 能拉开差距的五类数据
各类数据的价值并不相同。谁都能从网上找到的数据几乎帮不上忙,记录了您公司里哪类个案最后怎样收场的资料,才是稀缺的。
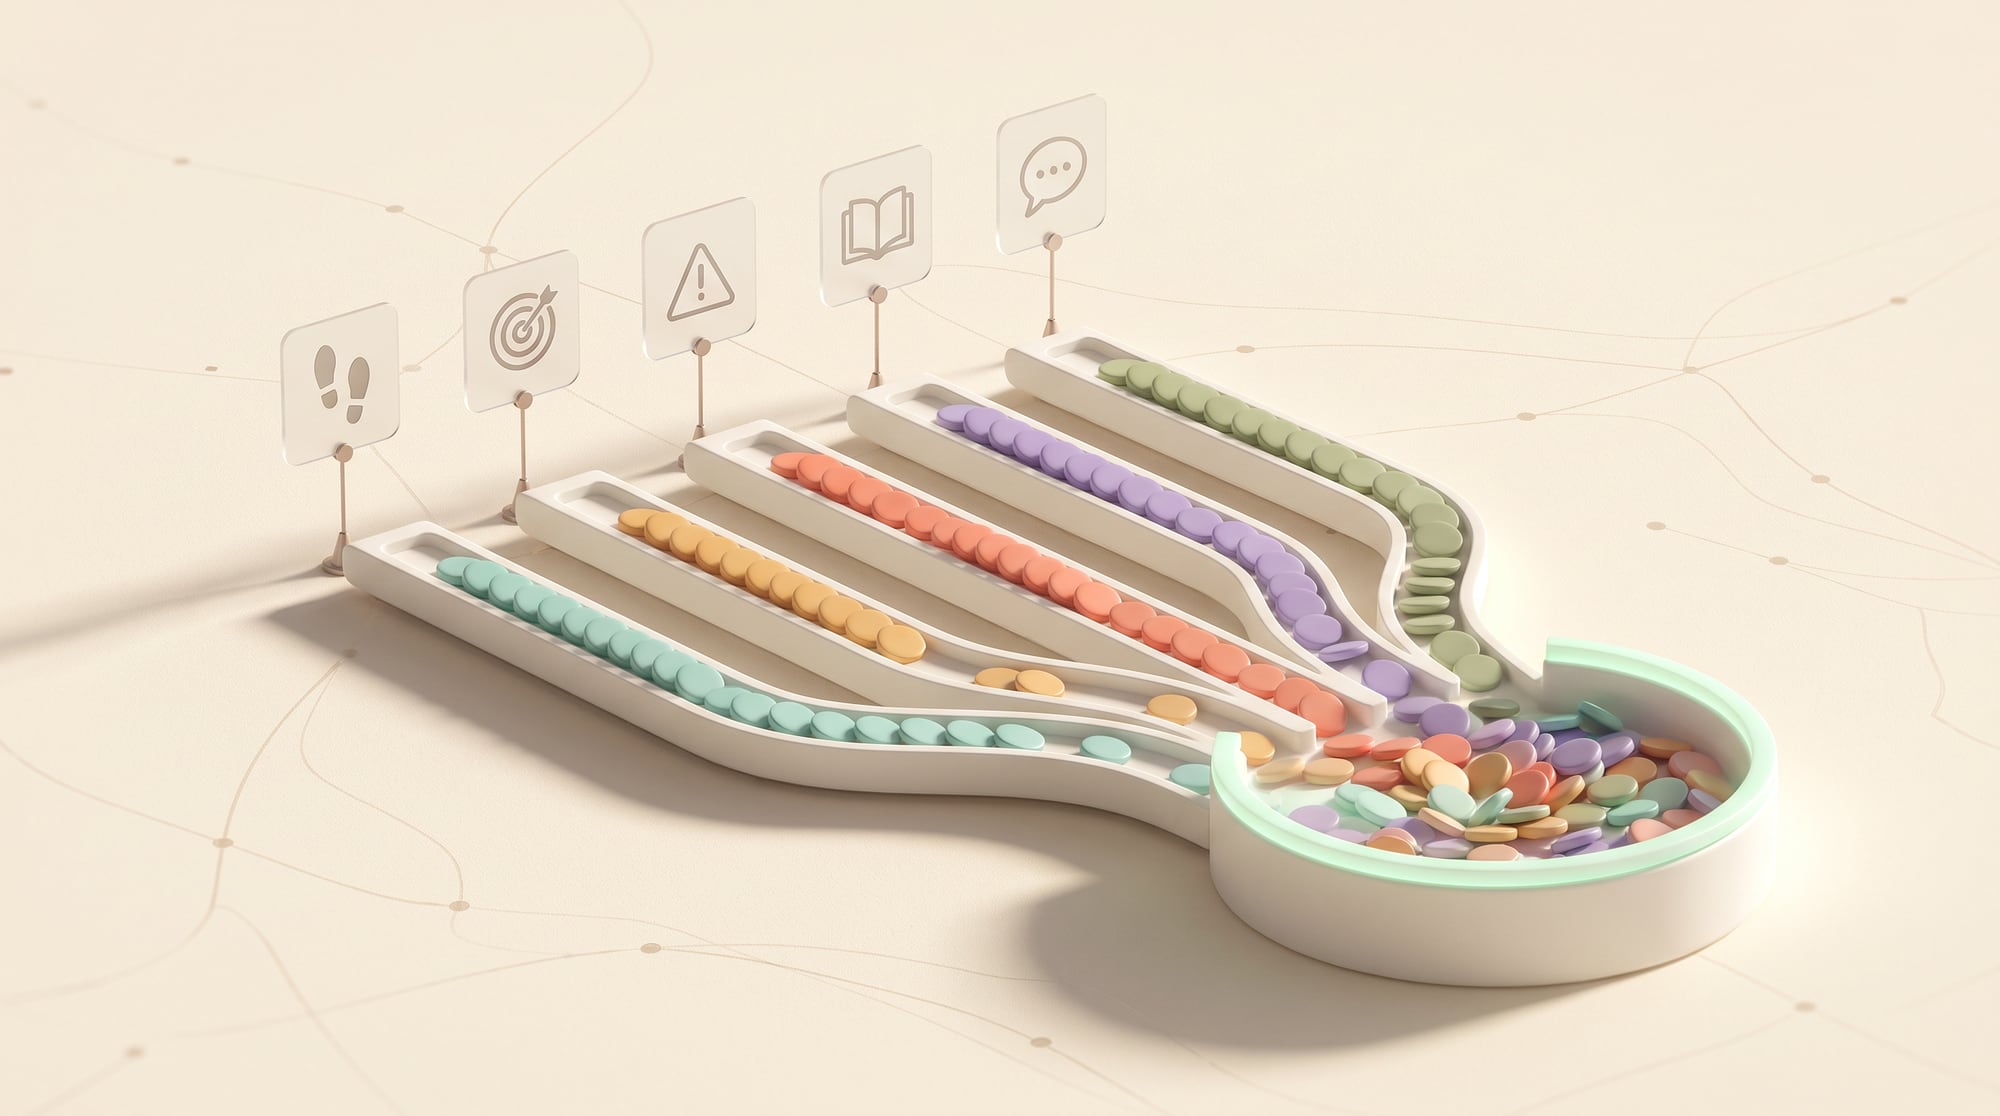
- 行为数据(Behavioral Data):客户实际做了什么,有别于口头上说的喜好
- 结果数据(Outcome Data):哪些解决方法带来了销售额、复购、质量提升或成本节省
- 例外数据(Exception Data):哪些个案偏离了标准,专家是怎样处理的
- 领域知识(Domain Knowledge):行业内行人才知道的规则、理由和取舍(Trade-off)
- 反馈数据(Feedback Data):对草稿的修改、否决,以及结果为什么不合适
大量营销文件的价值,可能还比不上一份与成交结果挂钩的销售异议记录。数据有没有价值,要看它能不能帮助回答决策问题、改进工作流,规模大小说明不了什么。
3. 用企业主的思路做数据盘点(Data Inventory)
从应用场景(Use Case)出发,不必把所有数据库都普查一遍。先选一个重要的决策,比如给销售线索(Lead)排优先级或推荐替代商品,再列出要用到的数据、来源、负责人、质量、使用权限和关联的结果。还要梳理数据血缘(Data Lineage),弄清每个数字或答案从哪里来、什么时候更新。
| 数据 | 负责人 | 质量 | AI 使用权限 | 关联的结果 |
|---|---|---|---|---|
| 客户历史记录 | 销售运营部 | 关键字段完整率 85% | 仅限内部使用 | 转化率/留存率 |
| 工单 | 客服部 | 文字质量好,分类不统一 | 个人数据(PII)须脱敏 | 解决率/客户满意度(CSAT) |
| 操作手册 | 产品部 | 部分内容已过期 | 按用户组开放 | 回答质量 |
把数据分成关键(Critical)、有用(Useful)和归档(Archive)三级(Tier)。不要一次清理所有数据,先投入第一条工作流要用的数据,并建立可以推广的标准。没有负责人的数据,不应拿来当标准答案(Ground Truth)。
4. 把零散的文件变成知识层(Knowledge Layer)
写给开发团队 · 系统架构
知识层里应该是经过审批的内容,并带有元数据、版本、生效日期、负责人和访问策略(Access Policy)。如果不标注状态就把所有文件导入向量数据库(Vector Database),AI 可能会取到旧价格和已废止的政策。要规定数据来源的优先顺序,以及数据互相矛盾时怎样回答。
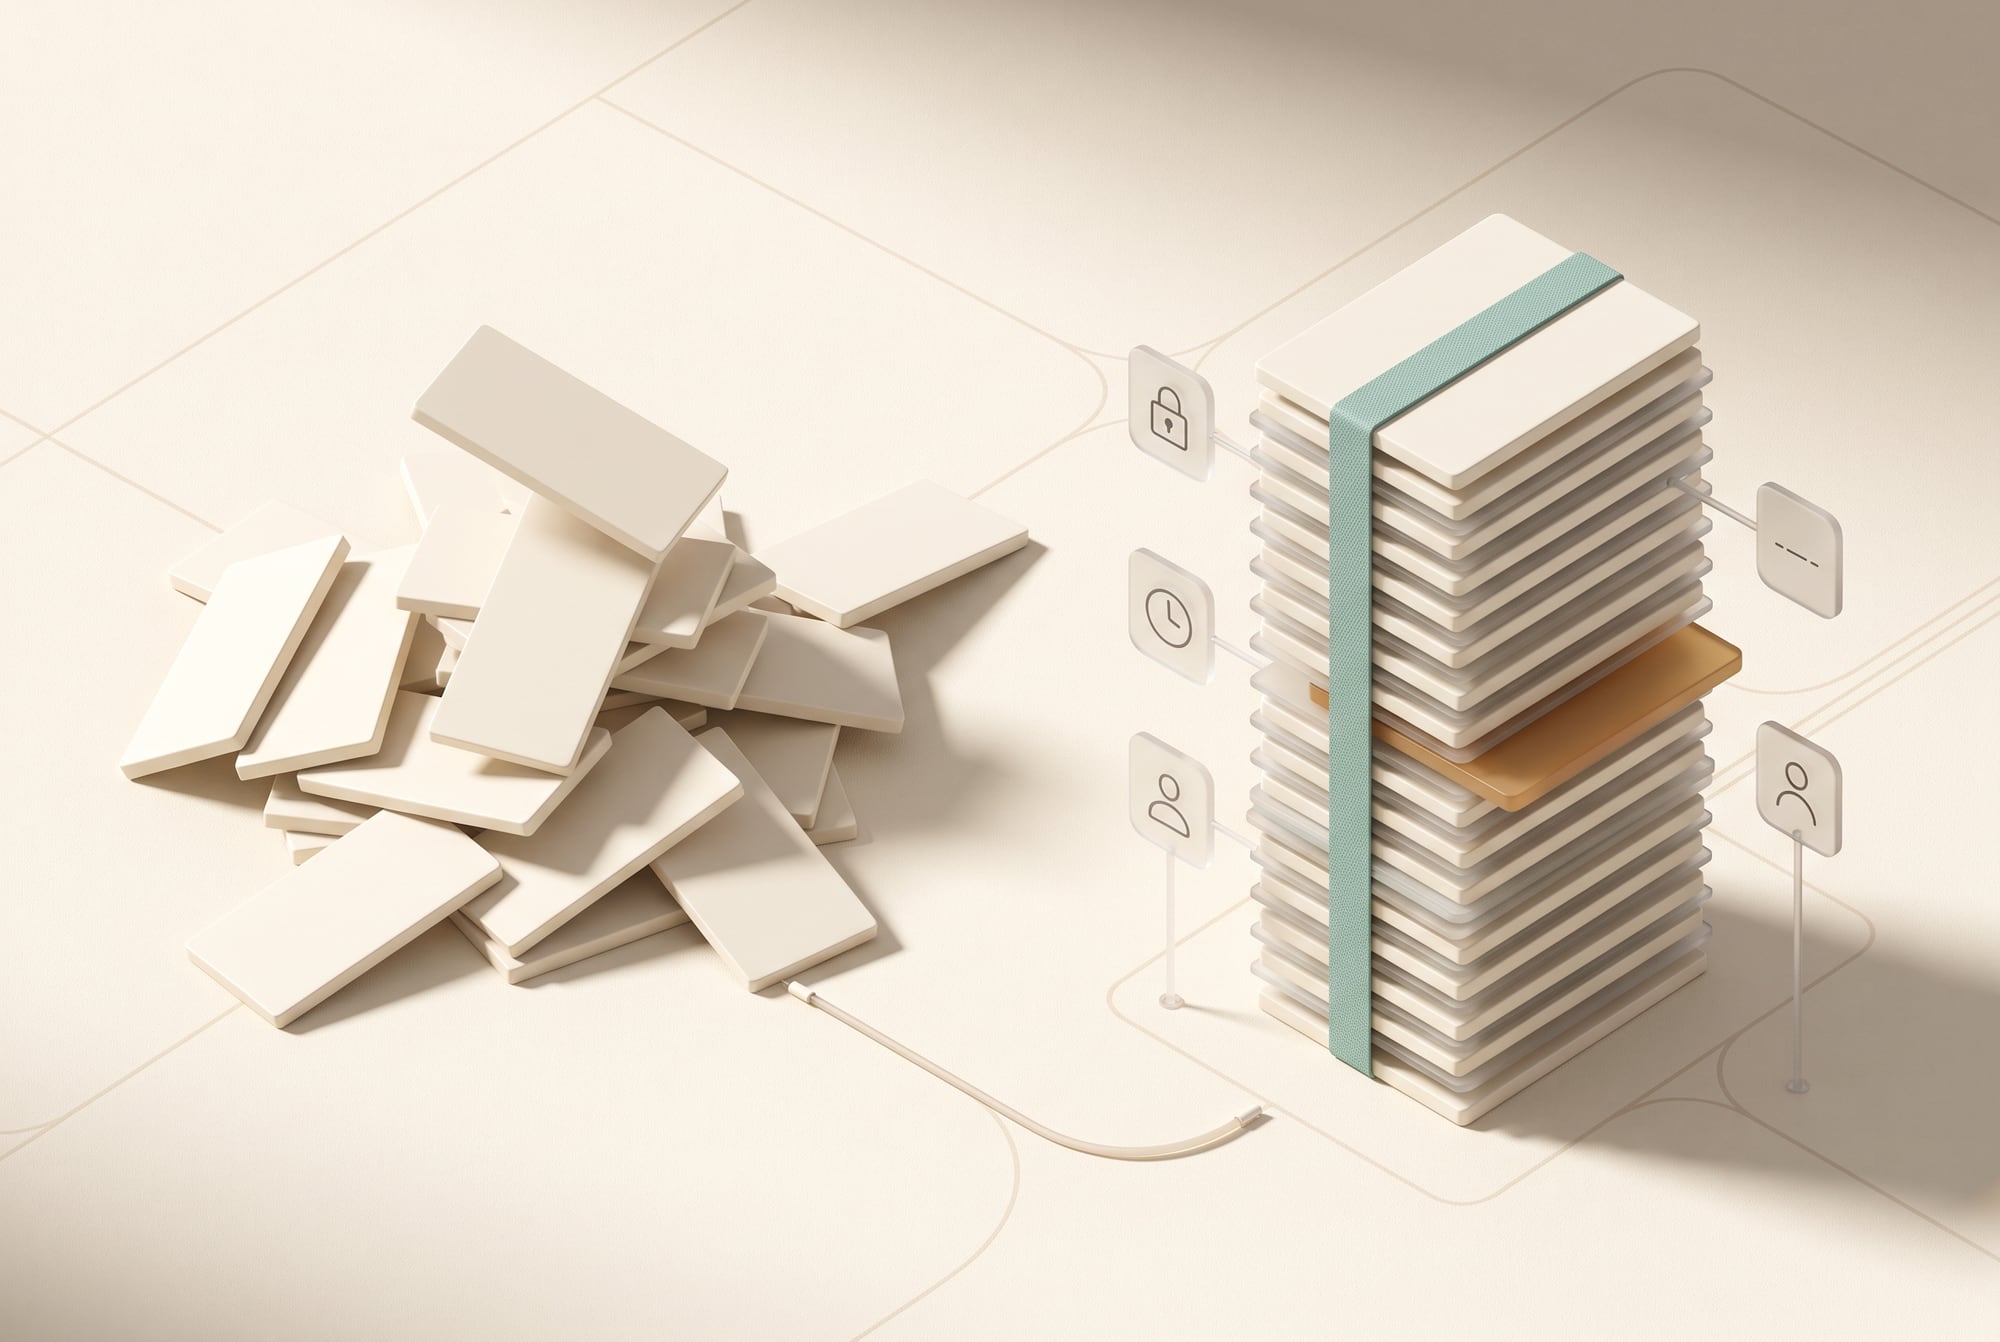
把事实、政策、示例和观点分开。事实必须来自核心系统,政策要有审批人,示例用来示范格式,但不是规则,观点应标明是个人意见。系统必须注明出处并显示日期,方便用户核查。
写给开发团队 · 技术细节
建立内容生命周期(Content Lifecycle):草稿(Draft)→ 审核(Review)→ 已批准(Approved)→ 已弃用(Deprecated),并定期提醒负责人。维护知识库是一项持续的运营工作,做一次迁移(Migration)项目解决不了问题。
5. 建立每做一笔业务就改进一次的反馈飞轮(Feedback Flywheel)
员工修改 AI 的结果时,不要只保存最终版本,还要记下改了什么、属于哪类错误、为什么改,并关联到客户细分(Segment)和结果,例如修改后促成成交的文案,或者减少了重复工单的回答。这些数据可以用来调整提示词(Prompt)、规则、知识库和评测。
反馈不应全部自动拿去训练模型,因为人也可能改错,或者那只是特殊情况。黄金数据(Golden Data)需要经过抽样和审批。要挑选质量高、覆盖面广的反馈,减少只来自某一类用户的偏差(Bias)。
6. 权限、质量和信任也是护城河的一部分
写给开发团队 · 技术细节
因为没有取得同意(Consent)或存在泄露风险而不能使用的数据,算不上资产。要按角色设定目的限制(Purpose Limitation)、保存期限(Retention)、脱敏(Masking)和访问权限。把用于业务运营、数据分析和模型改进的数据分开,不要假定一次授权就能覆盖所有用途。
为重要字段制定数据质量服务水平协议(Data Quality SLA),涵盖完整性、时效性和准确性,并指定出错时的负责人。监控必须能发现漂移(Drift),比如客户的行为模式变了,规则却还是老样子。还要按相关规定,为客户提供更正自身数据的渠道。
写给开发团队 · 技术细节
要支持导出(Export)和可移植性(Portability),不要把知识库绑定在单一供应商(Vendor)上。源数据、元数据和评测都要以可迁移的格式保存,让数据护城河留在公司手里,不会困在无法更换的服务里。
7. 把数据转化为业务成果,别做没有终点的数据项目
- 降低成本:知识库质量好,自动解决率就高,需要人工审核的就少
- 增加收入:行为数据加上结果数据,有助于推荐合适的方案和时机
- 开发产品:例外模式(Exception Pattern)能暴露出还没有人解决的问题
- 提高转换成本(Switching Cost):在透明、授权清楚的前提下,结果随客户自己的数据越用越好
- 降低风险:数据血缘和证据有助于审计,也能解释决策依据
写给开发团队 · 技术指标
每个数据项目都应该有价值假设(Value Hypothesis)和衡量指标,例如检索时间减少 40%、首次联系解决率(First-contact Resolution)提高 15 个百分点,或者建立能提升转化率的线索评分(Lead Score)。不要拿导入了多少文件或数据库有多大来代表价值。
8. 建立数据护城河的 18 个月路线图
写给开发团队 · 系统架构
第 1–3 个月:选定应用场景,盘点关键数据,指定负责人并衡量数据质量。第 4–6 个月:建立带数据血缘的知识层,测试第一条工作流。第 7–12 个月:把反馈与结果关联起来,建立黄金数据集(Golden Dataset)和评测。第 13–18 个月:扩展到其他产品,建立可复用的数据产品(Reusable Data Product),评估推出新服务的机会。
总结:数据护城河来自与结果挂钩、有负责人、有使用权限、有反馈循环的专有数据,文件堆得再多也形不成护城河。公司应该从重要的决策入手,建立知识层,并有条理地记录每一次修改。即使模型更换,公司的知识和学习机制仍会继续拉开差距。
把零散的文件变成系统用得上的资产
公司最有价值的数据,往往散落在技术人员手写的工单、销售人员回复客户的邮件和主管自己保存的文件里,很少存放在整洁的数据库中。这些知识的主人是您的团队,不是我们。DNA Maker 的工作是协助做数据盘点,弄清什么在哪里、由谁负责、哪些数据真能支撑决策、哪些质量还不够用。这一步常常会发现,公司手里的好东西比想象的多,只是还停留在机器读不懂的形式。
我们与您的团队一起动手做的工作
接下来,我们会设计元数据和访问权限都清楚的存储系统,搭建数据管道,让新数据持续流入,再建立基于检索增强生成(RAG)的检索层,回答问题时附上出处,让员工能信任答案,也能回头核查。让数据成为真正优势的,是反馈循环:每当有人修改答案或结案,系统都要把这些内容收回知识库。如果您的文档库难找到员工宁愿互相打电话询问,那正是我们可以帮忙的起点。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
讨论怎样把内部数据变成系统能用的资源时,会用到这组术语。
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| Metadata | 描述数据的数据,比如由谁创建、什么时候创建、适用于哪款产品,方便检索和筛选 | 标明这份手册适用于哪个机型、最后一次更新是什么时候 | 没有元数据,系统怎么知道哪些文件仍然有效? |
| RAG | 让 AI 检索公司的真实资料来组织回答,不靠通用知识去猜 | 问设备怎么设置,系统从最新版手册中找出内容来回答 | 答案引用的是哪一版文件?找不到资料时系统怎么回答? |
| Citation | 注明答案的出处,方便回头核查 | 答案附上所用手册页面的链接 | 如果用户不相信答案,还能怎样进一步核实? |
| Data Pipeline | 数据从源头流到系统使用位置的路径,途中会做清洗 | 每晚把当天的工单导入知识库 | 如果源数据的格式变了,系统能发现并发出提醒吗? |
| Data Retention | 规定数据保存多久、何时删除的政策 | 按法律和公司政策规定的期限保存客户对话记录 | 我们什么数据保存多久?这项政策由谁批准? |