
- 原型已经证明有人想用,但它还没经历过大量用户、填错的数据和一轮又一轮的修改。
- 原型不必整个扔掉,可以分成三类:保留的部分、需要加固的部分、应该重写的部分。
- 原型之后真正花时间的,是验证系统,以及为系统的结果承担责任。AI 能让这些工作快一些,但仍然要有人来做。
原型已经证明了什么,还没证明什么
假设您自己用 AI 工具,一周就做好了一个演示版,两三位客户试用后都很喜欢。接着您找人报价开发正式系统,拿到的工期却是以月计算的。第一个冒出来的问题是:一周和几个月之间的差额,到底花在了什么上?
原型已经回答了过去做软件最贵的几个问题:有没有人想用,用户看得懂什么样的界面,哪些步骤可以砍掉。在 AI 出现之前,要得到这些答案得花好几个月和一大笔钱。所以用 Vibe Coding(氛围编程)做出的原型确实有价值,应该作为正式系统的起点。
原型还没证明的,是它在演示中从未遇到的情况下会怎么表现。下表列出六种情况,正式系统在第一年里一定会遇到。
| 演示从未遇到的情况 | 正式系统第一次遇到时会发生什么 | 生产级系统事先做好的准备 |
|---|---|---|
| 两个人在同一秒预订同一件物品 | 两人都收到了确认单,可物品只有一件 | 在数据库里锁定记录的规则,以及请求互相冲突时的测试 |
| 用户填了过去的日期,或者填了负数 | 合计金额出错,月底报表的数字对不上 | 校验输入的数据,并提示用户哪里需要改 |
| 改好一个功能,另一个功能却坏了 | 要等客户打电话来,团队才知道 | 每次上线前都会自动运行的测试套件 |
| 用户从十个人增加到几千人 | 高峰时段网页慢到没法用 | 提前做负载测试,并采用可以扩展的结构 |
| 开发者离职了,或者想不起当初是怎么给 AI 下指令的 | 没人敢改代码 | 别人也看得懂的代码结构、文档和修改历史 |
| 新功能上线后出了问题 | 团队当着客户的面,直接在正式系统上修 | 先在预发布环境测试,出了问题几分钟内就能回滚到上一个版本 |
代码便宜多了,正式系统仍然需要时间
AI 让写代码快了好几倍,剩下的是检查工作:读 AI 写出来的东西,测试那些不该发生却可能发生的情况,对涉及钱和客户数据的事情做决定。这类工作仍然需要能为结果负责的人来做。
用 Vibe Coding 写出的代码,往往走最短的路达到结果:同一段逻辑在好几个地方重复出现,变量名看不出含义,也没有测试兜底。这样的代码只要不用改,就能用得很好。一旦业务要调整价格结构、增开分店或对接会计系统,每改一处都可能把别处弄坏。工程师把这种负担叫作技术债务,因为每次修改系统,它都在累积利息。
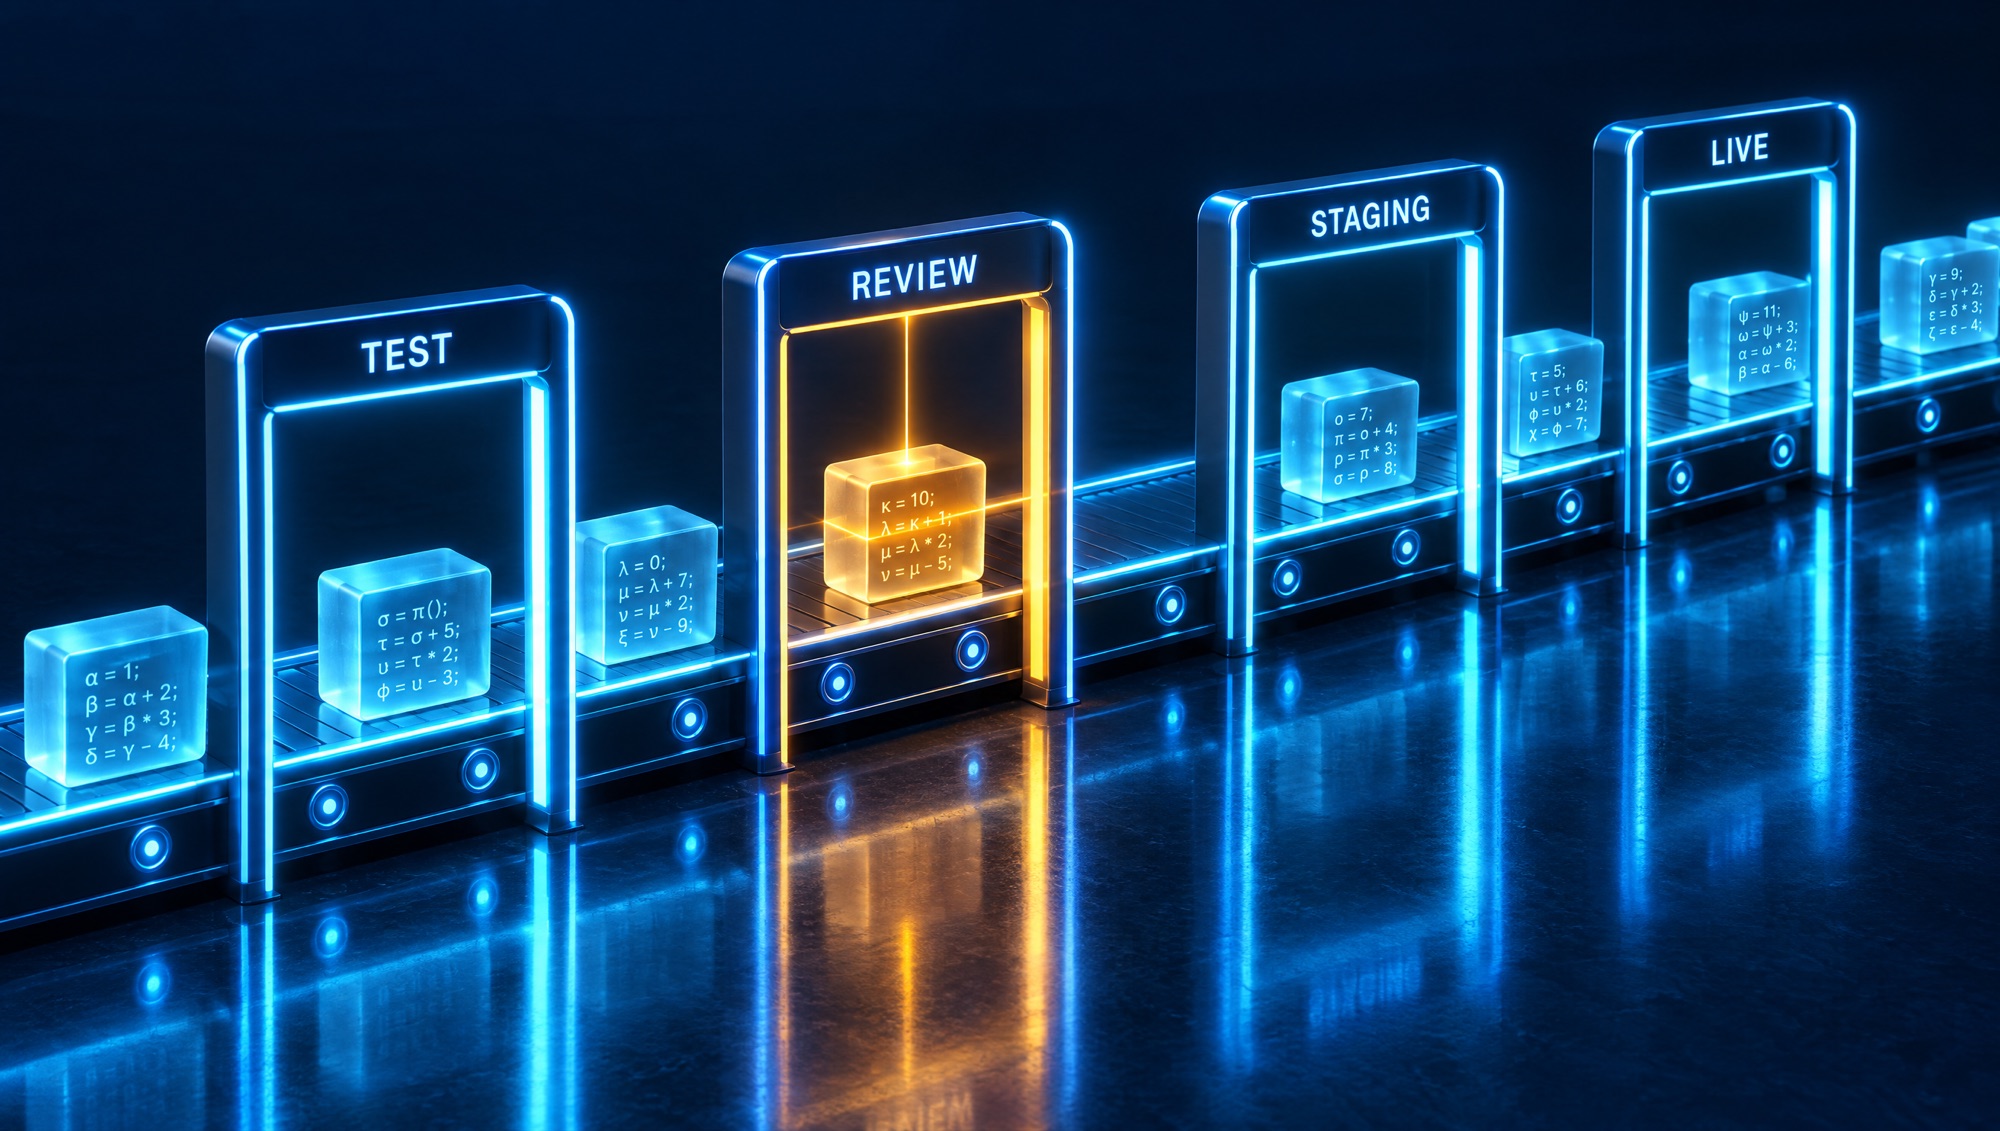
今年,好的开发团队同样用 AI 写代码,区别在于代码周围的那套流程。代码合并进系统之前,由另一位工程师读一遍,这叫作代码审查。每次修改都会自动运行测试套件。有单独的环境,可以先试再上线。还有文档,让新人能接手。报价单上的那几个月,买的就是这些流程。
模拟案例
活动设备租赁公司:同一套音响被重复预订
一家活动设备租赁公司的老板,用 AI 花六天做了一套预订系统。四名销售人员不再用 Excel 文件,改用这套系统,第一个月一切顺利。到了年底活动扎堆的时候,两名销售在同一天把同一套音响订给了两位客户,系统给两边都发了确认。公司直到活动当天早上装车时才发现,只好从别的租赁商那里转租一套音响,花的钱比向客户收的租金还多。
工程师查看代码后发现,原因在于“检查物品是否空闲”和“保存预订”是两个分开的步骤,所以两个人可以同时通过第一步。原型从没遇到过这个问题,因为试用时一次只有一个人在用。公司保留了这套系统,用下面的三类分法决定把力气花在哪里。
分成三类:保留、加固、重写
- 列出原型的所有界面和功能
- 对每一项问两个问题:这部分出错,谁会损失什么?明年这部分要改得多频繁?
- 保留类:出错也不会让任何人损失钱的界面和报表,可以直接继续用
- 加固类:逻辑已经正确,但还没有测试或数据校验的部分。补上测试,并请工程师审查
- 重写类:涉及钱、库存、权限或客户数据,而且原有结构很难继续修改的部分
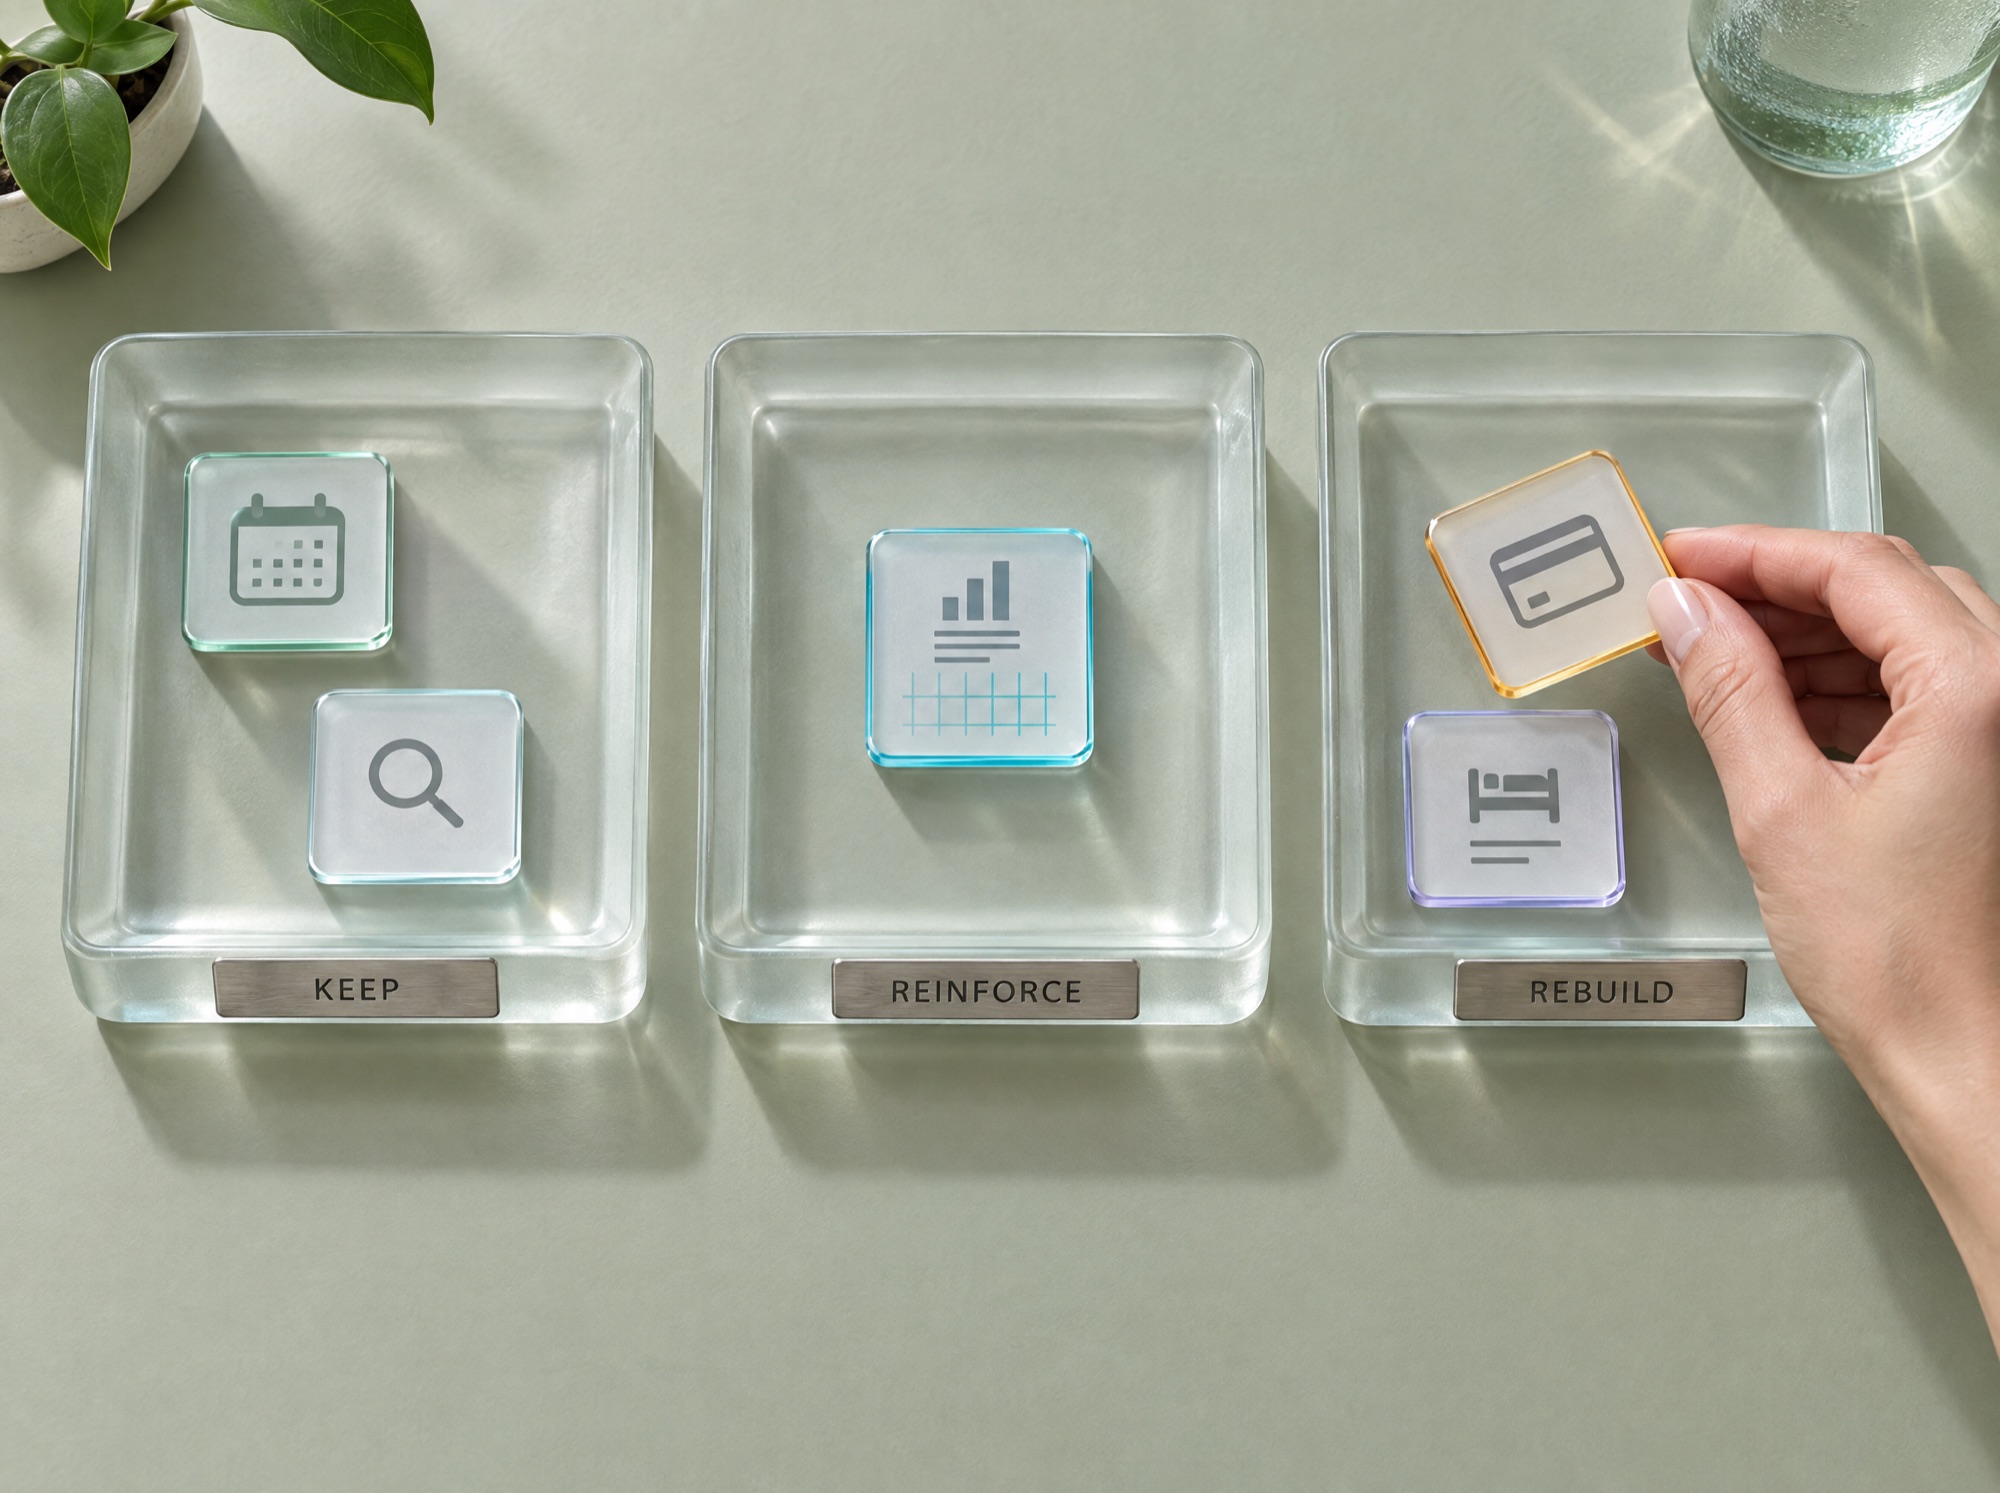
在这个案例里,设备搜索页和日历归入保留类,租赁收入报表归入加固类,预订和计费则归入重写类。应该留下的依据,是完整的清单,以及每一项归入哪一类的理由。如果原型完全没有分模块,改一处就牵动整个系统,这个方法就不管用了。这种情况下,把原型当作需求规格整体重写,反而更快。
哪些系统可以一直用 Vibe Coding 做下去
很多系统没必要做成生产级系统。几个人的团队内部用的工具、三个月后就会停用的试验项目、短期营销活动的网页,都可以一直用 Vibe Coding,不必请开发团队。等到系统出错开始有代价,投入做成生产级系统才划算。
该做成生产级系统的信号
- 有外部客户登录使用
- 有资金或库存经过系统
- 不止一个团队同时使用
- 系统一停,公司的工作就停
- 系统需要把数据传给会计系统或其他系统
风险较小的做法是分阶段推进:先用三类分法评估原型;接着优先重写高风险的部分,让一小批用户与原来的做法并行使用;等平稳度过一轮业务高峰、没有发生严重事故,再把所有用户迁移过来。过程中盯住三个数字:客户比团队先发现的问题有多少,上线后需要回滚几次,新来的工程师要多久才能独立修改代码。
写给开发团队 · 技术指标
跟踪变更失败率(Change Failure Rate)、用户报告的 Bug 与团队自己发现的 Bug 之比、涉及资金和库存部分的测试覆盖率(Test Coverage)、从 Commit 到 Production 的交付周期(Lead Time),以及新工程师上手(Onboarding)所需的时间。预订和支付部分应该做并发测试(Concurrency Test),并用一个事务(Transaction)把“检查”和“保存”包在一起。
暂停规则:如果连续两次上线后,客户遇到的问题都在增加,就停止加新功能,先回头给出问题的部分补测试。
BUSINESS & PRODUCT READINESS
找开发团队之前,先准备好这四样东西
如果企业主手里带着这四个问题的答案,评估会快得多,也准得多。答案不必完整,估计的数字也可以。开发团队会据此判断每个部分要做到多牢靠。
功能清单,以及每个功能出错时谁会损失什么
用户数量,以及使用最集中的时段
需要与之收发数据的其他系统
谁拥有代码,交付后由谁维护
接手您的原型,把它做成业务可以依赖的系统
业务规则只有您和您的团队最清楚:哪些物品可以重复预订,价格什么时候变,谁来审批折扣。DNA Maker 从原型里、也从和您的团队一起观察实际工作的过程中,把这些规则梳理出来,写成工作流、每条记录的状态、业务规则和测试用例。原型做对的那些事,只是因为还没碰上难处理的情况;以后这些都会变成经过测试、确认正确的行为。
我们用三类分法评估原型,保留能用的部分,把涉及钱和数据的部分在可扩展的架构(Architecture)上重写。团队在工程师审查下用 AI 辅助写代码,通过持续集成/持续交付(CI/CD)和三套环境上线,最后把源代码、文档和部署手册交给您,由您持有。DNA Maker 自 2012 年以来已交付 500 多个项目,所以知道系统上线后的问题通常出在哪里。如果您已经有原型,可以带上演示链接,以及未来十二个月业务需要的功能清单,来和我们聊聊。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
这些词会出现在开发团队的报价单和工作计划里。弄懂了意思,就能看出每一部分的时间和钱花在了哪里。
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| Technical Debt | 为了求快先写出来的代码所留下的负担,让之后每次修改都更慢、风险更高 | 租金计算公式在五个地方各写了一遍,涨一次价就得把五处都找出来改 | 系统哪个部分的技术债务最多?它让修改工作慢了多少? |
| Code Review | 代码合并进系统之前,请另一位工程师读一遍,找出错误,保持统一的标准 | AI 写的计费代码上线前,由另一位工程师读过,并追问了折扣叠加的情况 | 涉及钱和客户数据的代码由谁审查?每次都审查吗? |
| CI/CD | 自动化的流水线,每次都按同样的步骤测试代码并部署上线,不再靠手工操作 | 每次改代码,系统都会自动运行测试,通过后才部署到测试服务器 | 从改完代码到上线正式系统要多久?还有哪些步骤靠手工? |
| Staging | 和正式系统一样的模拟环境,新功能先在这里试,再开放给客户 | 销售团队在正式开放前一周,先在预发布环境里试用提前预订功能 | 预发布环境和正式系统有哪些不同?谁批准上线? |
| Automated Test | 一组检查重要功能是否仍然正常的程序,每次修改代码都能自动运行 | 测试模拟两个人同时预订同一件物品,检查是否只有一个人订到 | 正式系统里出过的故障,已经加进测试了吗? |
| Rollback | 新版本出问题时,把系统退回上一个版本 | 新版本导致开不了报价单,团队五分钟内退回了旧版本 | 上一次演练回滚是什么时候?回滚期间产生的数据怎么处理? |
| Refactoring | 重新整理代码结构,让后续修改更容易,系统的功能保持不变 | 把五处租金计算公式合并成一处,用户察觉不到任何变化 | 这次重构会怎样让下一个功能做得更快或更省钱? |