
- 系统宕机有三种:扛不住访问量、数据丢失、悄无声息地出故障却没人知道。每一种都要用不同的方法来准备。
- 从没试过恢复的备份文件,还不能算有备份。
- 有两个问题必须由企业主自己回答:系统最多能停多久,数据最多能丢失多少小时。技术团队会按照这两个答案来设计。
企业会遇到的三种宕机
活动当天晚上八点整,几千名客户同时涌进网站,页面开始一直转圈。市场团队在聊天群里问出了什么事,没有人答得上来。这是人们最常想到的宕机情形,但造成损失更大的宕机,往往比这安静得多。
第一种是扛不住访问量。平时轻松支撑正常用户量的系统,一旦同时访问的人数超过以往,就会慢到没法用。瓶颈通常在数据库,增加网页服务器也无济于事。
第二种是数据丢失,原因可能是员工误删了数据表、服务器损坏,也可能是把所有文件加密的勒索软件。如果备份一直与主系统相连,勒索软件会连备份一起加密。
第三种是悄悄出故障。网页还能打开,但某些关键步骤停止了工作:客户付款成功,订单却没有记录下来,或者确认邮件没有发出去。这种情况代价最高,因为等到有人发现,往往已经过了好几个小时,还得一笔一笔去补救。
用 Vibe Coding(氛围编程)做的应用,界面一应俱全,却没有监控,没有数据备份,凌晨两点出了事也不会有人起来处理。原因是没有人让 AI 做这些,演示时也没人看出缺了什么。
四层准备,以及应该要求查看的证据
准备好迎接周五晚高峰的餐厅,知道厨房每小时能出多少道菜,有人盯着前厅,煤气用完时有备用炉灶,每个人也都知道停电时由谁拍板。线上系统需要同样的四样东西,每一样都有企业主不懂技术也能要求查看的证据。
| 准备层级 | 企业主要问的问题 | 应该要求查看的证据 |
|---|---|---|
| 承载能力 | 系统能同时支撑多少用户才开始变慢? | 最近一次负载测试的结果,附上数字和测试日期 |
| 可见性 | 如果系统现在出了异常,谁先知道,客户还是我们? | 监控界面,以及已经设置的告警清单 |
| 恢复 | 如果数据库现在丢了,我们能把数据恢复到哪个时间点?需要几个小时? | 最近一次恢复演练的记录 |
| 应急响应 | 周六晚上系统宕机,谁来拍板?谁通知客户? | 运维手册(Runbook),以及写着真实姓名的值班表 |
恢复这一层需要企业主回答两个问题。第一,系统最多能停多久,业务损失才不至于超出承受范围,工程师把这个值叫作恢复时间目标(RTO)。第二,数据最多可以往回丢失多少,叫作恢复点目标(RPO)。每分钟接几十张订单的店铺,接受不了一天的 RPO,因为那等于一整天的订单全没了;每月只更新一次的公司官网,就完全可以接受。这两个值定得越短,费用越高,所以数字应该由业务来定。
沿用已久的备份原则是 3-2-1:保存三份副本,放在两种不同的存储介质上,其中一份放在异地。遇到勒索软件时能保住的,就是那份放在异地、又不与主系统相连的副本。
模拟案例
化妆品品牌:活动开始后的头二十五分钟
一个通过自有网站销售的化妆品品牌,晚上八点开始做活动。八点零四分,网站开始变慢;八点十分,支付页面卡住了。有些客户已经被扣款,却没拿到订单号,因为银行发来的确认信号到达时,系统正好没有响应。团队八点二十五分从社交媒体账号的评论里得知出了问题,八点四十分才重启了服务器。第二天早上,三名员工只能把银行的扣款记录和系统里的订单逐笔核对。
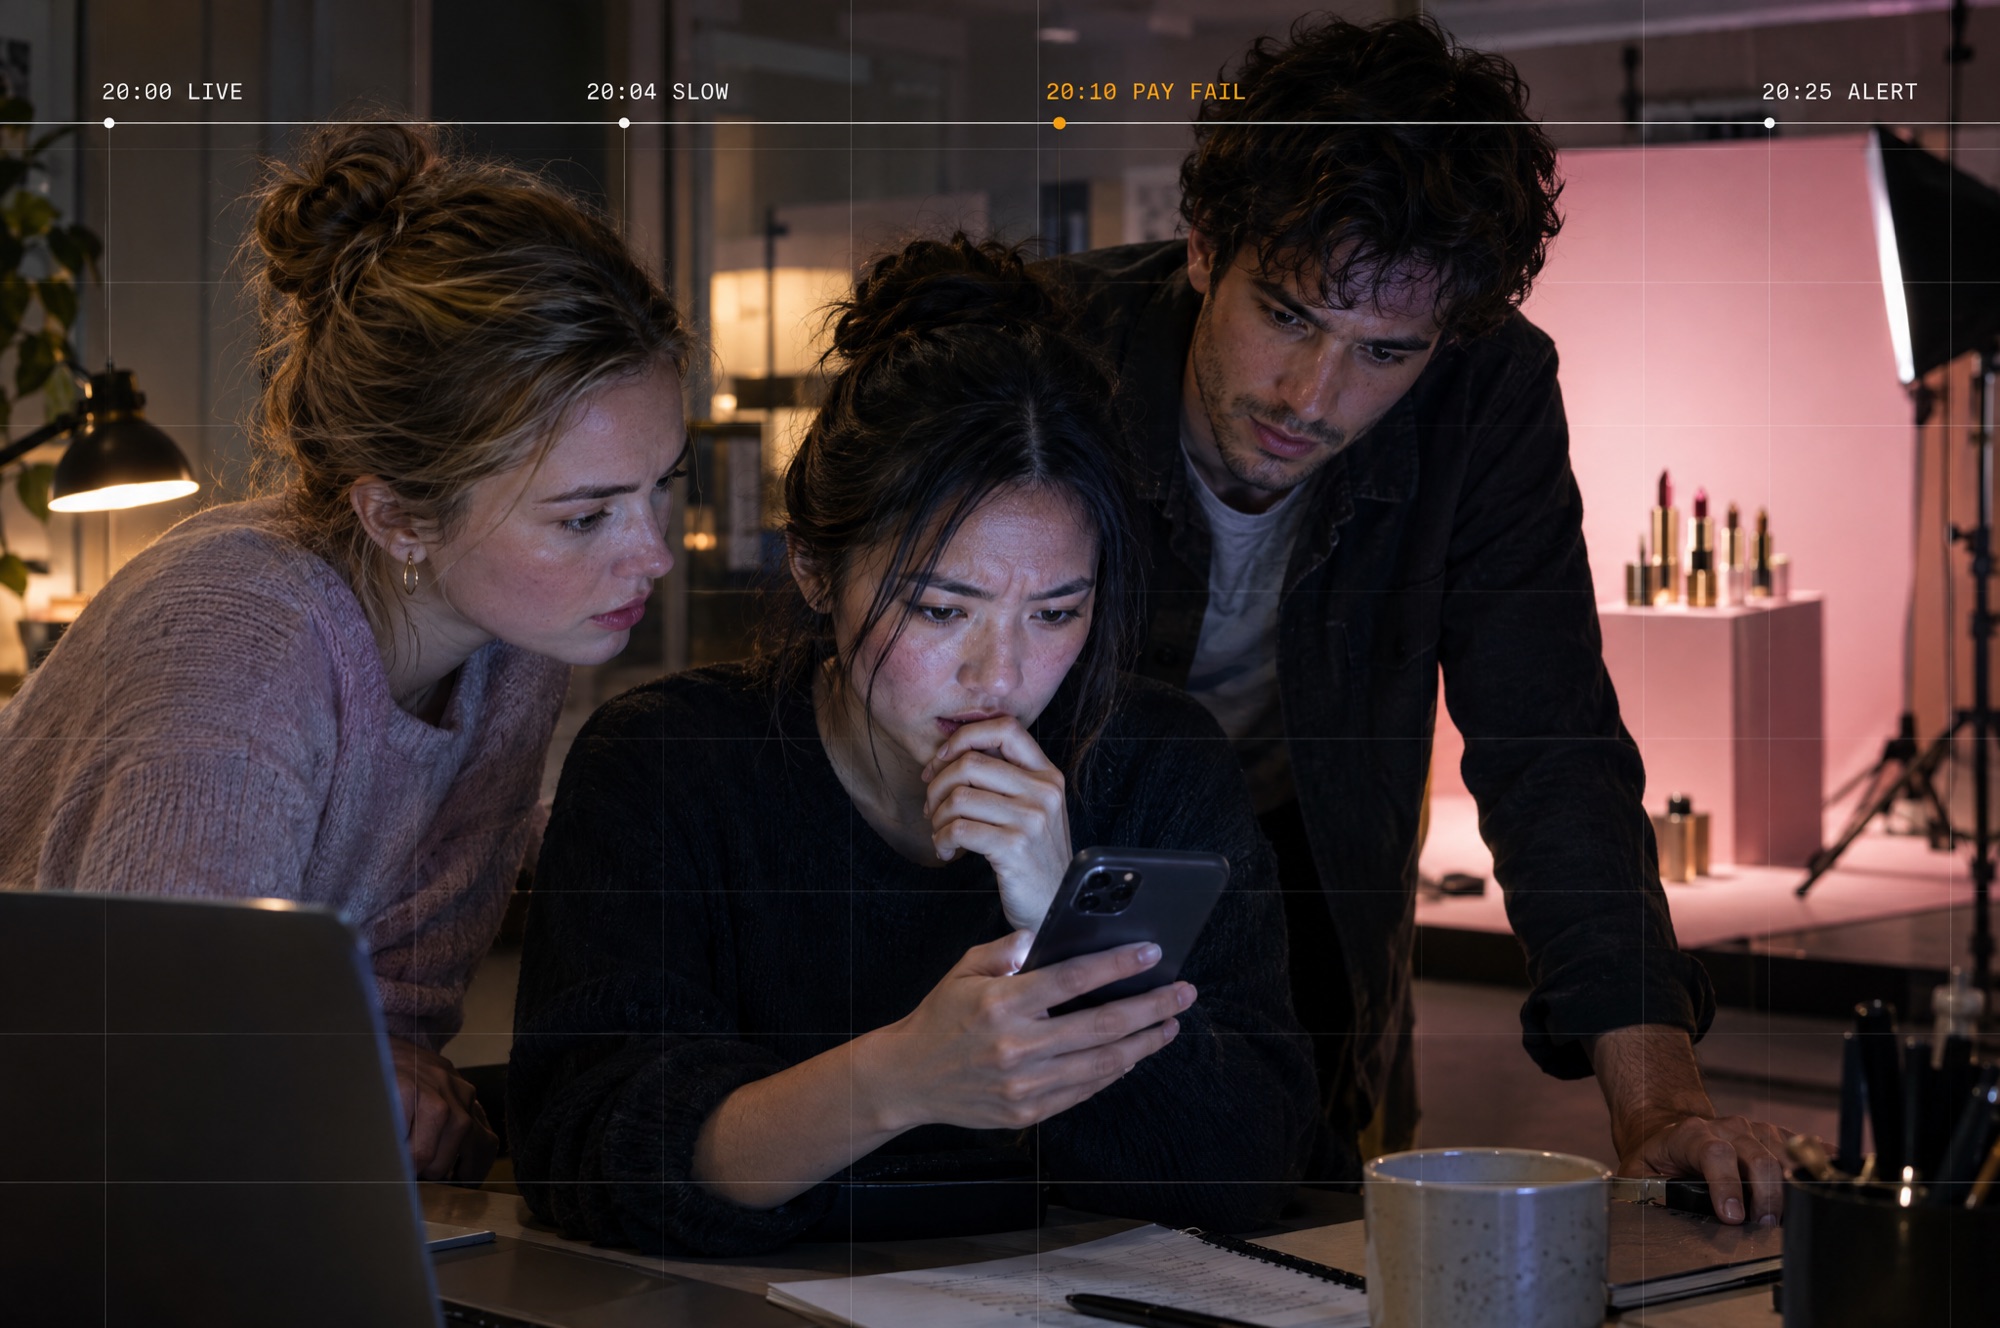
回头看每一层准备能改变什么:活动前一周做负载测试,就会发现数据库是瓶颈;和支付成功率挂钩的告警,能让团队在两分钟内知道;接收订单的队列会把银行的信号保存下来,直到系统恢复;运维手册写明由谁在社交媒体账号上发布公告,不用在事发时临时商量。
每季度做一次恢复演练
- 选出主数据库最近的一份备份
- 恢复到与正式系统分开的另一台服务器上,从开始计时,直到能正常使用为止
- 检查三件事:备份里最新的订单是什么时间的?客户数量与正式系统是否一致?能否登录并打开订单?
- 记下花费的时间和丢失数据的时间段,再与企业主定下的目标值比较
- 修好卡住的地方,再约下一次演练的日期
证据是写有日期、所用时间和执行人姓名的演练记录。演练最常出的漏洞是只备份了数据库,而商品图片、客户上传的文件和系统配置放在另一个地方,从来没有备份过。
准备到什么程度,对企业才划算
通过电商平台或现成的开店平台销售的店铺,几乎不用考虑这些,平台方已经替您管好了。本文讨论的是拥有自己系统的企业,这类企业要自己决定准备到哪一层。
一个实用的思路是估算每小时的损失:把高峰期每小时的销售额,加上团队补救所需的人工成本,再加上从此不再回来的客户,然后与每一层准备的费用比较。损失较低的企业,至少也应该有经过恢复演练的数据备份和基础告警,因为这两样花费不高,却能防住无法挽回的损失。
比较合理的投资顺序是:先做数据备份和恢复演练,再监控涉及资金的链路,然后在大型活动前做负载测试,编写运维手册并演练应急响应。最后一步是能自动接管的备用系统,也就是故障转移(Failover),适合完全不能停机的企业。
出现以下情况,就该升到下一层
- 高峰期每小时的销售额,高于这一层准备的费用
- 即将举办的活动,预计访问人数会超过系统以往承受过的水平
- 曾经发生过客户比团队先发现问题的情况
- 与企业客户签的合同里,对服务时间有明确规定
投资之后要跟踪的数字是:从故障发生到团队发现的时间,从发现到系统恢复的时间,客户先发现的故障数量,以及最近一次恢复演练的结果。如果装了监控之后,团队发现故障所用的时间没有缩短,说明告警还挂在服务器指标上,没有和客户遇到的情况挂钩。应该先回头改这里,再考虑加服务器。
在下一次大型活动之前,把系统准备好
业务能承受停机多久,由您的管理层决定;市场部门掌握活动日程;客服部门知道系统出问题时客户会问什么。DNA Maker 汇总这三方的回答,转化为系统目标:哪些时段绝对不能停机,哪些链路必须监控(从下单、支付到订单确认),以及事故发生时的决策顺序。
我们的团队会审查架构(Architecture),做负载测试和压力测试(Stress Test)找出瓶颈,在涉及资金的链路上部署监控和告警,安排备份周期并做恢复演练,还会和您的团队一起编写灾难恢复计划和运维手册。需要高可用(High Availability)的系统,扩容方案和备用服务器由我们来设计。如果您两三个月后有大型活动,可以带上活动日程和最近一次系统故障的记录来和我们聊聊,工作会从风险最高的地方开始。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
和技术团队商定系统要有多强的承受能力时,会用到这些词。前两个是必须由业务部门来定的数字。
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| RTO | 允许系统停机的最长时间,从故障发生算起,到恢复使用为止 | 店铺规定支付页面必须在三十分钟内恢复 | 设定的 RTO 在演练中真正达到过吗? |
| RPO | 从备份恢复时,允许丢失的数据时间段 | 每十五分钟备份一次,如果需要恢复,丢失的订单不会超过最后十五分钟 | 如果现在就要恢复,能拿回的最新数据是几点的? |
| Backup | 与主系统分开保存的数据副本,在真实数据损坏或丢失时用来恢复 | 订单数据库每晚复制一份存到别处,保留最近三十天 | 备份文件存在哪里?谁能访问?最近一次试恢复是什么时候? |
| Load Test | 模拟大量用户同时访问系统,测出能承受多少、瓶颈在哪里 | 活动前一周,模拟五千名客户同时下单 | 系统在多少用户时开始变慢?瓶颈是哪个部分? |
| Runbook | 应对预先想到的故障时逐步操作的手册,写明谁执行、谁拍板 | 支付页面宕机时,手册写明谁检查什么、谁在社交媒体账号上发公告、用什么措辞 | 这本手册上一次用于演练是什么时候?值班表上的人都读过了吗? |
| Disaster Recovery | 发生重大事故时恢复服务的计划和系统,例如数据中心宕机或数据遭到加密 | 云服务商整个区域宕机时,团队用另一个区域的副本把系统启动起来 | 这份计划涵盖哪些类型的事故?启动计划需要哪些人下令? |
| Failover | 主服务器停止工作时,自动切换到备用服务器或备用系统 | 主数据库宕机,系统在一分钟内切换到备用库,客户不需要做任何操作 | 切换在正式系统上测试过吗?切换过程中有没有丢数据? |