
- 시스템 장애에는 세 종류가 있습니다. 접속을 감당하지 못하는 경우, 데이터가 사라지는 경우, 아무도 모르게 조용히 고장 나는 경우입니다. 종류마다 대비하는 방법이 다릅니다.
- 복구를 한 번도 시험하지 않은 백업 파일은 아직 백업으로 칠 수 없습니다.
- 두 가지 질문에는 대표가 직접 답해야 합니다. 시스템이 얼마나 오래 멈춰도 되는지, 데이터를 몇 시간 전 것까지 잃어도 되는지입니다. 기술팀은 이 답에 맞춰 설계합니다.
기업이 겪는 세 가지 시스템 장애
캠페인 당일 저녁 8시 정각, 고객 수천 명이 한꺼번에 웹사이트에 들어옵니다. 페이지가 로딩 표시만 돌린 채 멈추고, 마케팅팀이 단체 채팅방에서 무슨 일이냐고 묻지만 아무도 답하지 못합니다. 사람들이 장애라고 하면 가장 먼저 떠올리는 모습입니다. 하지만 피해가 더 큰 장애는 대개 이보다 조용합니다.
첫 번째는 접속을 감당하지 못하는 장애입니다. 평소 사용자는 넉넉히 받아 내던 시스템도 겪어 본 적 없을 만큼 많은 사람이 동시에 들어오면 쓸 수 없을 만큼 느려집니다. 막히는 지점은 대개 데이터베이스여서, 웹 서버를 늘려도 소용이 없습니다.
두 번째는 데이터 손실입니다. 원인은 직원이 엉뚱한 테이블을 지우는 실수, 장비 고장, 모든 파일을 암호화해 버리는 랜섬웨어까지 다양합니다. 랜섬웨어는 백업 파일이 기간 시스템에 늘 연결되어 있으면 백업까지 번집니다.
세 번째는 조용한 고장입니다. 웹사이트는 여전히 열리는데 중요한 단계 몇 개가 멈춰 있습니다. 고객은 결제를 마쳤는데 주문이 기록되지 않거나, 확인 이메일이 나가지 않습니다. 누군가 알아차리기까지 몇 시간이 지나고, 그동안 쌓인 건을 하나씩 찾아 고쳐야 하므로 비용이 가장 많이 듭니다.
바이브 코딩으로 만든 앱은 화면은 다 갖추고 있어도 모니터링과 데이터 백업이 없고, 새벽 2시에 호출을 받을 사람도 없습니다. 아무도 AI에게 그런 것을 만들라고 시키지 않았고, 데모 때는 빠졌다는 사실을 아무도 몰랐기 때문입니다.
준비의 네 단계와 보여 달라고 할 증거
금요일 밤 손님을 맞을 준비가 된 식당은 주방이 시간당 몇 접시를 낼 수 있는지 압니다. 홀을 지켜보는 사람이 있고, 가스가 떨어질 때 쓸 예비 화구가 있으며, 정전이 되면 누가 결정하는지 모두가 압니다. 온라인 시스템에도 같은 네 가지가 필요합니다. 그리고 항목마다 대표가 기술을 몰라도 보여 달라고 할 수 있는 증거가 있습니다.
| 준비 단계 | 대표가 던질 질문 | 보여 달라고 할 증거 |
|---|---|---|
| 수용 능력 | 시스템이 느려지기 전까지 동시에 몇 명을 받을 수 있습니까? | 가장 최근 부하 테스트(Load Test) 결과와 수치, 테스트 날짜 |
| 가시성 | 지금 시스템에 이상이 생기면 누가 먼저 압니까? 고객입니까, 우리입니까? | 모니터링(Monitoring) 화면과 설정해 둔 알림 목록 |
| 복구 | 지금 데이터베이스가 사라지면 어느 시점까지의 데이터를 되찾을 수 있고, 몇 시간이 걸립니까? | 가장 최근 데이터 복구 훈련 기록 |
| 대응 | 토요일 밤에 시스템이 멈추면 누가 결정하고, 누가 고객에게 알립니까? | 런북(장애 대응 절차서)과 실제 이름이 적힌 당직 근무표 |
복구 단계에는 대표의 답이 두 가지 필요합니다. 첫째는 사업 피해가 감당할 수 없는 수준이 되기 전까지 시스템이 얼마나 오래 멈춰도 되는가입니다. 엔지니어는 이 값을 RTO(목표 복구 시간)라고 부릅니다. 둘째는 데이터를 얼마나 이전 것까지 잃어도 되는가이며, 이것을 RPO(목표 복구 시점)라고 합니다. 1분에 주문이 수십 건씩 들어오는 쇼핑몰은 RPO를 하루로 둘 수 없습니다. 하루 치 주문이 통째로 사라진다는 뜻이기 때문입니다. 반면 한 달에 한 번 업데이트하는 회사 웹사이트라면 하루도 충분합니다. 두 값을 짧게 잡을수록 비용이 올라가므로, 숫자는 사업 쪽에서 정해야 합니다.
오래전부터 써 온 백업 원칙은 3-2-1입니다. 사본을 세 벌 두고, 두 종류의 저장 매체에 나눠 담고, 그중 한 벌은 사업장 밖에 보관합니다. 랜섬웨어를 만났을 때 살아남는 것은 사업장 밖에 있으면서 기간 시스템과 연결되지 않은 사본입니다.
가상 사례
화장품 브랜드의 캠페인 첫 25분
자사 웹사이트로 판매하는 한 화장품 브랜드가 저녁 8시에 캠페인을 시작했습니다. 8시 4분에 사이트가 느려지기 시작했고, 8시 10분에는 결제 페이지가 멈췄습니다. 일부 고객은 돈이 빠져나갔는데 주문 번호를 받지 못했습니다. 은행의 결제 확인 신호가 시스템이 응답하지 않는 사이에 도착했기 때문입니다. 팀은 8시 25분에 SNS 페이지의 댓글을 보고서야 사태를 알았고, 8시 40분에 서버를 재시작했습니다. 다음 날 아침 직원 세 명이 은행의 결제 내역과 시스템의 주문을 한 건씩 대조해야 했습니다.
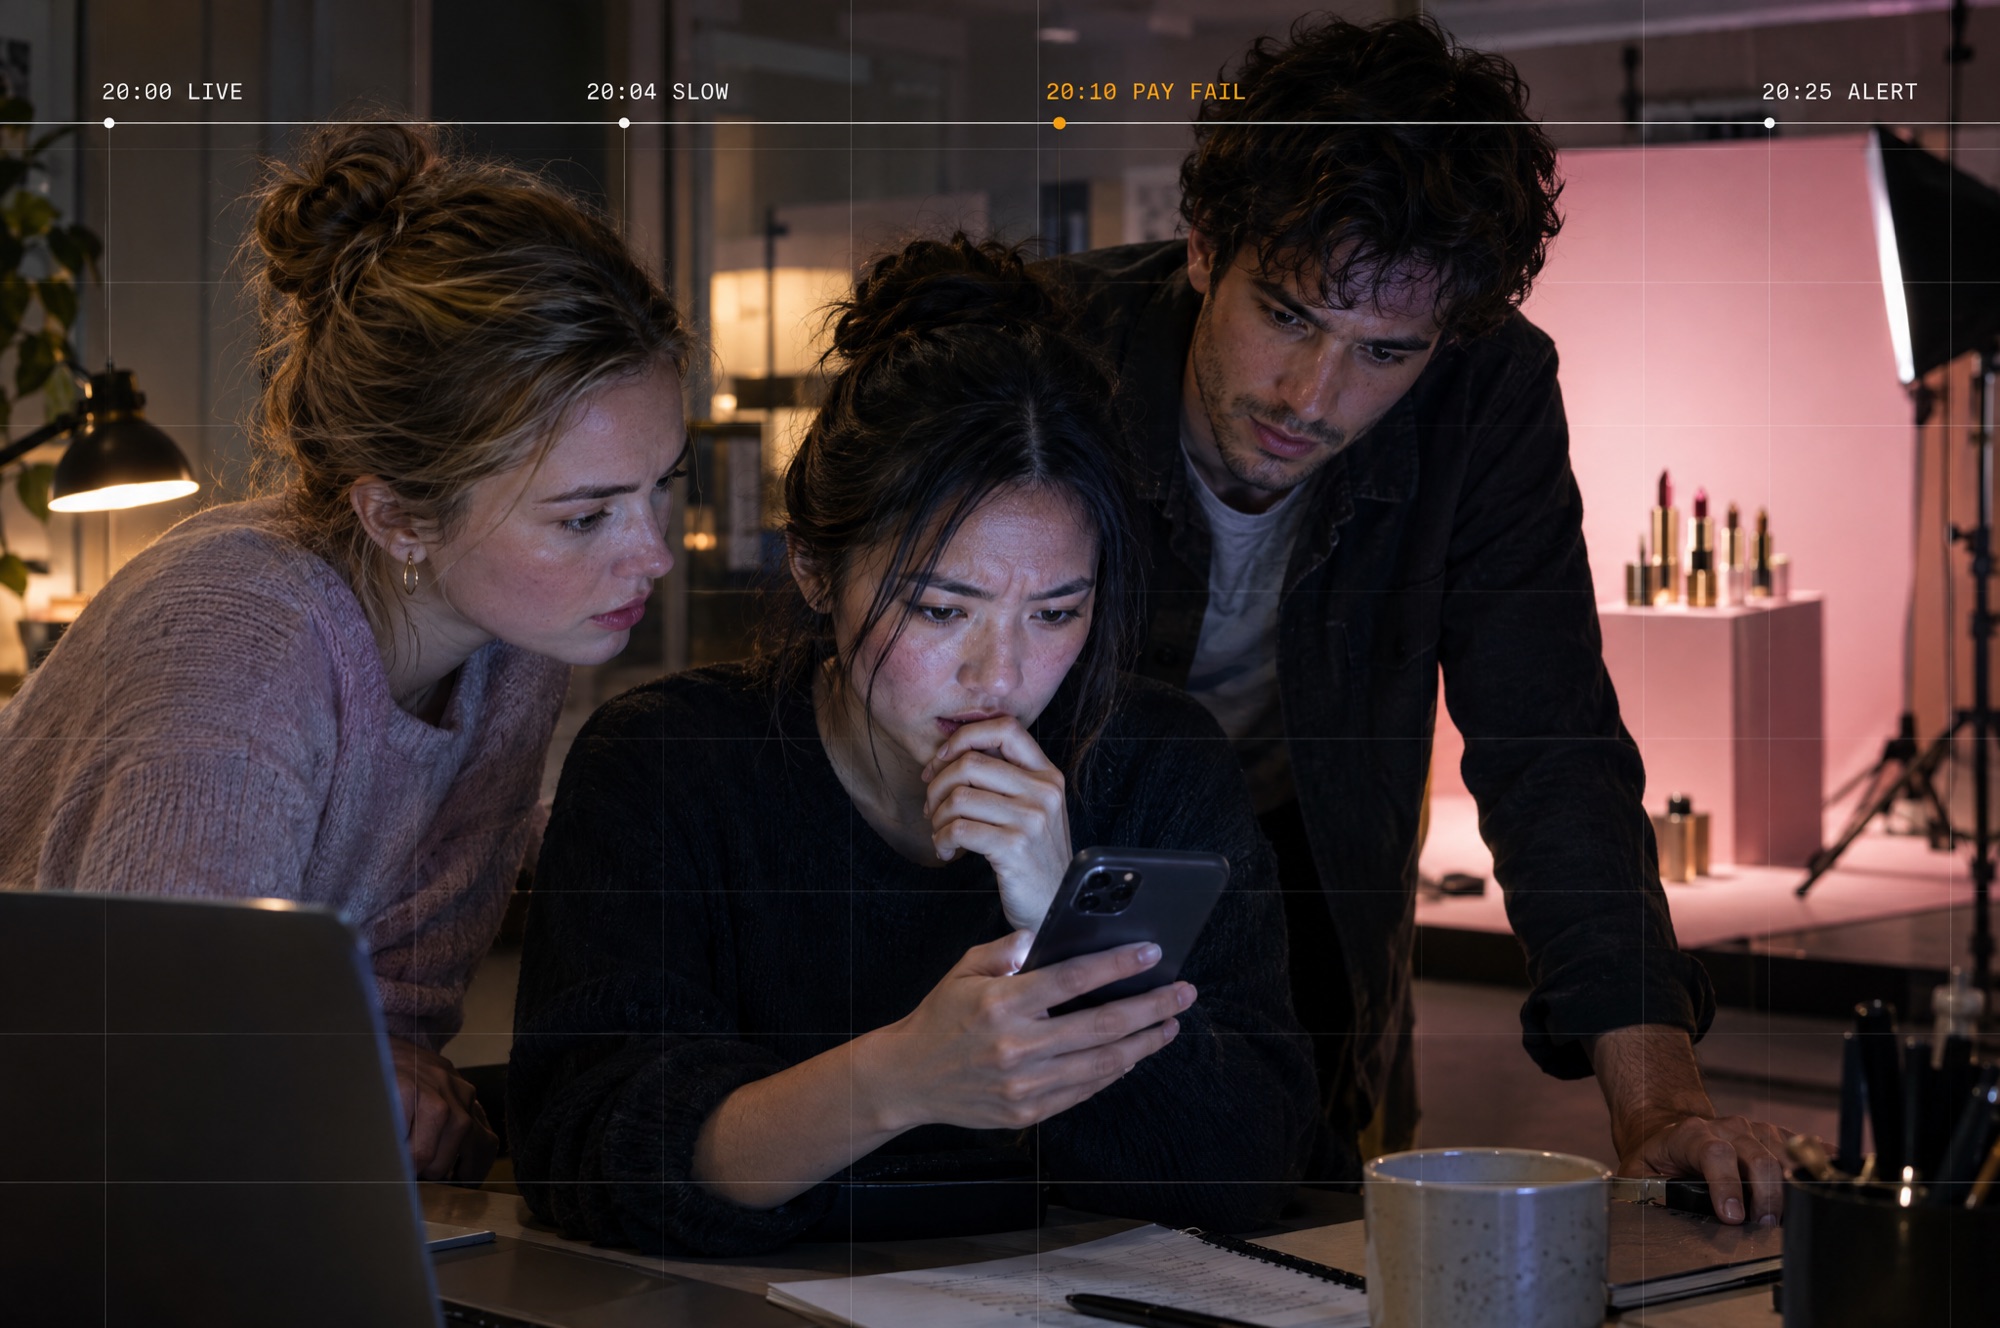
준비 단계별로 따져 보면, 캠페인 일주일 전의 부하 테스트는 데이터베이스가 병목이라는 사실을 알려 주었을 것입니다. 결제 성공률에 연결된 알림이 있었다면 팀은 2분 안에 알았을 것입니다. 주문 대기열은 시스템이 돌아올 때까지 은행 신호를 보관했을 것이고, 런북이 있었다면 사고 한가운데서 서로 묻지 않아도 누가 SNS 페이지에 공지할지 정해져 있었을 것입니다.
분기마다 데이터 복구 훈련하기
- 주 데이터베이스의 가장 최근 백업 파일을 고릅니다.
- 실제 시스템이 아닌 별도 서버에 복구하고, 시작부터 쓸 수 있는 상태가 될 때까지 시간을 잽니다.
- 세 가지를 확인합니다. 백업 파일에 있는 가장 최근 주문이 몇 시 것인지, 고객 수가 실제 시스템과 일치하는지, 로그인해서 주문을 열 수 있는지입니다.
- 걸린 시간과 잃은 데이터의 범위를 적고, 대표가 정한 값과 비교합니다.
- 막혔던 부분을 고치고 다음 훈련 날짜를 잡습니다.
증거는 날짜, 걸린 시간, 수행한 사람의 이름이 적힌 훈련 기록입니다. 훈련이 자주 어긋나는 지점은 데이터베이스만 백업해 두고, 상품 이미지, 고객이 올린 문서, 시스템 설정은 한 번도 백업하지 않은 다른 곳에 둔 경우입니다.
어느 수준까지 준비해야 투자한 만큼의 값을 할까
오픈마켓이나 임대형 쇼핑몰 플랫폼에서 판매하는 곳은 이 문제를 거의 고민하지 않아도 됩니다. 서비스 제공업체가 이미 관리해 주기 때문입니다. 이 글은 자체 시스템을 운영해서 어느 단계까지 준비할지 스스로 정해야 하는 기업을 위한 것입니다.
쓸 만한 계산법은 시간당 피해액을 어림해 보는 것입니다. 피크 시간대의 시간당 매출에, 사태를 수습하는 팀의 인건비와 다시 돌아오지 않을 고객을 더한 다음, 준비 단계별 비용과 비교합니다. 피해액이 적은 기업이라도 최소한 복구 훈련까지 마친 백업과 기본 알림은 갖춰야 합니다. 둘 다 비용이 크지 않고, 되돌릴 수 없는 피해를 막아 주기 때문입니다.
합리적인 투자 순서는 백업과 복구 훈련에서 시작합니다. 그다음 돈이 오가는 경로를 모니터링하고, 큰 캠페인 전에 부하 테스트를 하고, 런북을 쓰고 장애 대응을 연습합니다. 마지막으로 한순간도 멈추면 안 되는 기업이라면 주 시스템이 멈출 때 자동으로 이어받는 예비 시스템을 둡니다. 이것을 페일오버(Failover)라고 합니다.
다음 단계로 올라가야 할 때
- 피크 시간대의 시간당 매출이 그 단계의 준비 비용보다 큽니다.
- 시스템이 받아 본 적 없는 접속량이 예상되는 캠페인이 있습니다.
- 고객이 팀보다 먼저 장애를 알아챈 적이 있습니다.
- 기업 고객과 맺은 계약에 서비스 제공 시간이 정해져 있습니다.
투자한 뒤에 지켜봐야 할 숫자는 장애가 생긴 뒤 팀이 알기까지 걸린 시간, 안 뒤로 시스템이 돌아오기까지 걸린 시간, 고객이 먼저 알아챈 장애 건수, 가장 최근 복구 훈련 결과입니다. 모니터링을 설치했는데도 팀이 장애를 알아채는 시간이 줄지 않는다면, 알림이 고객이 겪는 증상이 아니라 아직 서버 수치에 연결되어 있다는 뜻입니다. 서버를 더 사기 전에 그 부분부터 고치십시오.
다음 큰 캠페인 전에 시스템을 준비합니다
사업이 얼마나 멈춰도 되는지는 경영진이 정합니다. 마케팅팀은 캠페인 일정을 알고, 고객 서비스팀은 시스템에 문제가 생겼을 때 고객이 무엇을 묻는지 압니다. DNA Maker는 세 부서의 답을 모아 시스템 목표로 바꿉니다. 절대 멈추면 안 되는 시간대, 주문부터 결제와 주문 확인까지 지켜봐야 할 경로, 장애가 났을 때의 의사결정 순서입니다.
저희 팀은 아키텍처를 점검하고, 부하 테스트와 스트레스 테스트로 병목 지점을 찾습니다. 돈이 오가는 경로에는 모니터링과 알림을 설치하고, 백업 주기를 정해 복구 훈련까지 진행하며, 재해 복구(DR) 계획과 런북을 고객사 팀과 함께 씁니다. 고가용성(High Availability)이 필요한 시스템이라면 확장 구조와 예비 서버도 설계합니다. 두세 달 안에 큰 캠페인이 잡혀 있다면 캠페인 일정과, 시스템에 마지막으로 문제가 생겼을 때의 기록을 가지고 이야기해 보십시오. 작업은 가장 위험한 지점부터 시작합니다.
SOFTWARE ENGINEERING GLOSSARY
소프트웨어 엔지니어링 용어집
시스템이 어디까지 버텨야 하는지 기술팀과 합의할 때 쓰는 용어입니다. 앞의 두 용어는 사업 쪽에서 정해야 하는 숫자입니다.
| 용어 | 의미 | 쉬운 예시 | 개발팀에 물어봐야 할 질문 |
|---|---|---|---|
| RTO | 장애가 난 순간부터 다시 쓸 수 있을 때까지, 시스템이 멈춰 있어도 되는 최대 시간 | 쇼핑몰이 결제 페이지는 30분 안에 복구되어야 한다고 정합니다. | 정해 둔 RTO를 훈련에서 실제로 지켜 본 적이 있습니까? |
| RPO | 백업 파일로 복구해야 할 때 잃어도 되는 데이터의 범위 | 15분마다 백업하므로, 복구해야 할 때 잃는 주문은 마지막 15분 이내로 제한됩니다. | 지금 복구해야 한다면 되찾을 수 있는 가장 최근 데이터는 몇 시 것입니까? |
| Backup | 실제 데이터가 손상되거나 사라졌을 때 복구에 쓰려고, 기간 시스템과 따로 보관하는 데이터 사본 | 주문 데이터베이스를 매일 밤 다른 곳에 복사해 두고, 30일 치를 보관합니다. | 백업 파일은 어디에 있고, 누가 접근할 수 있으며, 마지막으로 복구를 시험한 것은 언제입니까? |
| Load Test | 많은 사용자가 동시에 접속하는 상황을 재현해, 시스템이 얼마나 감당하고 어디서 막히는지 재는 시험 | 캠페인 일주일 전에 고객 5,000명이 동시에 구매 버튼을 누르는 상황을 재현합니다. | 사용자가 몇 명일 때부터 시스템이 느려지고, 병목은 어느 부분입니까? |
| Runbook | 미리 예상한 장애에 대응하는 단계별 안내서로, 누가 실행하고 누가 결정하는지까지 적은 문서 | 결제 페이지가 멈추면 누가 무엇을 확인하고, 누가 SNS 페이지에 공지하며, 어떤 문구를 쓰는지 안내서에 나와 있습니다. | 이 안내서로 마지막으로 훈련한 것은 언제이고, 당직 근무표에 있는 사람들은 읽어 보았습니까? |
| Disaster Recovery | 데이터센터가 멈추거나 데이터가 암호화되는 것 같은 큰 사고가 났을 때 서비스를 되살리기 위한 계획과 시스템 | 클라우드 사업자의 한 리전 전체가 멈추자, 팀이 다른 리전에 있는 사본으로 시스템을 띄웁니다. | 이 계획은 어떤 사고까지 다루고, 계획을 가동하려면 누가 필요합니까? |
| Failover | 주 서버가 멈추면 예비 서버나 예비 시스템으로 자동으로 전환하는 일 | 주 데이터베이스가 꺼지자 시스템이 1분 안에 예비 데이터베이스로 전환하고, 고객은 아무것도 할 필요가 없습니다. | 실제 시스템에서 전환을 시험해 본 적이 있고, 전환 중에 사라진 데이터가 있었습니까? |