- 企业 AI 系统分为七层。公司自己不做决定的层,供应商就会替公司决定。
- 用云端还是部署在公司内部,可以逐层分别决定;但管理权限和保存记录的层应当留在公司这一侧。
- 先选一项工作,先约定怎样才算通过,再从数据层往上搭建。
一套 AI 系统有七层
设想开一家新分店:需要门店、经理、员工、文件柜、通往仓库的专线、审批规则和月底报告。AI 系统同样具备这些部分,每一部分都可以选择租用云服务,或以本地部署(On-Premise)的方式装在公司内部。
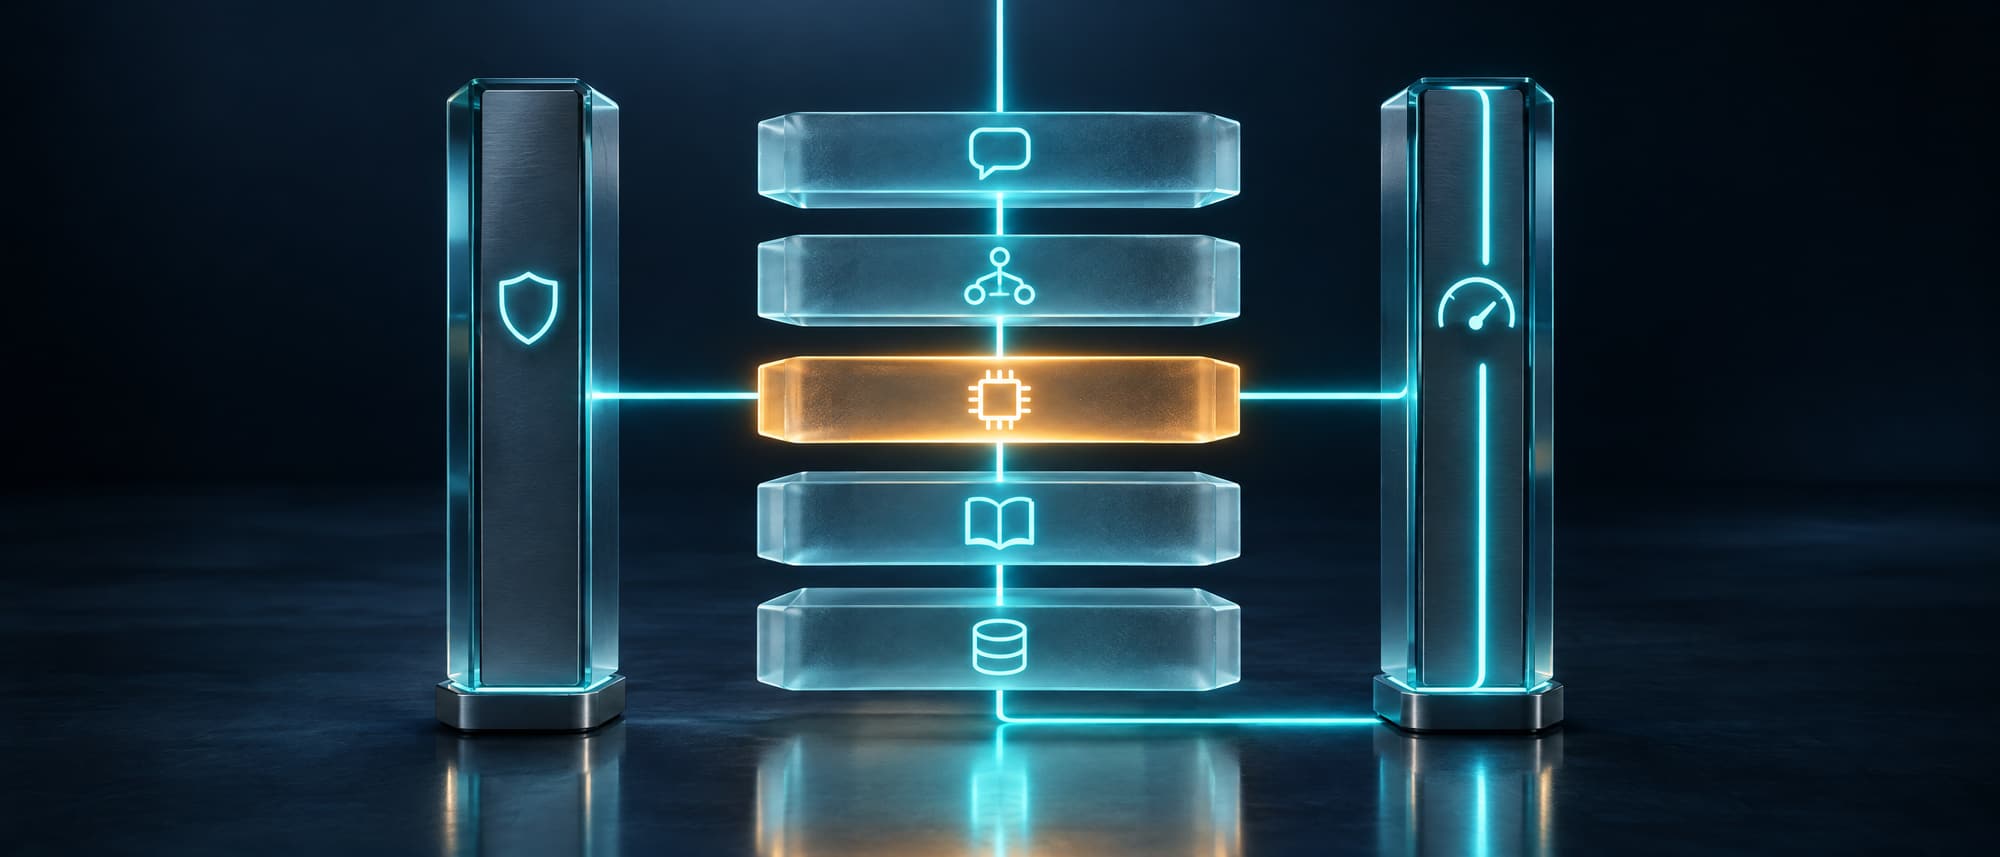
本章的配图是从上到下叠放的五层:渠道、编排、模型、知识、数据与业务系统。另有两根贯穿所有层的支柱:管控与效果评估。问题向下流向数据,答案每跨过一层都要经过管控支柱,再向上返回。
第 1 层 渠道:人在哪里输入问题
渠道指 LINE、网页、应用或电子邮件。IT 部门要决定先开放哪个渠道,以及如何确认输入问题的是谁。第一个渠道最好选员工已经在用的地方。常见的错误是选用不绑定员工账号的渠道,系统因此无法判断谁该看到什么。LINE 消息一定会经过 LINE 的服务器。如果数据不能离开公司,就使用以 SSO 登录的内部网页,LINE 只用来发通知。
第 2 层 编排:下一步由谁决定
编排决定是检索文件、调用系统、询问模型,还是交给人处理。工作流引擎按写好的顺序执行,智能体循环(Agent Loop)则让模型自己选择下一步。IT 部门要决定哪项工作用哪一种。每次步骤都相同的工作应当用工作流,便于检查,也节省模型费用。常见的错误是所有工作都交给智能体,而且不限制循环次数。这一层可以部署在公司内部,例如运行在 Kubernetes 上的 LangChain。多个智能体协作的例子,请参阅多智能体业务平台。
第 3 层 模型:云端、私有,还是两者并用
云端一侧是 Claude、GPT 或 Gemini 的企业版,能力强,也不用维护机器,但文本会离开公司。自行部署的一侧是私有化大模型,例如运行在 vLLM 或 Ollama 上的 Llama、Qwen,数据留在公司内部,代价是要维护硬件。IT 部门通过模型路由决定哪项工作交给哪个模型:含客户数据的工作交给公司内部的模型,一般工作交给云端。常见的错误是把代码绑死在一家的模型上。延伸阅读:不要把业务绑在一家 AI 供应商身上和私有 AI 的几种选择。
第 4 层 知识:AI 回答所依据的文件
系统在回答之前先用 RAG 检索文件。文件会先转换成代表语义的数字,即向量嵌入(Embedding),再存入向量数据库。IT 部门要决定哪个版本是正式版本、由谁负责,以及谁可以看到什么。扫描件需要经过 OCR;泰文词与词之间不加空格,因此语义检索应与关键词检索配合使用。常见的错误是把整个共享盘导入知识库,新旧版本混在一起。这一层可以全部部署在公司内部,例如 Elasticsearch 加上自有的向量嵌入模型。
第 5 层 数据与业务系统:API、MCP 和 RPA
AI 访问 ERP、CRM 和财务系统有三种方式。API 是系统为其他程序调用而开放的接口。MCP 把 API 包装起来,让 AI 可以自行选择使用。RPA 则在没有 API 的老系统里代替人操作界面。IT 部门要决定 AI 只能读取还是也能写入,以及每类数据的权威来源在哪里。常见的错误是让 AI 用同一个管理员账号进入所有系统,或者依赖界面一改就停摆的 RPA。即使模型在云端,连接器也应当运行在与 ERP 相同的网络内。延伸阅读:把新应用接入 ERP 和原有数据。
第 6 层 管控:权限、审批与记录
这一层规定谁可以问什么、AI 可以调用哪些工具、哪些工作需要人工审批点、护栏检查什么,并把每一步记入审计日志。它还要防范提示词注入,也就是藏在文件中暗中指挥 AI 的文字。IT 部门要决定 AI 的权限是否与提问的人绑定。通过 Active Directory 绑定后,系统能看到的不会超出提问者本人能看到的范围。常见的错误是在提示词里写一句“不得透露薪资”,就以为已经管住了。管控必须是模型之外的代码,而且始终留在公司这一侧。
第 7 层 效果评估:答得对不对,每项工作花多少
核心做法是用公司实际工作中的真实例子测试系统:上线前测一次,每次更换模型、文件或提示词时再测。旁边再配一个仪表盘,显示需要人工修改的答案和每项工作的成本。IT 部门要在上线前决定由谁确认答案、合格标准是什么。常见的错误是上线之后才开始评估。云端模型按文本量计费,私有化大模型则是固定的机器成本,所以从每项工作的数字就能看出哪些工作应该换到另一侧。
MCP 与 API 的区别
想象一栋办公楼。API 是有编号的房门,开哪扇门、按什么顺序开,由程序员事先写好。MCP 是电梯口的指示牌,写明每个房间负责什么;AI 读了指示牌,再根据问题自己选择房间。
根据官方文档,MCP(Model Context Protocol,模型上下文协议)是把 AI 应用连接到外部系统的开放标准。AI 应用作为主机(Host),为每个服务器(Server)创建一个客户端(Client)。服务器提供三类能力:用于执行操作的 Tools、用于读取的 Resources,以及作为指令模板的 Prompts。每个工具都有名称、说明和所需的数据格式。
目标系统的凭据保存在 MCP 服务器上,模型看不到。大多数 MCP 服务器是包装 ERP 现有的 API,因此原有的 API 可以继续使用,所有支持 MCP 的 AI 应用也都能共用同一个服务器。如果步骤固定,例如每晚把当天的销售额传入财务系统,就由工作流直接调用 API;如果需要 AI 根据问题自行选择系统,就使用 MCP。权限管理仍然是第 6 层的职责。
搭建顺序:从数据往上到界面
很多项目从聊天界面做起,后来才在数据和权限上卡住。更稳妥的顺序是:
1. 选一项工作,在写代码之前先约定由谁确认答案、怎样才算通过(第 7 层)。 2. 决定哪些数据可以离开公司、AI 可以接触哪些系统(第 6 层和第 5 层)。这个答案决定第 3 层和第 4 层放在哪一侧。 3. 为每份文件指定负责人和当前版本(第 4 层)。 4. 选择模型和路由规则(第 3 层)。 5. 先用工作流,再加入智能体循环(第 2 层)。 6. 只开放一个员工已经在用的渠道(第 1 层)。
模拟案例
罗勇府一家汽车零部件工厂(名称和细节均为虚构)希望产线主管随时能查询作业方法和客户规格。按合同,客户的零件图纸不能离开工厂,因此 IT 部门选择在厂内部署私有化大模型。渠道是每条产线平板电脑上的内部网页,LINE 只用来提醒待审批的工作。ERP 通过只读的 MCP 服务器接入,唯一的写入操作是起草不良品报告,并须由质检主管确认。
质检团队用日常工作中的真实问题测试系统。第一轮测试时,系统依据混在资料库里的旧版手册作答。团队于是只保留在用的版本,在每个答案中标明版本号,反复测试到达标后,才向第一条产线开放。
每层一个问题
- 哪一层还答不上来,就先不要往下走。
第 1 层: 将来使用系统的人,今天在哪里输入问题?
第 2 层: 这项工作的步骤是固定的,还是取决于上一步的结果?
第 3 层: 经过模型的数据中,最机密的是哪个级别?
第 4 层: 哪个版本是正式版本,由谁负责?
第 5 层: AI 只读取,还是也写入系统?
第 6 层: AI 出错时,由谁叫停,如何回退?
第 7 层: 由谁确认答案,合格标准是什么?
| 层 | 决定什么 | 云端 | 本地部署 | 常见错误 |
|---|---|---|---|---|
| 1 渠道 | 第一个渠道、身份确认 | LINE OA、网页聊天 | 以 SSO 登录的内部网页 | 不绑定员工账号 |
| 2 编排 | 工作流还是智能体循环 | 云端工作流 | Kubernetes 上的 LangChain | 所有工作都用智能体,不限循环次数 |
| 3 模型 | 哪项工作交给哪个模型 | Claude、GPT、Gemini | vLLM 上的 Llama、Qwen | 代码绑死一家的模型 |
| 4 知识 | 正式版本、负责人、查看权限 | 云端文件检索 | 公司内部的 Elasticsearch | 新旧版本混杂 |
| 5 数据与业务系统 | 只读还是写入、权威来源在哪 | SaaS 连接器 | ERP 旁的 MCP 服务器 | 一个管理员账号进所有系统 |
| 6 管控 | 与提问者绑定的权限、审批点 | 服务商的过滤器 | Active Directory、审计日志 | 用提示词代替管控 |
| 7 效果评估 | 答案确认人、合格标准 | 服务商的报告 | 仪表盘、内部测试 | 上线后才开始评估 |
批准 AI 设计方案前,先查这八项
- 架构图包含全部七层,每层都写明系统或服务商名称
- 标明个人数据在哪些环节离开公司,并对照泰国《个人数据保护法》(PDPA)
- AI 能看到的数据不超出提问者本人的权限
- 写入工具与读取工具分开,并设有审批点
- 审计日志记录实际用户、所调用的工具和结果
- 开始搭建前已约定用真实工作例子测试的方法和合格标准
- 更换模型时不必重建其他层
- 从第一天起就能衡量每项工作的成本
写给开发团队 · MCP 服务器与 REST Endpoint、身份传递和最小权限
REST Endpoint 由按文档编写的代码调用;MCP 服务器则通过 JSON-RPC 2.0 公开工具:客户端先调用 tools/list 取得名称、说明和 inputSchema,再调用 tools/call。工具说明因此会进入模型的上下文,第三方服务器在安装前必须审查。身份传递:服务器依据 SSO 提供的用户身份判断权限,再用颁发给自己的令牌调用下游 API;MCP 规范禁止令牌透传(Token Passthrough)。最小权限:读取工具与写入工具分开,不使用通配符作用域(Wildcard Scope),写入工具须经过审批策略(Approval Policy)或 Elicitation。stdio 服务器应在沙箱中运行,每一次工具调用都连同用户一起记录。
我们如何为在泰企业设计完整的七层 AI 系统
清楚哪份文件是正式版本、谁可以批准什么的,是您的团队。DNA Maker 先与 IT 部门和业务负责人坐下来,在选模型之前,把七层画在一张纸上,标出每个级别的数据经过哪些层、哪些环节需要人工审批。
与您合作的是 DNA Maker 自己的团队,不外包,每周您都能看到演示。数据不能离开公司时,我们用 vLLM 上的 Llama 或 Qwen 部署私有化大模型,并配套 Elasticsearch 和 Active Directory。可以使用云端时,我们把管控层和 MCP 连接器放在您这一侧。审批点和审计日志从第一个版本起就具备。范围和价格在开工前确定,源代码和文档按合同约定的范围交付。这正是我们为银行、医院和泰国大型企业集团所做的工作。请查看私有化大模型和 AI 工作流页面,或在聊天页面向 Dream 提问。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| MCP | 让 AI 应用发现并调用其他系统工具的开放标准 | AI 助手自行决定去 ERP 查库存 | MCP 服务器使用的是谁的权限? |
| RPA | 在没有 API 的系统里代替人操作界面的软件 | 机器人把发票录入旧版财务软件 | 界面改版后由谁修复? |
| 向量嵌入 | 代表文本语义的数字,用于按语义检索 | 问“产假”,能找到“生育假期”那一条 | 嵌入模型在哪里运行,读泰文的效果如何? |
| 模型路由 | 按难度和机密程度把工作分派给合适的模型 | 含客户姓名的问题交给公司内部的模型 | 谁可以修改路由规则? |