- 사내 AI 시스템에는 7개 계층이 있습니다. 회사가 직접 정하지 않은 계층은 벤더가 대신 정합니다.
- 클라우드냐 사내 설치냐는 계층마다 따로 정할 수 있습니다. 다만 권한을 관리하고 기록을 남기는 계층은 귀사 쪽에 두어야 합니다.
- 업무 하나를 고르고, 무엇을 합격으로 볼지 먼저 정한 뒤, 데이터부터 위로 쌓아 올립니다.
AI 시스템 하나에는 7개 계층이 있습니다
새 지점을 연다고 생각해 보십시오. 매장, 관리자, 직원, 서류함, 창고와 이어진 직통 회선, 승인 규칙, 월말 보고서가 필요합니다. AI 시스템에도 같은 부품이 모두 있고, 각 부품을 클라우드로 빌릴지 온프레미스로 사내에 설치할지 고를 수 있습니다.
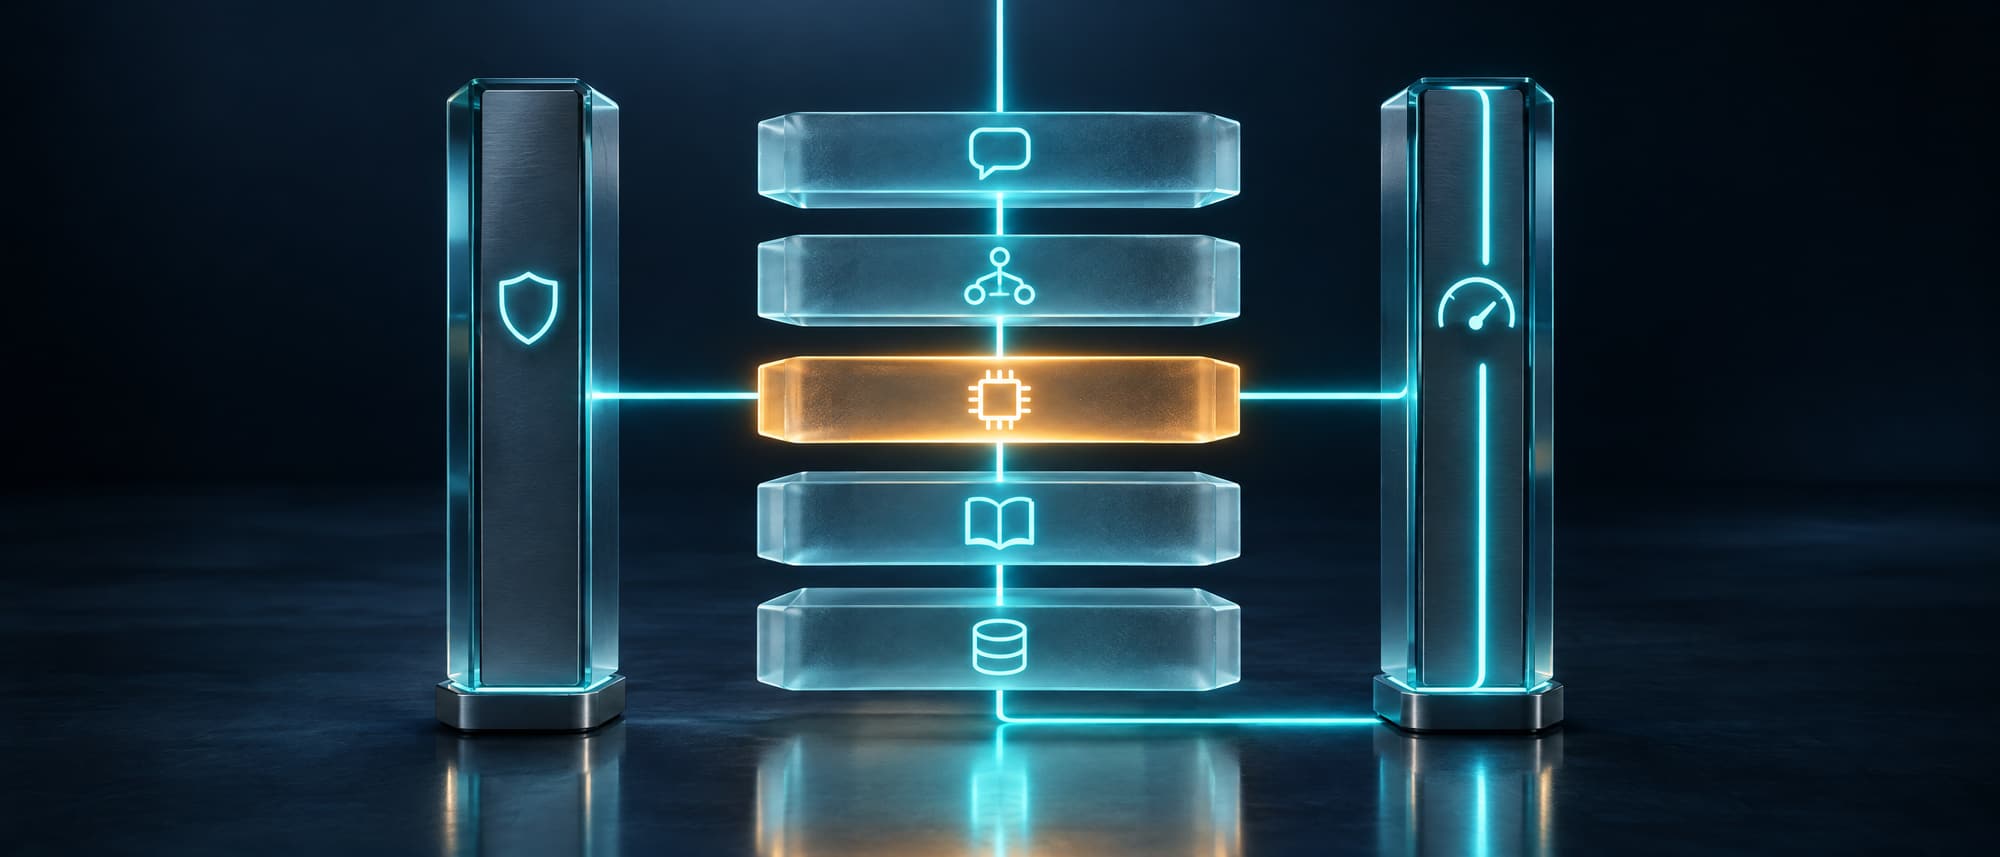
이 장의 그림은 위에서 아래로 쌓인 5개 계층입니다. 채널, 오케스트레이션, 모델, 지식, 데이터와 업무 시스템입니다. 그리고 모든 계층에 닿는 기둥 두 개, 통제와 성과 측정이 있습니다. 질문은 데이터를 향해 아래로 흐르고, 답은 계층을 지날 때마다 통제 기둥을 거쳐 위로 돌아옵니다.
1계층 채널: 사람이 질문을 입력하는 곳
채널은 LINE, 웹, 앱, 이메일입니다. IT 부서는 어느 채널부터 열지, 입력하는 사람이 누구인지 어떻게 확인할지 정합니다. 첫 채널로는 직원들이 이미 쓰는 곳이 좋습니다. 흔한 실수는 직원 계정과 연결되지 않은 채널을 고르는 것입니다. 그러면 시스템은 누구에게 무엇을 보여 줘야 하는지 알 수 없습니다. LINE 메시지는 항상 LINE 서버를 거칩니다. 데이터가 회사 밖으로 나가면 안 된다면 SSO로 로그인하는 사내 웹을 쓰고, LINE은 알림에만 씁니다.
2계층 오케스트레이션: 다음 단계를 누가 정하는가
오케스트레이션은 문서를 검색할지, 시스템을 호출할지, 모델에 물을지, 사람에게 넘길지를 정합니다. 워크플로 엔진은 정해진 순서를 따르고, 에이전트 루프는 모델이 다음 단계를 직접 고르게 합니다. IT 부서는 어떤 업무에 어느 쪽을 쓸지 정합니다. 단계가 매번 같은 업무는 워크플로로 만듭니다. 점검하기 쉽고 모델 비용도 줄어듭니다. 흔한 실수는 반복 횟수 제한 없이 모든 업무를 에이전트로 돌리는 것입니다. 이 계층은 사내에 둘 수 있습니다. 예를 들면 Kubernetes 위의 LangChain입니다. 여러 에이전트를 함께 쓰는 사례는 멀티 에이전트 비즈니스 플랫폼에서 보실 수 있습니다.
3계층 모델: 클라우드, 프라이빗, 또는 둘 다
클라우드 쪽에는 Claude, GPT, Gemini의 기업용 플랜이 있습니다. 성능이 좋고 장비를 관리할 필요가 없지만, 글이 회사 밖으로 나갑니다. 직접 운영하는 쪽에는 vLLM이나 Ollama 위의 Llama, Qwen 같은 프라이빗 LLM이 있습니다. 데이터는 회사 안에 남고, 대신 하드웨어를 관리해야 합니다. IT 부서는 모델 라우팅으로 어떤 업무를 어떤 모델에 보낼지 정합니다. 고객 데이터가 담긴 업무는 사내 모델로, 일반 업무는 클라우드로 보냅니다. 흔한 실수는 코드를 한 회사의 모델에 묶어 두는 것입니다. 자세한 내용은 AI 공급사 한 곳에 사업을 묶지 마십시오와 프라이빗 AI라는 선택지를 참고하십시오.
4계층 지식: AI가 답할 때 쓰는 문서
시스템은 답하기 전에 RAG로 문서를 검색합니다. 문서는 의미를 나타내는 숫자, 곧 임베딩으로 바뀌어 벡터 데이터베이스에 저장됩니다. IT 부서는 어느 판이 정본인지, 누가 관리하는지, 누가 무엇을 볼 수 있는지 정합니다. 스캔한 서류는 OCR을 거쳐야 합니다. 또 태국어 문서는 단어 사이를 띄어 쓰지 않으므로, 의미 검색과 단어 검색을 함께 씁니다. 흔한 실수는 공유 드라이브를 통째로 넣어 옛 판과 새 판이 섞이는 것입니다. 이 계층은 전부 사내에 둘 수 있습니다. 예를 들면 Elasticsearch와 자체 임베딩 모델입니다.
5계층 데이터와 업무 시스템: API, MCP, RPA
AI가 ERP, CRM, 회계 시스템에 접근하는 방법은 세 가지입니다. API는 시스템이 다른 프로그램의 호출을 받으려고 열어 둔 창구입니다. MCP는 API를 감싸 AI가 스스로 골라 쓸 수 있게 합니다. RPA는 API가 없는 오래된 시스템에서 사람 대신 화면을 조작합니다. IT 부서는 AI에게 읽기만 허용할지 쓰기까지 허용할지, 데이터마다 원본이 어디에 있는지 정합니다. 흔한 실수는 관리자 계정 하나로 모든 시스템에 들어가게 하는 것, 그리고 화면이 바뀔 때마다 멈추는 RPA에 기대는 것입니다. 연결 부분은 모델이 클라우드에 있더라도 ERP와 같은 네트워크 안에서 돌립니다. 자세한 내용은 새 앱을 ERP와 기존 데이터에 연결하는 방법을 참고하십시오.
6계층 통제: 권한, 승인, 기록
이 계층은 누가 무엇을 물을 수 있는지, AI가 어떤 도구를 호출할 수 있는지, 어떤 업무에 승인 지점이 필요한지, 가드레일이 무엇을 검사하는지 정하고, 모든 단계를 감사 로그에 남깁니다. 문서 속에 숨어 AI에게 몰래 지시하는 프롬프트 인젝션을 막는 것도 이 계층입니다. IT 부서는 AI의 권한을 질문한 사람과 연결할지 정합니다. Active Directory로 연결하면 시스템은 질문한 사람이 볼 수 있는 범위를 넘지 않습니다. 흔한 실수는 프롬프트에 "급여를 공개하지 말 것"이라고 쓰고 통제했다고 여기는 것입니다. 통제는 모델 밖의 코드로 해야 하며, 항상 귀사 쪽에 있어야 합니다.
7계층 성과 측정: 답이 맞는가, 건당 얼마인가
핵심은 회사의 실제 업무 사례로 하는 테스트입니다. 가동 전에 하고, 모델이나 문서, 프롬프트를 바꿀 때마다 다시 합니다. 여기에 사람이 고친 답과 건당 비용을 보여 주는 대시보드를 함께 둡니다. IT 부서는 가동 전에 누가 답을 확인하는지, 합격 기준이 무엇인지 정합니다. 흔한 실수는 가동한 뒤에야 측정을 시작하는 것입니다. 클라우드 모델은 글의 양에 따라 비용이 붙고, 프라이빗 LLM은 장비 고정비입니다. 그래서 건당 수치를 보면 어떤 업무를 어느 쪽으로 옮겨야 할지 알 수 있습니다.
MCP와 API의 차이
사무실 건물을 떠올려 보십시오. API는 번호가 붙은 방문입니다. 어느 문을 어떤 순서로 열지는 프로그래머가 미리 적어 둡니다. MCP는 엘리베이터 앞의 안내판입니다. 방마다 무엇을 하는지 적혀 있고, AI가 이를 읽고 질문에 맞춰 직접 방을 고릅니다.
공식 문서에 따르면 MCP(Model Context Protocol)는 AI 애플리케이션을 외부 시스템에 연결하는 개방형 표준입니다. AI 애플리케이션이 호스트가 되어 서버 하나마다 클라이언트를 하나씩 만듭니다. 서버는 작업을 위한 Tools, 읽기를 위한 Resources, 지시문 틀인 Prompts를 제공합니다. 도구마다 이름, 설명, 받아야 할 데이터 형식이 있습니다.
대상 시스템의 인증 정보는 MCP 서버가 갖고 있고, 모델은 이를 보지 못합니다. 대부분의 MCP 서버는 ERP의 기존 API를 감싸는 방식이라, 지금 있는 API를 그대로 계속 쓸 수 있습니다. MCP를 지원하는 AI 애플리케이션이라면 어느 것이든 같은 서버를 쓸 수 있습니다. 매일 밤 그날 매출을 회계 시스템에 보내는 것처럼 단계가 정해진 일은 워크플로에서 API를 직접 호출합니다. 질문에 따라 AI가 시스템을 골라야 한다면 MCP를 씁니다. 권한 관리는 여전히 6계층의 몫입니다.
구축 순서: 데이터에서 화면으로
많은 프로젝트가 채팅 화면부터 시작했다가 나중에 데이터와 권한에서 막힙니다. 더 안전한 순서는 다음과 같습니다.
1. 업무 하나를 고르고, 코드를 쓰기 전에 누가 답을 확인하고 무엇을 합격으로 볼지 정합니다(7계층). 2. 어떤 데이터가 회사 밖으로 나가도 되는지, AI가 어떤 시스템을 건드리는지 정합니다(6계층과 5계층). 이 답에 따라 3계층과 4계층을 어느 쪽에 둘지 정해집니다. 3. 문서마다 관리자와 최신판을 정합니다(4계층). 4. 모델과 라우팅 규칙을 고릅니다(3계층). 5. 워크플로로 시작하고, 나중에 에이전트 루프를 더합니다(2계층). 6. 직원들이 이미 쓰는 채널 하나만 엽니다(1계층).
가상 사례
라용의 자동차 부품 공장(회사명과 세부 내용은 가상입니다)은 라인 반장이 작업 방법과 고객 사양을 바로 물어볼 수 있기를 원했습니다. 고객의 부품 도면은 계약상 공장 밖으로 나갈 수 없습니다. 그래서 IT 부서는 공장 안에 프라이빗 LLM을 두었습니다. 채널은 라인마다 놓인 태블릿의 사내 웹이고, LINE은 승인 대기 작업만 알립니다. ERP는 읽기 전용 MCP 서버로 연결했고, 쓰기 작업은 품질관리 책임자가 확인해야 하는 불량 보고서 초안 하나뿐입니다.
품질관리 팀은 실제 업무에서 나온 질문으로 시스템을 테스트했습니다. 첫 테스트에서 시스템은 자료실에 섞여 있던 옛 매뉴얼로 답했습니다. 팀은 사용 중인 판만 남기고, 모든 답에 판 번호를 표시하고, 기준을 통과할 때까지 다시 테스트한 뒤에 첫 라인에 열었습니다.
계층마다 질문 하나
- 답하지 못한 계층이 있으면 다음으로 넘어가지 마십시오.
1계층: 시스템을 쓸 사람들은 지금 어디에 질문을 입력합니까?
2계층: 이 업무의 단계는 정해져 있습니까, 아니면 앞 단계의 결과에 따라 달라집니까?
3계층: 모델을 거치는 데이터 중 기밀성이 가장 높은 것은 어느 수준입니까?
4계층: 어느 판이 정본이고, 누가 관리합니까?
5계층: AI는 읽기만 합니까, 아니면 시스템에 쓰기도 합니까?
6계층: AI가 잘못하면 누가 멈추고, 어떻게 되돌립니까?
7계층: 누가 답을 확인하고, 합격 기준은 무엇입니까?
| 계층 | 정할 것 | 클라우드 | 온프레미스 | 흔한 실수 |
|---|---|---|---|---|
| 1 채널 | 첫 채널, 본인 확인 | LINE OA, 웹 채팅 | SSO로 로그인하는 사내 웹 | 직원 계정과 연결하지 않음 |
| 2 오케스트레이션 | 워크플로냐 에이전트 루프냐 | 클라우드 워크플로 | Kubernetes 위의 LangChain | 모든 업무를 에이전트로, 반복 제한 없음 |
| 3 모델 | 어떤 업무를 어떤 모델로 | Claude, GPT, Gemini | vLLM 위의 Llama, Qwen | 코드를 한 회사 모델에 묶음 |
| 4 지식 | 정본, 관리자, 열람 권한 | 클라우드 문서 검색 | 사내 Elasticsearch | 옛 판과 새 판이 섞임 |
| 5 데이터와 업무 시스템 | 읽기냐 쓰기냐, 원본 위치 | SaaS 커넥터 | ERP 옆의 MCP 서버 | 관리자 계정 하나로 전부 접근 |
| 6 통제 | 질문자와 연결된 권한, 승인 지점 | 사업자의 필터 | Active Directory, 감사 로그 | 프롬프트로 통제를 대신함 |
| 7 성과 측정 | 답 확인자, 합격 기준 | 사업자의 보고서 | 대시보드, 사내 테스트 | 가동 후에야 측정 시작 |
AI 설계를 승인하기 전에 확인할 8가지
- 도면에 7개 계층이 모두 있고, 계층마다 시스템이나 공급사 이름이 적혀 있음
- 개인정보가 회사 밖으로 나가는 지점이 태국 개인정보보호법(PDPA)에 비추어 표시되어 있음
- AI는 질문한 사람의 권한을 넘는 데이터를 볼 수 없음
- 쓰기 도구가 읽기 도구와 분리되어 있고, 승인 지점이 있음
- 감사 로그에 실제 사용자, 호출한 도구, 결과가 남음
- 구축을 시작하기 전에 실제 업무 사례로 테스트할 방법과 합격 기준이 정해져 있음
- 다른 계층을 다시 만들지 않고 모델을 바꿀 수 있음
- 첫날부터 건당 비용을 측정할 수 있음
개발팀 참고 · MCP 서버와 REST 엔드포인트, ID 전파, 최소 권한
REST 엔드포인트는 문서를 보고 작성한 코드가 호출합니다. MCP 서버는 JSON-RPC 2.0으로 도구를 공개하며, 클라이언트는 tools/list로 이름, 설명, inputSchema를 받은 뒤 tools/call을 호출합니다. 도구 설명이 모델의 컨텍스트에 들어가므로, 외부 서버는 설치 전에 검토해야 합니다. ID 전파: 서버는 SSO에서 받은 사용자 ID로 권한을 판단하고, 대상 API는 자신에게 발급된 토큰으로 호출합니다. MCP 사양은 토큰 패스스루를 금지합니다. 최소 권한: 읽기 도구와 쓰기 도구를 나누고, 와일드카드 스코프를 쓰지 않으며, 쓰기 도구는 승인 정책이나 Elicitation을 거치게 합니다. stdio 서버는 샌드박스에서 돌리고, 모든 도구 호출을 사용자와 함께 기록합니다.
저희가 태국 법인을 위해 7개 계층을 설계하는 방식
어느 문서가 정본인지, 누가 무엇을 승인할 수 있는지 아는 사람은 귀사의 팀입니다. DNA Maker는 먼저 IT 부서, 업무 책임자와 함께 앉아 모델을 고르기 전에 7개 계층을 종이 한 장에 그립니다. 어느 수준의 데이터가 어느 계층을 지나는지, 어디서 사람이 승인해야 하는지도 적어 넣습니다.
귀사와 일하는 팀은 DNA Maker 자체 팀이며 하청을 주지 않습니다. 매주 데모를 보실 수 있습니다. 데이터가 회사 밖으로 나갈 수 없다면 vLLM 위의 Llama나 Qwen으로 프라이빗 LLM을 구축하고, Elasticsearch와 Active Directory를 함께 설치합니다. 클라우드를 쓸 수 있다면 통제 계층과 MCP 연결 부분을 귀사 쪽에 둡니다. 승인 지점과 감사 로그는 첫 버전부터 들어갑니다. 범위와 가격은 착수 전에 확정하고, 소스 코드와 문서는 계약 범위에 따라 납품합니다. 저희가 은행, 병원, 태국 대기업 그룹에 제공하는 종류의 일입니다. 프라이빗 LLM과 AI 워크플로우 페이지에서, 또는 채팅 페이지의 Dream에게 문의해 주십시오.
SOFTWARE ENGINEERING GLOSSARY
소프트웨어 엔지니어링 용어집
| 용어 | 의미 | 쉬운 예시 | 개발팀에 물어봐야 할 질문 |
|---|---|---|---|
| MCP | AI 애플리케이션이 다른 시스템의 도구를 찾아 호출하게 하는 개방형 표준 | AI 비서가 스스로 판단해 ERP 재고를 확인 | MCP 서버는 누구의 권한으로 움직입니까? |
| RPA | API가 없는 시스템에서 사람 대신 화면을 조작하는 소프트웨어 | 봇이 청구서를 오래된 회계 프로그램에 입력 | 화면이 바뀌면 누가 고칩니까? |
| 임베딩 | 의미 검색에 쓰는, 글의 의미를 나타내는 숫자 | "출산휴가"를 물으면 "출산을 위한 휴가" 조항을 찾음 | 임베딩 모델은 어디서 돌고, 태국어를 얼마나 잘 읽습니까? |
| 모델 라우팅 | 난이도와 기밀성에 따라 업무를 알맞은 모델로 보내는 방식 | 고객 이름이 든 질문은 사내 모델로 보냄 | 라우팅 규칙은 누가 바꿀 수 있습니까? |