
- 不必第一天就上大系统。先从一项能衡量效果的工作做起,更稳妥。
- 行之有效的顺序是:先把问题答准,再让系统动手办事,然后才扩展到更多工作。
- 整个过程中要一直盯住的指标只有一个:从头到尾把事情办成的客户有没有变多。
传统网站和应用做不到的地方
很多公司一开始在屏幕角落放了个聊天机器人,然后一停就是好几年,因为它能回答问题,却从来没有真正办完过一件事。所以该问的问题是“现在有百分之几的客户能把事情从头办到尾”,“还能在哪里加 AI”反倒是次要的。
很多企业从一个聊天框起步,看演示答得不错,就急着接上各种操作,可测试集、唯一可信数据源(Source of Truth)和审批规则都还没有,结果试点始终不敢正式上线。
不少组织手上的聊天机器人演示能回答问题,却走不下去,因为数据负责人、API、权限、效果衡量,以及系统出错时的应对计划,一样都还没有。从对话直接跳到替人干活的 AI 智能体(AI Agent),风险增长得比准备工作快,团队最后错误地认定 AI 在实际工作中用不了。
写给开发团队 · 技术细节
好的 Roadmap 要一级一级地增加能力和责任:从 Search 和 Answer 开始,再到 Assist、Recommend、Reversible Action 和 Orchestration。每一级都有自己的 Outcome、Guardrail 和 Evidence,企业因此可以按问题投入,用不着先建一个大平台,再等将来的 Use Case。
| 传统模式 | 新一代 AI 产品模式 |
|---|---|
| 选一个模型,写好提示词(Prompt),开放给用户提问 | 先设计完整的产品循环(Product Loop),包括意图、上下文、工具、审批、操作、反馈、评测和监控,再一级一级地提高自主程度(Autonomy) |
写给开发团队 · 技术细节
Roadmap 的每一级都要共用同一套 Foundation:Identity、Knowledge、API、Policy、Evaluation 和 Monitoring。把这几层和模型分开,产品就能更换技术、增加 Action,而不必推翻整个 Journey。
企业可以用上的新能力
稳妥的路线是一步一步来。先让系统把有明确答案的问题答准;答准了,再让它去办可以撤回的事,比如预约,或者出具文件草稿;等证明管得住了,再扩展到涉及钱或合同的工作。
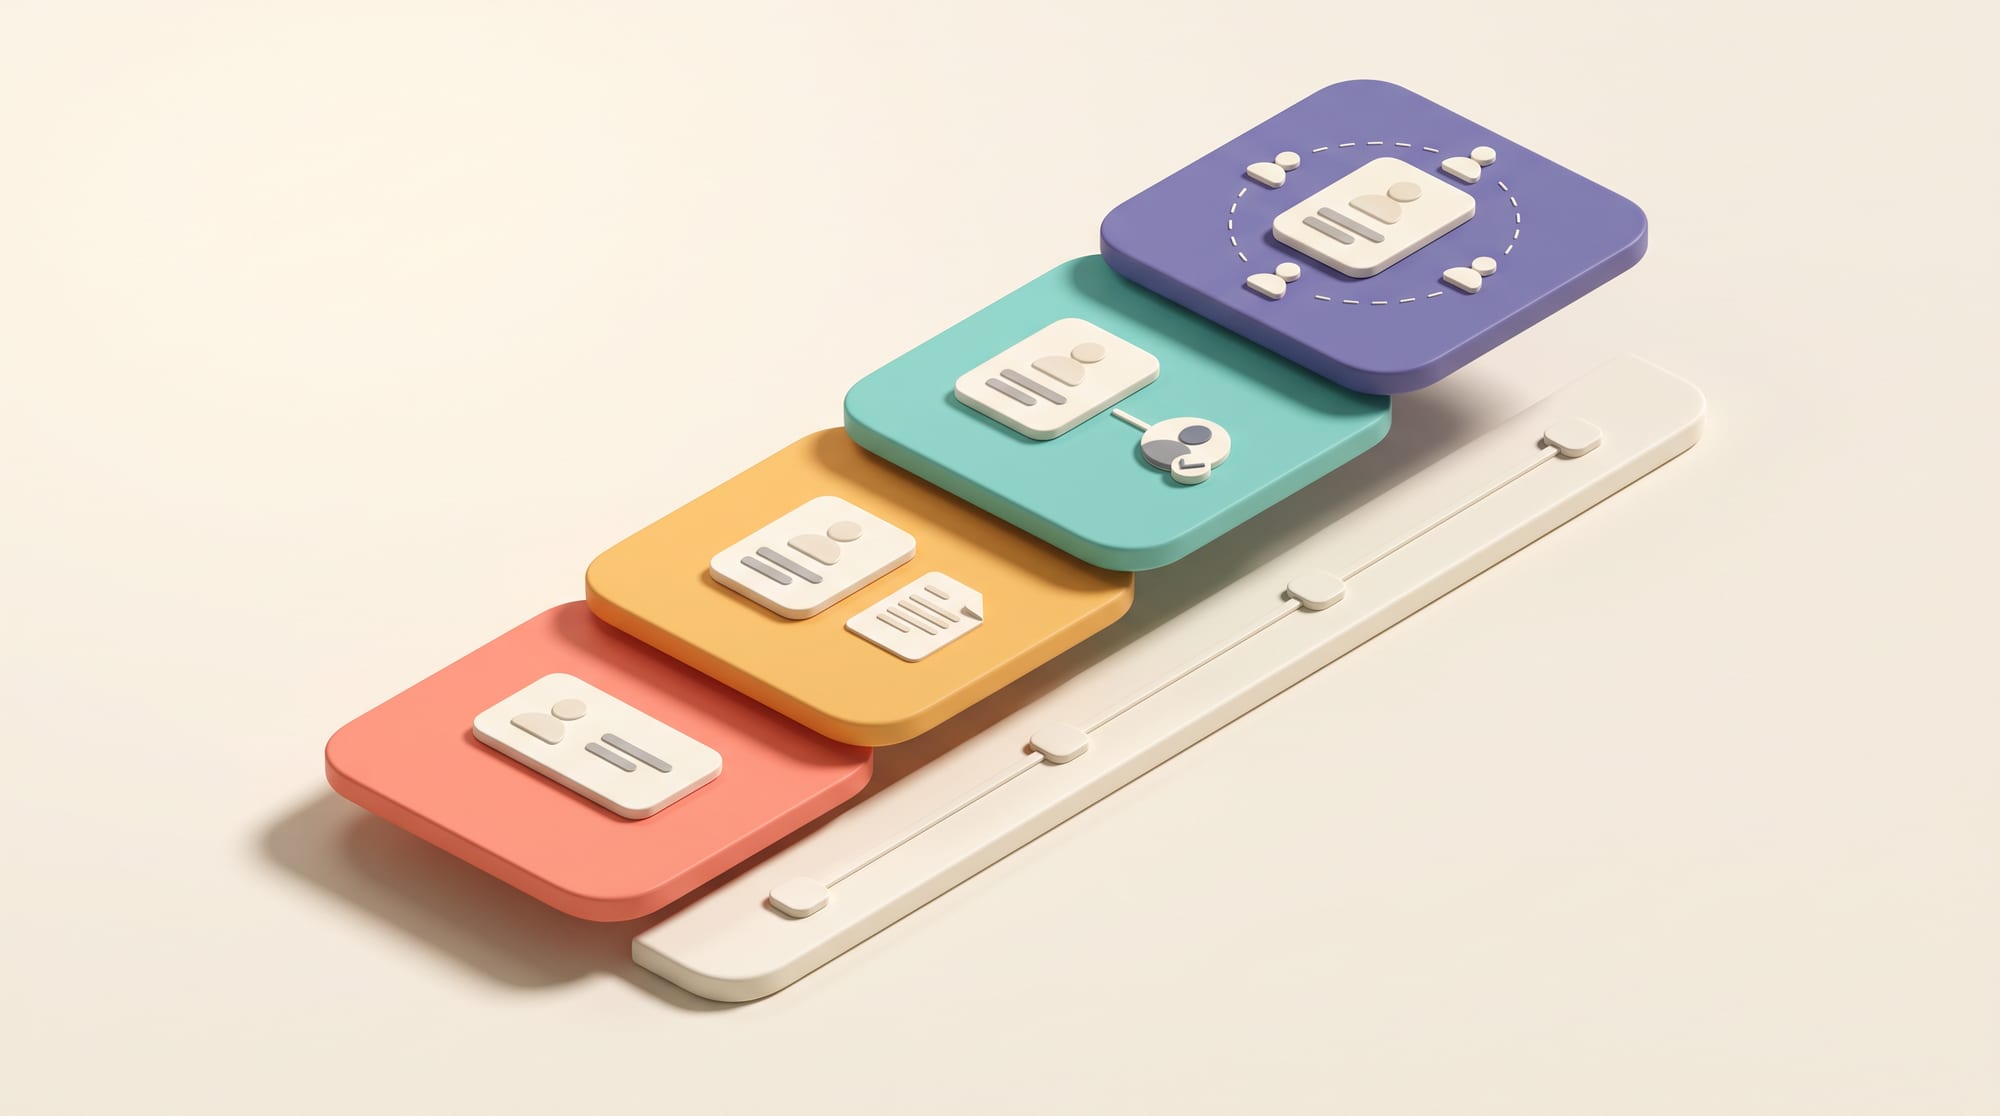
路线图概览
第一级让数据可以检索、可以引用。下一级帮忙起草或总结,由人检查。之后再接入工具,让系统执行可以撤回的操作,最后才增加跨多个步骤或多个智能体的协调。跳级并不总是错的,但前面几级的基础必须已经在系统里打好。
需要逐步积累的能力
每个阶段都要补上知识归属、身份、权限、工具约定、评测、审批、监控和反馈循环,光加提示词是不够的。随着自主程度提高,用户这一侧的功能可以从单纯给出答案,逐步变成引导式工作区、操作中心和异常队列(Exception Queue)。
可重复使用的技术组件
架构上应把网页与移动端体验、后端与 API、知识库、智能体运行环境(Agent Runtime)、策略、评测和可观测性分开,这样更换模型或扩展应用场景时就不必全部推倒重来。AI 自主开发(AI Autonomous Development)可以加快原型、代码和测试的进度,但必须在清晰的架构、审查和安全规范之下进行。
分阶段推进的好处
管理层看得到每一笔投入回答的是什么问题。团队可以从试点中学习,不必把重要流程交给还没经过验证的系统,已经做好的组件也能用在下一个应用场景上。有了路线图,当数据、价值或准备程度不够时,也能有理有据地决定停下来。
- 第 1 级 回答(Answer):依据可以引用的来源作答
- 第 2 级 辅助(Assist):起草或给出建议,由人点击执行
- 第 3 级 审批后执行(Act with Approval):准备好操作,再申请审批
- 第 4 级 有边界的自主(Bounded Autonomy):在限定范围内处理标准个案,并留有审计记录
模拟案例
实际使用场景
一家企业的排期智能体先从建议模式起步,接着让它创建预约草稿,等重复预约、时区、取消和权限这些情况都通过测试集之后,才开放真正的确认预约。
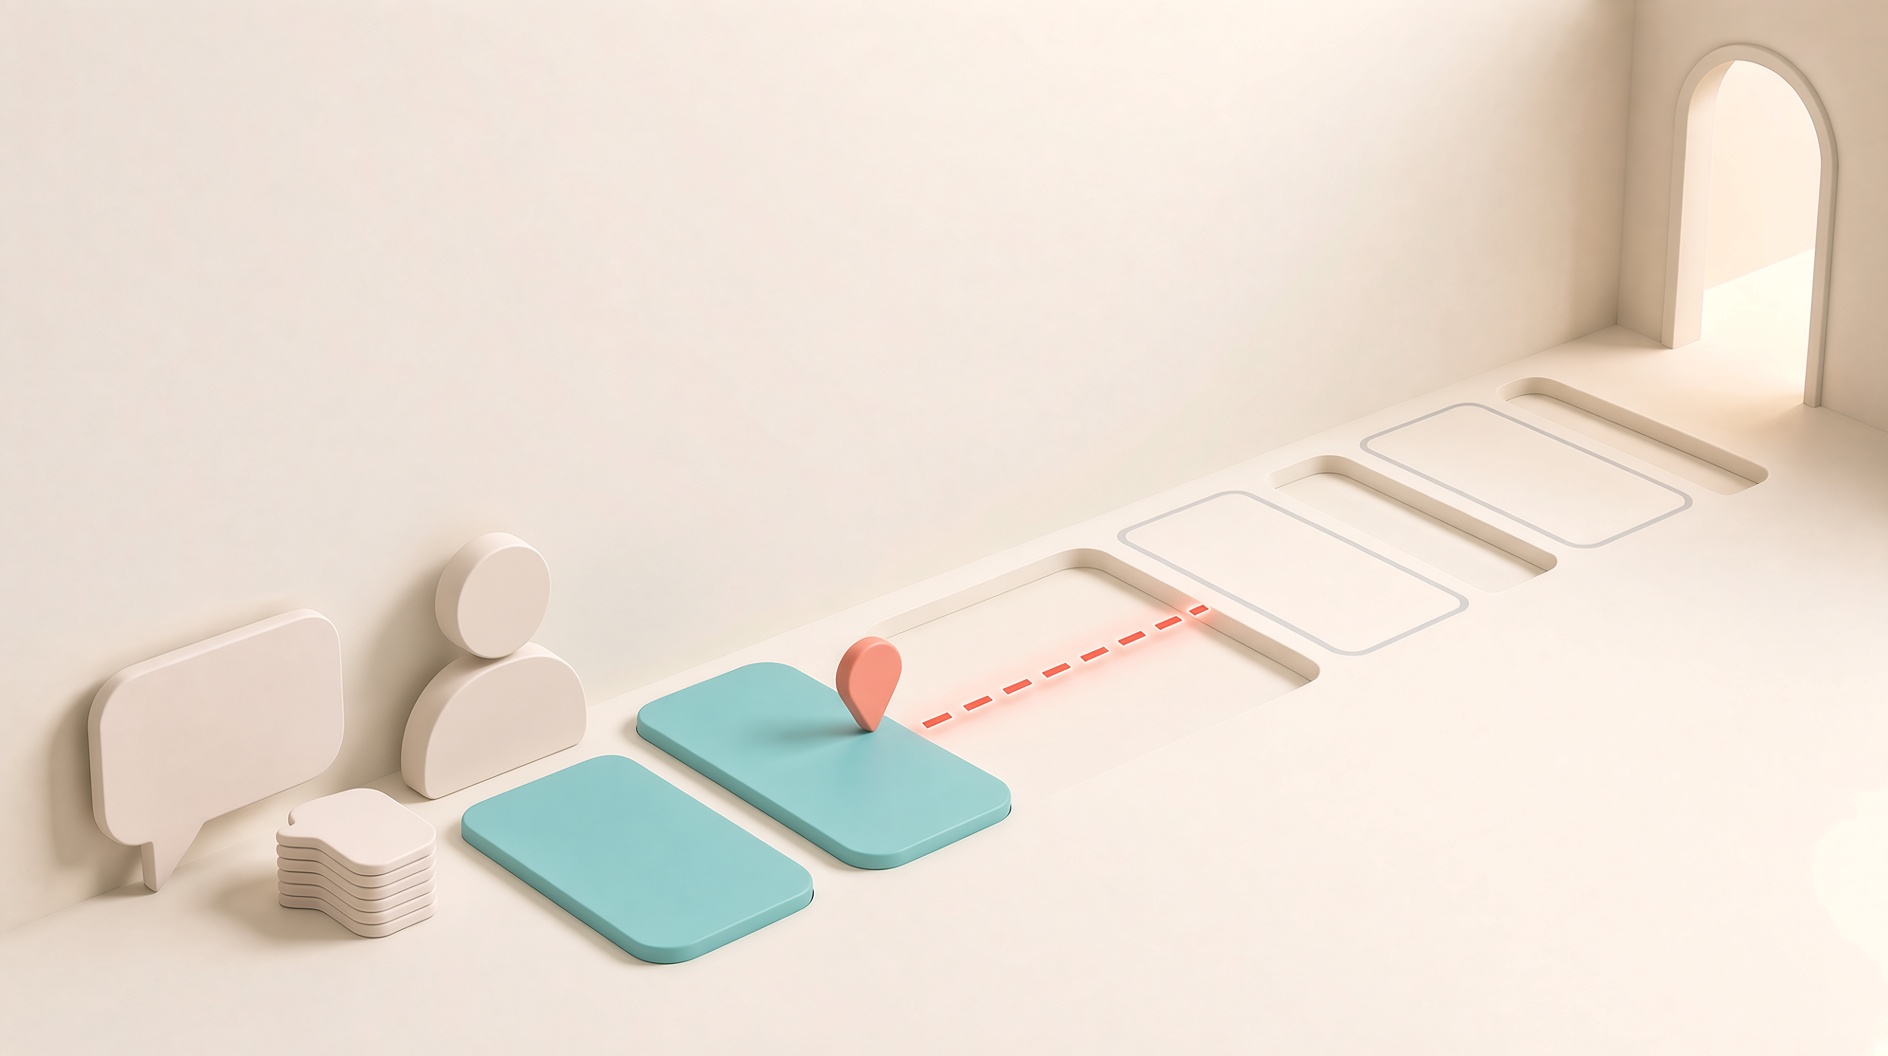
在一个模拟案例中,一家零售企业先上线回答退货政策、并注明出处的助手。第二阶段让它汇总订单状态,由员工检查。第三阶段允许客户重新选择配送时段,这一步可以撤回。再往后的阶段,才让它协调库存、物流和通知。
每个阶段的通过标准各不相同,比如回答准不准确、交接信息全不全、操作成功率多高、有没有重复操作。对接的系统一旦宕机,就退回到只提供信息,或者转交给人处理,不会因为最聪明的那部分用不了,就让整条使用路径停摆。
范围、风险与效果评估
写给开发团队 · 技术指标
衡量 Roadmap,不应看 Use Case 的数量,也不应看达到的最高 Autonomy 级别。要衡量 Outcome、Adoption、Error Impact、Recovery、Cost per Successful Task,以及上线后的运维负担。每个 Pilot 都必须有 Stop/Go Criteria,以及有权修改 Process 的负责人,否则系统会卡在 Demo 和 Production 之间。
不要在没有抽象层的情况下把产品绑死在一个模型上,不要给 AI 范围过宽的凭证,也不要在算清成本与结果之前就扩大规模。
写给开发团队 · 技术指标
应跟踪的指标:Accepted Outcome、Tool Success、Approval Rate、Rollback、Incident、Latency 和 Total Cost
- Discover:跟进实际工作,收集常规情况和例外情况的样本
- Assist:让 AI 起草或给出建议,由人保持控制
- Act:测试集通过后,一次只开放一个工具
- Scale:监控、后备方案(Fallback)、成本和负责人都到位后,再扩大范围
试点没有负责人、数据不稳定、每项任务的成本超出上限,或者老错误又冒出来却没人发现,这时就该停止扩展。回头修补基础本身就是进展,算不上从 AI 退缩。
BUSINESS & PRODUCT READINESS
先打好产品基础,再提高自主程度,免得试点停留在演示阶段
写给开发团队 · 技术细节
先做 Capability Inventory:Model 理解什么、数据从哪里来、Tool 做什么、权限在谁手里、结果能不能撤回。然后按 Value、Feasibility、Risk 和 Reversibility 给 Use Case 排序。数据还不清楚的工作,不要一开始就上高 Level。
写给开发团队 · 技术细节
开放 Action 之前先建好 Evaluation Set,覆盖 Happy Path、数据不完整、Prompt Injection、Tool Error、Duplicate 和 Permission Test。把 Owner、Incident 处理、Cost Budget 和 Model Change Process 都定下来。用 AI 的产品必须持续测试,因为模型、数据和用户行为都会变。
写给开发团队 · 技术指标
用 Capability Inventory 盘点组织目前在数据、API、Identity、Owner 和效果衡量上处于什么水平,再给每个 Use Case 匹配合适的 Autonomy 级别。无法撤回或涉及高级权限的工作,可以永久保留 Human Approval,没必要做到 Fully Autonomous。
写给开发团队 · 技术细节
从一开始就用常规个案、缺失数据、Prompt Injection、Tool Error、重复指令和例外情况建立 Evaluation Set,并估算运行和运维成本。知道怎样发现质量下降,和证明 Prototype 在演示当天能跑起来同样重要。
第一个要达成的结果是什么?
自主程度到哪一级最合适?
哪些操作无法撤回?
质量下降时,我们怎么知道?
先找对问题,再决定需要多少智能
DNA Maker 根据企业主真实的流程和数据,帮助绘制 AI 机会与自主程度地图(AI Opportunity/Autonomy Map)。我们会分清哪些需求该做成网站、应用、工作流、知识检索还是智能体,并在选择技术之前定好护栏(Guardrail)和价值假设。
在产品探索(Product Discovery)阶段,我们制作用户旅程、几套架构方案、数据与系统集成图和原型,拿去给用户和有决定权的人测试。试点要能回答业务问题,并设有继续或叫停的标准,单纯展示模型能力是不够的。
DNA Maker 从真实流程出发,协助绘制 AI 机会和自主程度地图,再设计一套可以持续扩建的产品基础,从数据与系统集成、UX、架构、护栏一直到评测。我们不会把每个问题都硬塞给智能体;如果 Web 应用、工作流或检索是更简单、也更负责任的答案,我们就会这样建议。
选定试点之后,我们可以开发原型、网页和移动端、后端、AI 智能体、工具、审批、监控和运维文档,并用 AI 自主开发加快进度,全程由工程师审查。如果您手上有一长串想法,可以带上流程、样本数据和顾虑,我们一起排出优先级,筛到第一个可以衡量效果、又能为下一阶段打基础的项目。
工程团队能开发网页、移动端和后端系统、AI 智能体、工具和 API、人工审批、评测、可观测性和后台运维功能,一直做到生产环境,并在代码审查、测试和安全规范的约束下,用 AI 自主开发加快进度。
如果您想法很多,却不知道该从哪里开始,可以带上流程、样本数据和顾虑来聊。DNA Maker 会帮您把这些想法收窄成一个目标清楚、效果可衡量的试点,也不会把组织绑在尚未验证的方案上。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
最后这组术语把智能体式产品(Agentic Product)的概念,和自主程度、测试集、后备方案以及模型解耦联系起来。规划路线图时可以把这些术语当作共同语言,让路线图既能更换供应商,也能负责任地增加应用场景。
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| Agentic Product | 由 AI 在限定范围内规划步骤、使用工具的产品。AI 借助工具、规则和跟踪机制规划或执行多个步骤,能做的事远比一个只会生成文字的聊天界面多。 | 智能体准备好预约,再请人确认 | 结果和边界由谁负责? |
| Autonomy | 系统可以自主行动的程度。应当按每种操作分别设定,因为同一个系统可能可以自动回答问题,但修改数据或办理交易之前仍要经人审批。 | 处理标准个案时,不必每一步都等人确认 | 要通过哪些证据,才能提高自主程度? |
| Evaluation Set | 用来反复检验质量的一组样例。评测集里要有常规个案、缺失数据、例外情况和攻击样本,并附上专家认可的答案或评判标准。 | 常规个案、高风险个案和数据不完整的个案 | 真实的例外情况都覆盖到了吗? |
| Fallback | AI 或工具出故障时的备用路线。后备方案必须保住工作进度和上下文,比如切换到人工流程或转交给人;只弹出一句“系统故障”是不够的。 | 把工作转入人工队列,数据一点不丢 | 团队演练过后备方案吗? |
| Model Abstraction | 把产品和模型供应商隔开的一层。产品逻辑因此不依赖具体的模型供应商,更换模型版本、控制成本、测试替代方案时,对系统的影响都会更小。 | 更换模型,不用重建工作流 | 不同模型在质量和成本上的差异,怎样测试? |
延伸阅读(原始文档):https://openai.github.io/openai-agents-js/