
- 첫날부터 큰 시스템으로 뛰어들 필요는 없습니다. 성과를 잴 수 있는 업무 하나로 시작하는 편이 더 안전합니다.
- 먼저 질문에 정확히 답하게 하고, 그다음 시스템이 직접 일을 처리하게 한 뒤, 여러 업무로 넓히는 순서가 효과적입니다.
- 내내 지켜볼 지표는 고객이 용무를 끝까지 마치는 경우가 늘었는지 하나면 됩니다.
기존 웹사이트와 앱은 어디에서 멈춰 있을까
많은 회사가 화면 구석에 챗봇을 달아 두는 것으로 시작해 몇 년째 그 자리에 머뭅니다. 질문에는 답하지만 용무 하나를 끝까지 처리해 준 적은 없기 때문입니다. 그래서 물어야 할 질문은 "AI를 어디에 더 넣을까"보다 "지금 고객은 용무를 몇 퍼센트나 끝까지 마치는가"입니다.
많은 기업이 채팅창으로 시작한 뒤, 데모 답변이 괜찮으니 서둘러 실행 기능을 붙입니다. 하지만 테스트 세트도, 기준 원본 데이터(Source of Truth)도, 승인 규칙도 아직 없으니 시범 운영을 실제로 열 엄두를 내지 못합니다.
질문에 답하는 챗봇 데모는 있지만 더 나아가지 못하는 조직이 많습니다. 데이터 책임자, API, 권한, 성과 측정, 시스템이 틀렸을 때의 대응 계획이 아직 없기 때문입니다. 대화에서 곧바로 사람 대신 일하는 에이전트로 건너뛰면 위험이 준비보다 빨리 커지고, 팀은 AI를 실제로 쓸 수 없다고 잘못 결론 내립니다.
개발팀 참고 · 기술 세부 사항
좋은 Roadmap은 기능과 책임을 한 단계씩 늘립니다. Search와 Answer에서 시작해 Assist, Recommend, Reversible Action, Orchestration으로 이어지며, 단계마다 고유한 Outcome, Guardrail, Evidence가 있습니다. 그래서 기업은 미래의 Use Case를 기다리며 큰 플랫폼을 짓는 대신 지금의 문제에 맞춰 투자할 수 있습니다.
| 기존 방식 | 새로운 AI 제품 방식 |
|---|---|
| 모델을 고르고 프롬프트를 만든 뒤 질문을 받기 시작 | 의도, 맥락, 도구, 승인, 실행, 피드백, 평가, 모니터링까지 제품 루프(Product Loop)를 먼저 설계한 뒤 자율성을 한 단계씩 높임 |
개발팀 참고 · 기술 세부 사항
Roadmap의 모든 단계는 Identity, Knowledge, API, Policy, Evaluation, Monitoring이라는 공통 Foundation을 함께 씁니다. 이 계층들을 모델과 분리해 두면 Product가 기술을 바꾸거나 Action을 늘려도 Journey 전체를 뜯어고칠 필요가 없습니다.
기업이 쓸 수 있는 새로운 기능
안전한 길은 한 단계씩 밟아 가는 것입니다. 먼저 답이 분명한 질문에 시스템이 정확히 답하게 합니다. 정확해지면 예약이나 문서 초안 발행처럼 되돌릴 수 있는 일을 맡깁니다. 돈이나 계약이 걸린 일은 통제할 수 있다는 것이 입증된 뒤에 넓힙니다.
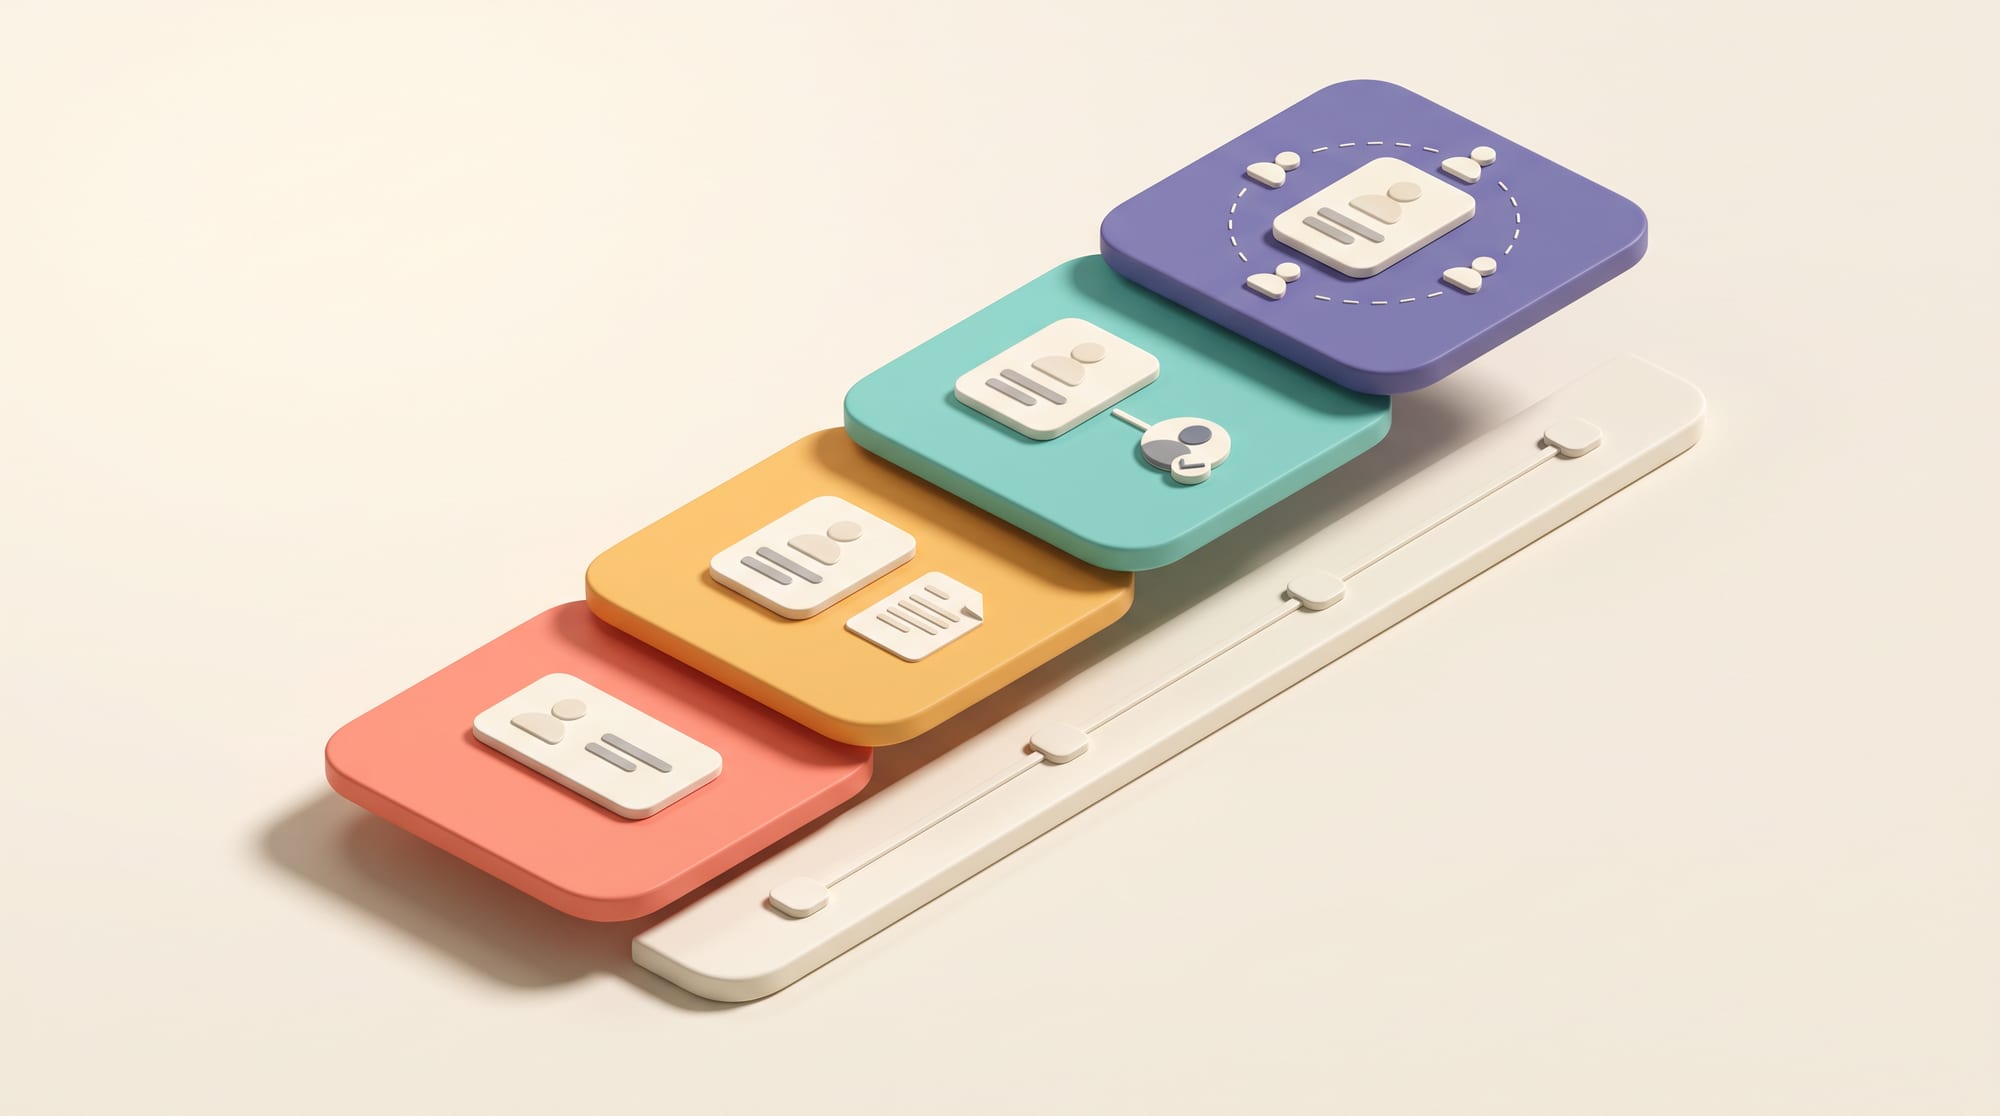
로드맵 한눈에 보기
첫 단계에서는 데이터를 검색하고 출처를 밝힐 수 있게 만듭니다. 다음 단계에서는 사람이 검토하는 조건으로 초안 작성이나 요약을 돕습니다. 그 뒤에 도구를 연결해 되돌릴 수 있는 작업을 처리하게 하고, 마지막으로 여러 단계나 여러 에이전트의 조율을 더합니다. 단계를 건너뛰는 것이 늘 잘못은 아니지만, 앞 단계의 기반은 시스템 안에 갖춰져 있어야 합니다.
쌓아 가야 할 역량
단계가 올라갈 때마다 프롬프트보다 지식 데이터의 책임 소재(Knowledge Ownership), 신원 확인, 권한, 도구 계약, 평가, 승인, 모니터링, 피드백 루프를 보강해야 합니다. 사용자 쪽 기능은 자율성 수준에 따라 답변에서 안내형 작업 공간(Guided Workspace), 실행 센터(Action Center), 예외 처리 대기열(Exception Queue)로 조금씩 바뀔 수 있습니다.
기술은 재사용할 수 있는 부품으로
아키텍처는 웹·모바일 화면, 백엔드·API, 지식 데이터, 에이전트 런타임, 정책, 평가, 관측 기능을 나눠 두어야 합니다. 그래야 모델을 바꾸거나 활용 사례를 넓혀도 전부 뜯어고치지 않습니다. AI 자율 개발(AI Autonomous Development)은 프로토타입, 코드, 테스트 작업을 앞당겨 주지만, 분명한 아키텍처와 리뷰, 보안 관행 아래에서 써야 합니다.
단계적으로 나아가는 이점
경영진은 투자 하나하나가 어떤 질문에 답하는지 알 수 있습니다. 팀은 검증되지 않은 시스템에 중요한 업무 프로세스를 맡기지 않고도 시범 운영에서 배우고, 이미 만든 부품은 다음 활용 사례에 다시 씁니다. 로드맵이 있으면 데이터, 가치, 준비 상태가 부족할 때 근거를 갖고 멈출 수도 있습니다.
- Level 1 Answer: 출처를 밝힐 수 있는 자료를 근거로 답합니다.
- Level 2 Assist: 초안이나 추천을 만들고, 실행 버튼은 사람이 누릅니다.
- Level 3 Act with Approval: 실행할 작업을 준비한 뒤 승인을 요청합니다.
- Level 4 Bounded Autonomy: 정해진 범위 안에서 표준 사례를 처리하고 감사 기록을 남깁니다.
가상 사례
실제로 쓰이는 모습
한 기업이 예약 에이전트를 추천 모드로 시작합니다. 그다음 예약 초안을 만들게 하고, 중복 예약, 시간대, 취소, 권한 항목이 테스트 세트를 통과한 뒤에야 실제 시간 확정을 엽니다.
가상 사례로, 한 소매 기업은 반품 정책을 출처와 함께 답하는 어시스턴트로 시작합니다. 2단계에서는 주문 상태를 요약하고 직원이 확인합니다. 3단계에서는 고객이 되돌릴 수 있는 방식으로 배송 일정을 다시 고를 수 있게 하고, 그다음 단계에서야 재고, 배송, 알림을 함께 조율합니다.
단계마다 통과 기준이 다릅니다. 답변의 정확도, 인계 내용의 완결성, 작업 성공률, 중복 처리 건수 같은 것입니다. 연동이 멈추면 시스템은 정보 안내로 돌아가거나 사람에게 넘길 수 있어서, 가장 똑똑한 부분이 작동하지 않는다는 이유로 고객 여정 전체가 멈추지는 않습니다.
Autonomy Ladder
근거, 되돌릴 수 있는 정도, 모니터링이 준비되었을 때 자율성을 높입니다. 팀이 기능을 자랑하고 싶다는 이유로는 높이지 않습니다.
모든 단계에 진행·중단 기준(Stop/Go Criteria)과 책임자가 있어야 합니다.
범위, 위험, 성과 측정 방법
개발팀 참고 · 기술 지표
Roadmap을 Use Case 수나 최고 Autonomy 수준으로 평가해서는 안 됩니다. Outcome, Adoption, Error Impact, Recovery, Cost per Successful Task, 운영 개시 후의 유지 부담을 측정해야 합니다. 모든 Pilot에는 Stop/Go Criteria와 Process를 고칠 권한이 있는 Owner가 있어야 하며, 그렇지 않으면 시스템은 Demo와 Production 사이에 갇힙니다.
추상화 계층 없이 제품을 모델 하나에 묶지 마십시오. AI에게 범위가 넓은 인증 정보(Credential)를 맡기지 말고, 성과당 비용을 재기 전에 확대하지 마십시오.
개발팀 참고 · 기술 지표
추적할 지표: Accepted Outcome, Tool Success, Approval Rate, Rollback, Incident, Latency, Total Cost
- Discover: 실제 업무를 따라가며 일반 사례와 예외 사례를 모읍니다.
- Assist: AI가 초안을 쓰거나 추천하고, 통제는 사람이 계속 맡습니다.
- Act: 테스트 세트를 통과한 뒤 도구(Tool)를 하나씩 엽니다.
- Scale: 모니터링, 대체 경로(Fallback), 비용, 책임자가 갖춰지면 확대합니다.
시범 운영에 책임자가 없거나, 데이터가 불안정하거나, 작업당 비용이 상한을 넘거나, 예전 오류가 감지되지 않은 채 다시 나타나면 확대를 멈춰야 합니다. 되돌아가 기반을 고치는 것도 진척이며, AI에서 물러서는 일로 볼 필요가 없습니다.
BUSINESS & PRODUCT READINESS
자율성을 높이기 전에 제품 기반을 다져야 시범 운영이 데모에 머물지 않습니다
개발팀 참고 · 기술 세부 사항
Capability Inventory를 만드십시오. Model이 무엇을 이해하는지, 데이터는 어디서 오는지, Tool은 무엇을 하는지, 권한은 누구에게 있는지, 결과를 되돌릴 수 있는지 정리합니다. 그다음 Use Case를 Value, Feasibility, Risk, Reversibility로 분류합니다. 데이터가 아직 불분명한 업무에서 높은 Level로 시작해서는 안 됩니다.
개발팀 참고 · 기술 세부 사항
Action을 열기 전에 Evaluation Set을 만들고 Happy Path, 불완전한 데이터, Prompt Injection, Tool Error, Duplicate, Permission Test를 넣습니다. Owner, Incident 대응, Cost Budget, Model Change Process도 빠짐없이 정합니다. AI를 쓰는 Product는 Model, 데이터, 사용자 행동이 계속 바뀌므로 지속적으로 테스트해야 합니다.
개발팀 참고 · 기술 지표
현재 조직의 데이터, API, Identity, Owner, 성과 측정이 어느 수준인지 Capability Inventory로 확인한 뒤, Use Case마다 알맞은 Autonomy 수준을 짝지어 줍니다. 되돌릴 수 없거나 높은 권한이 걸린 업무는 Human Approval을 계속 남겨 둘 수 있으며, 꼭 Fully Autonomous까지 갈 필요는 없습니다.
개발팀 참고 · 기술 세부 사항
처음부터 일반 사례, 누락 데이터, Prompt Injection, Tool Error, 중복 명령, 예외 사례로 Evaluation Set을 만들고, Run 비용과 운영 비용도 추정합니다. 품질이 떨어졌을 때 어떻게 감지할지 아는 일은 시연하는 날 Prototype이 작동한다는 것을 보여 주는 일만큼 중요합니다.
첫 번째로 노리는 성과는 무엇인가
자율성은 어느 수준이 알맞은가
되돌릴 수 없는 작업은 무엇인가
품질이 떨어지면 어떻게 알아챌 것인가
올바른 문제부터 정하고, 그에 맞는 수준의 AI를 고릅니다
DNA Maker는 실제 업무 프로세스와 데이터를 바탕으로 대표와 함께 AI 기회·자율성 지도(AI Opportunity/Autonomy Map)를 만듭니다. 웹사이트, 앱, 워크플로, 지식 검색, 에이전트 가운데 무엇이 맞는지 가려내고, 기술을 고르기 전에 가드레일과 가치 가설(Value Hypothesis)을 적습니다.
제품 발견(Product Discovery) 단계에서는 사용자 여정, 아키텍처 선택지, 데이터·연동 지도, 프로토타입을 만들어 사용자와 결정권자에게 테스트합니다. 모델 시연으로 끝나지 않도록, 시범 운영은 비즈니스 질문에 답하고 진행·중단 기준을 갖추게 설계합니다.
DNA Maker는 실제 업무 프로세스를 바탕으로 AI 기회·자율성 지도를 만들고, 데이터·연동, UX, 아키텍처, 가드레일부터 평가까지 계속 쓸 수 있는 제품 기반을 설계합니다. 모든 문제를 에이전트로 풀려 하지 않으며, 웹 앱, 워크플로, 검색이 더 단순하고 책임 소재가 분명한 답이라면 그쪽을 제안합니다.
시범 운영 대상을 정한 뒤에는 프로토타입, 웹·모바일, 백엔드, AI 에이전트, 도구, 승인, 모니터링, 운영 문서를 개발할 수 있으며, 엔지니어의 검토 아래 AI 자율 개발로 작업 속도를 높입니다. 아이디어가 여러 개라면 업무 프로세스, 데이터 샘플, 우려 사항을 가지고 오십시오. 성과를 잴 수 있는 첫 프로젝트 하나로 좁히고, 다음 단계를 위한 기반을 함께 만듭니다.
엔지니어링팀은 웹·모바일·백엔드, AI 에이전트, 도구·API, 사람 승인 단계, 평가, 관측 기능, 운영 관리 화면을 실제 운영 환경에 올릴 수 있는 수준까지 개발하며, 코드 리뷰, 테스트, 보안 관행 아래에서 AI 자율 개발로 작업을 앞당깁니다.
아이디어는 여러 개인데 어디서 시작할지 모르겠다면 업무 프로세스, 데이터 샘플, 우려 사항을 가지고 오십시오. DNA Maker가 아이디어를 분명하고 측정할 수 있는 시범 운영 하나로 좁히고, 검증되지 않은 선택지에 조직이 묶이지 않게 돕습니다.
SOFTWARE ENGINEERING GLOSSARY
소프트웨어 엔지니어링 용어집
마지막 용어집은 에이전트형 제품(Agentic Product)이라는 개념을 자율성 수준, 테스트 세트, 대체 경로, 모델 분리와 연결합니다. 공급업체를 바꾸거나 활용 사례를 늘릴 수 있는 로드맵을 책임 있게 세울 때 공통 언어로 쓰십시오.
| 용어 | 의미 | 쉬운 예시 | 개발팀에 물어봐야 할 질문 |
|---|---|---|---|
| Agentic Product | 정해진 도구, 규칙, 모니터링 아래에서 AI가 여러 단계를 계획하거나 직접 실행하는 제품. 텍스트만 생성하는 채팅 화면과 구분되는 형태 | 에이전트가 예약을 준비하고 사람에게 확인을 요청합니다. | 성과와 범위는 누가 책임집니까? |
| Autonomy | 시스템이 스스로 실행할 수 있는 정도. 같은 시스템이라도 답변은 자동으로 하면서 데이터 변경이나 거래 처리 전에는 사람의 승인을 받을 수 있으므로, 작업별로 따로 정해야 하는 수준 | 모든 단계마다 기다리지 않고 표준 사례를 처리합니다. | 어떤 근거가 확보되면 자율성을 높입니까? |
| Evaluation Set | 품질을 반복해서 테스트하는 데 쓰는 사례 묶음. 일반 사례, 누락 데이터, 예외, 공격 시도를 담고, 전문가가 인정한 정답이나 기준을 함께 갖춘 세트 | 일반 사례, 위험 사례, 정보가 빠진 사례 | 실제 예외 사례까지 다루고 있습니까? |
| Fallback | AI나 도구가 멈췄을 때의 대체 수단. 수작업 흐름으로 바꾸거나 사람에게 넘기는 식으로 작업과 맥락을 지켜야 하며, 시스템 장애 문구만 띄우는 것으로는 부족한 장치 | 데이터를 잃지 않고 작업을 사람의 처리 대기열로 넘깁니다. | 팀이 대체 경로를 실제로 연습해 보았습니까? |
| Model Abstraction | 제품 로직을 모델 공급업체와 분리하는 계층. 시스템에 주는 영향을 줄이면서 모델 버전 교체, 비용 통제, 대안 테스트를 할 수 있게 하는 장치 | 워크플로를 뜯어고치지 않고 모델을 바꿉니다. | 모델마다 다른 품질과 비용은 어떻게 테스트합니까? |
더 읽을거리(원문 자료): https://openai.github.io/openai-agents-js/