
- 紧急维修的费用比计划内维修高好几倍,因为它还连带着停线时间和交货延误。
- 先从几种“能提前知道”的故障入手,不要一开始就想预测所有故障。
- 没人接手处理的预警毫无价值,必须变成有具体人员、具体时间的维修工单。
从“提前知道就能采取行动”的故障入手
并非每种故障都能提前预警,有些会毫无征兆地突然损坏。应该先挑的,是您的技师已经能说出“听到这种声音,再过两周就要坏了”的那类故障。系统能接着学下去的,正是这类知识。
写给开发团队 · 技术细节
按安全、质量、产能(Throughput)和成本评估设备关键性(Asset Criticality),再挑选有前兆、预警提前量(Lead Time)足够采取行动的故障模式(Failure Mode),比如轴承(Bearing)振动、温度升高或电机电流变化。毫无征兆、瞬间发生的损坏,用冗余(Redundancy)或备件库存来应对,可能比用 AI 更合适。
做一份实用版的 FMEA:症状是什么,在哪里测,在什么负载(Load)下测,预警后要检查什么,由谁决定停机,备件要多久才能到。不要因为某台设备传感器多就选它,要选预警能改变工作计划的设备。
让状态监测数据和维修记录能互相对照
写给开发团队 · 技术细节
传感器数据必须带有 Timestamp、单位和 Context,比如 Speed、Load、Product、Start/Stop 和环境温度。Work Order 历史要写明症状、原因、检查发现、所用备件和实际耗时,只写“已修好”的记录没法用来训练系统。分析之前,先把 PLC、Gateway 和 CMMS 的时钟对齐。
| 数据 | 用来回答的问题 | 常见错误 |
|---|---|---|
| Vibration/Temperature | 设备状态什么时候开始变化 | 没有和负载关联 |
| Alarm/PLC State | 设备处于哪种运行模式 | 时间戳不一致 |
| Work Order | 实际发现了什么、修了什么 | 没有故障代码(Failure Code) |
| Production Context | 变化发生在哪种产品上 | 没有记录换型 |
如果故障记录很少,就用异常检测(Anomaly Detection)找出与正常状态的差异,交给技师检查。没有证据时,不要把异常分数解读成故障日期。要显示趋势和工况背景,让人来做判断。
把告警设计成维修工单
没人接手的告警,两周之内就会变成噪音。系统每次告警,都要能回答:谁要做什么,什么时候之前做完,不做会怎样。
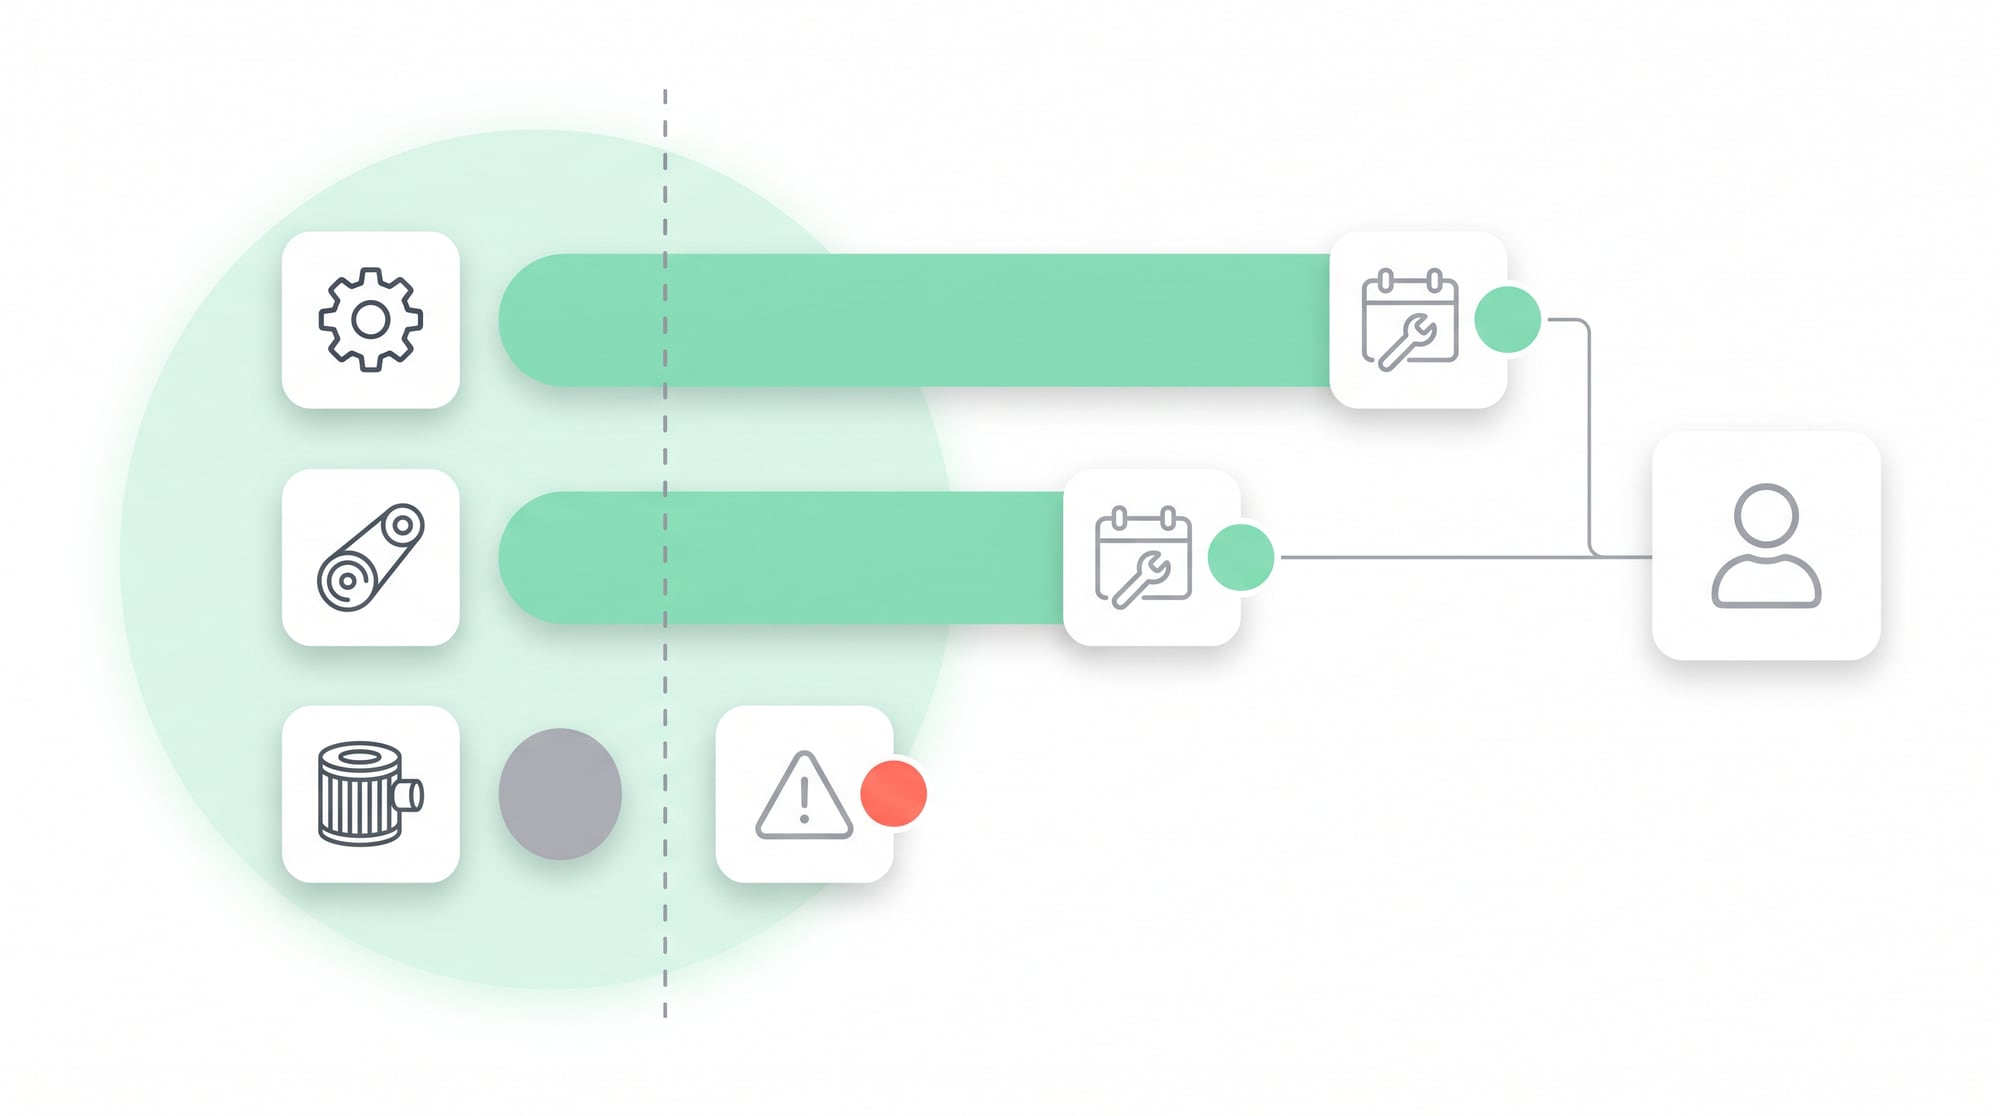
把告警分成 Watch(观察)、Inspect(检查)和 Act(处理)三级,各有标准和服务水平协议(SLA)。告警要写明设备、症状、开始时间、严重程度、证据和检查方法。技师确认或否定告警时,要记录理由,用来调整阈值(Threshold)。系统必须与 CMMS 打通,把消息发到聊天群里就没了下文,是行不通的。
写给开发团队 · 技术细节
先用影子模式(Shadow Mode),统计每一次 Alert 和每一次 Breakdown,包括系统没有预警的情况。Precision 低,团队会疲于应付 Alarm;Recall 低,风险依然存在;Lead Time 太短,就来不及安排计划。所以这三个指标要和 Downtime、Maintenance Cost 一起看。
在告警影响生产计划之前
- 技师看得懂证据,能把告警和检查工作衔接起来
- 生产部门能看到停机的成本和冒险运行的成本
- 最终由谁拍板很明确
- 传感器掉线或数值失真时有处理程序
- 备件和人手真的能及时响应
衡量设备可靠性,别只盯着模型
写给开发团队 · 技术细节
跟踪 Unplanned Downtime、Planned Work Ratio、MTBF、MTTR、Emergency Purchase、Overtime、False Alarm、Miss 和 Actionable Lead Time。与相近的设备比较,或者与按运行小时数调整过的基线(Baseline)比较。成本里要算上检查告警和维护传感器的开销。
写给开发团队 · 技术细节
推广时,按 Failure Mode 建立模板(Template),不要把同一个 Threshold 复制到所有设备上。初期每个月检查 Calibration、Data Drift 和 Operating Envelope 的变化,系统稳定后再按风险确定检查频率。新的 Model Version 必须先用历史数据回测,并经过影子模式运行,才能替换旧版本。
技师的紧急工作少了,计划做得更好了,预测性维护(Predictive Maintenance)就算成功,哪怕模型从来没有预测出“7 天内会坏”。能解释、能及时拿去检查的信号,比团队不相信的炫目预测有价值得多。
RELIABILITY TIP · 告警要有分量
先定告警预算(Alert Budget),再定阈值
和团队约定,一周能处理多少条需要检查的告警。如果系统发出的告警超出处理能力,就算准确度还过得去,也会没人理会。阈值一开始设得严一些,记录漏报,再根据故障成本逐步调整。这样做比任由报警响个不停、再要求技师忍耐,更能保住大家的信任。
告警卡(Alert Card)必须包含 5 项内容
设备、症状、趋势证据、运行工况(Operating Context),以及下一次检查(Next Inspection)和应完成的时间。缺了最后一项,告警就还没有和维修工作连起来。
提示:技师每次点“误报”时,提供 4–6 个理由选项,不要用长长的文本框。这样能收集到一致的调优数据,文书工作也不会增加太多。
从知识到真正能解决问题的系统
问题的根源
告警来得太晚、没有备件可用,或者没有接入技师实际使用的工单,预测模型再好也没有价值。
分步解决方案
让告警一路送到技师手里,变成能处理的工作
模型发现异常,预测性维护的工作还没有结束,因为技师还要知道该检查什么、什么时候检查、这些数据有多可靠。DNA Maker 与客户的可靠性工程师(Reliability Engineer)和维修团队一起,把故障模式、运行工况和响应步骤梳理出来,做成实际可用的告警卡和工作流。设备诊断仍由专家负责,我们帮忙把他们的知识连同传感器数据和工单一起送到现场,减少来回切换屏幕,也减少没人负责的告警。
解决方案可以是状态监测门户(Condition Monitoring Portal)、移动巡检应用(Mobile Inspection App),或者把时序数据(Time-series Data)与 CMMS 连接起来的 AI 智能体(AI Agent),用来创建检查任务、收集技师反馈,并跟踪数据和模型的健康状况。DNA Maker 可以与客户的 OT/IT 团队一起,设计数据流、现场用户体验、API 以及边缘与云端架构,并负责软件开发和模型监控(Model Monitoring)。如果您的企业已经有设备数据,却还没能转化成维修工作,我们可以帮忙找出从信号到决策之间的缺口,并做出让技师先试用的原型,再决定是否投资推广。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
这张表用不着背。它的用处是让管理层、工作负责人和开发团队沟通时,对同一个词不会有两种理解。请把释义、示例和右侧的问题一起看,这些问题常常能在开发开始之前,把隐藏的范围、风险和成本揭示出来。
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| Anomaly Detection | 找出偏离正常模式的数值 | 发现振动值与同一负载区间的正常情况不同 | 哪类异常真的能引出具体行动? |
| CMMS | 管理维修保养工作的系统 | 根据告警生成工单 | 告警怎样转成工单,又不产生重复工作? |
| Threshold | 触发告警的界限值 | 温度连续 10 分钟超标 | 阈值按风险定还是按平均值定?由谁批准? |
| Time-series Data | 按时间顺序排列的数据 | 每秒一次的振动读数 | 时间、单位和运行状态都对得上吗? |
| Model Monitoring | 持续跟踪模型是否仍然表现良好 | 传感器数据的模式发生变化时发出提醒 | 模型或数据质量下降时,通知谁? |