
- ค่าซ่อมฉุกเฉินแพงกว่าค่าซ่อมตามแผนหลายเท่า เพราะมันพ่วงมากับเวลาที่ไลน์หยุดและของส่งไม่ทัน
- เริ่มจากอาการเสียที่ “รู้ล่วงหน้าได้” ไม่กี่แบบก่อน ไม่ใช่พยายามทำนายทุกอย่างพร้อมกัน
- การเตือนที่ไม่มีคนรับผิดชอบต่อ ไม่มีค่า ต้องแปลงเป็นใบสั่งซ่อมที่มีคนและวันเวลาจริง
เริ่มจาก Failure ที่ “รู้ล่วงหน้าแล้วทำอะไรได้”
ไม่ใช่ทุกอาการเสียจะเตือนล่วงหน้าได้ บางอย่างพังทันทีโดยไม่มีสัญญาณ สิ่งที่ควรเริ่มคืออาการที่ช่างของคุณบอกได้อยู่แล้วว่า “ถ้าได้ยินเสียงแบบนี้ อีกสองสัปดาห์มันจะไป” ความรู้แบบนี้แหละที่ระบบเรียนต่อได้
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
จัด Asset Criticality จากความปลอดภัย คุณภาพ Throughput และต้นทุน แล้วเลือก Failure Mode ที่มีอาการนำและ Lead Time พอให้ลงมือ เช่น Bearing สั่น อุณหภูมิสูง หรือกระแสมอเตอร์เปลี่ยน ความเสียหายที่เกิดทันทีโดยไม่มีสัญญาณอาจเหมาะกับ Redundancy หรือ Stock มากกว่า AI
ทำ FMEA แบบใช้งานจริง: อาการคืออะไร วัดตรงไหน ภายใต้ Load ใด ถ้าเตือนแล้วต้องตรวจอะไร ใครตัดสินหยุด และอะไหล่ใช้เวลาหาเท่าไร อย่าเลือก Asset เพราะมี Sensor เยอะ เลือกเพราะคำเตือนเปลี่ยนแผนงานได้
ทำข้อมูล Condition และ Maintenance ให้คุยกันรู้เรื่อง
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
Sensor ต้องมี Timestamp, หน่วย และ Context เช่น Speed, Load, Product, Start/Stop และอุณหภูมิแวดล้อม ประวัติ Work Order ต้องระบุอาการ สาเหตุ สิ่งที่พบ อะไหล่ และเวลาจริง ข้อความ “ซ่อมแล้ว” ใช้สอนระบบไม่ได้ ตรวจนาฬิกา PLC, Gateway และ CMMS ให้ตรงกันก่อนวิเคราะห์
| ข้อมูล | ใช้ตอบคำถาม | ข้อผิดพลาดพบบ่อย |
|---|---|---|
| Vibration/Temperature | สภาพเปลี่ยนเมื่อใด | ไม่ผูก Load |
| Alarm/PLC State | เครื่องอยู่โหมดใด | Timestamp ต่างกัน |
| Work Order | พบและแก้อะไรจริง | ไม่มี Failure Code |
| Production Context | ความเปลี่ยนเกิดกับสินค้าใด | ไม่บันทึก Changeover |
หาก Failure มีน้อย ใช้ Anomaly Detection เพื่อชี้ความต่างจากภาวะปกติและให้ช่างตรวจ อย่าแปล Score เป็นวันเสียโดยไม่มีหลักฐาน แสดง Trend และ Context เพื่อให้คนตัดสินได้
ออกแบบ Alert ให้กลายเป็น Work Order
การแจ้งเตือนที่ไม่มีใครรับผิดชอบต่อ จะกลายเป็นเสียงรบกวนภายในสองสัปดาห์ ทุกครั้งที่ระบบเตือน ต้องตอบได้ว่าใครต้องทำอะไร ภายในเมื่อไร และถ้าไม่ทำจะเกิดอะไรขึ้น
แบ่ง Watch, Inspect และ Act พร้อมเกณฑ์และ SLA Alert ต้องบอก Asset อาการ เวลาที่เริ่ม ความรุนแรง หลักฐาน และวิธีตรวจ เมื่อช่างยืนยันหรือปฏิเสธ ให้บันทึกเหตุผลเพื่อปรับ Threshold ระบบต้องเชื่อม CMMS ไม่ใช่ส่งข้อความเข้ากลุ่มแชตแล้วหายไป
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
เริ่ม Shadow Mode นับทุก Alert และทุก Breakdown รวมสิ่งที่ระบบไม่เตือน เมื่อ Precision ต่ำ ทีมจะเหนื่อยกับ Alarm; เมื่อ Recall ต่ำ ความเสี่ยงยังอยู่; เมื่อ Lead Time สั้นเกินก็วางแผนไม่ได้ จึงต้องดูสามค่าคู่กับ Downtime และ Maintenance Cost
ก่อนให้ Alert มีผลต่อแผนผลิต
- ช่างเข้าใจหลักฐานและเชื่อม Inspection ได้
- Production เห็นต้นทุนหยุดกับต้นทุนเสี่ยง
- มีผู้ตัดสินใจสุดท้ายชัดเจน
- มีขั้นตอนเมื่อ Sensor ขาดหรือค่าเพี้ยน
- มีอะไหล่และทรัพยากรตอบสนองจริง
วัด Reliability ไม่วัดโมเดลอย่างเดียว
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
ติดตาม Unplanned Downtime, Planned Work Ratio, MTBF, MTTR, Emergency Purchase, Overtime, False Alarm, Miss และ Actionable Lead Time เปรียบเทียบกับ Asset ใกล้เคียงหรือ Baseline ที่ปรับตามชั่วโมงเดินเครื่อง รวมค่าตรวจ Alert และการดูแล Sensor ในต้นทุน
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
เมื่อขยาย ให้สร้าง Template ต่อ Failure Mode ไม่ใช่คัดลอก Threshold เดียวทุกเครื่อง ตรวจ Calibration, Data Drift และการเปลี่ยน Operating Envelope ทุกเดือนแรกและตามความเสี่ยงหลังระบบนิ่ง Model Version ใหม่ต้องผ่านข้อมูลย้อนหลังและ Shadow ก่อนแทนรุ่นเดิม
Predictive Maintenance สำเร็จเมื่อช่างมีงานฉุกเฉินน้อยลงและวางแผนได้ดีขึ้น แม้โมเดลไม่เคยทำนายคำว่า “เสียใน 7 วัน” การให้สัญญาณที่อธิบายได้และนำไปตรวจทันเวลามีคุณค่ากว่าคำทำนายหวือหวาที่ทีมไม่เชื่อ
RELIABILITY TIP · ทำ Alert ให้มีราคา
ตั้ง Alert Budget ก่อนตั้ง Threshold
ตกลงกับทีมว่าหนึ่งสัปดาห์รับ Alert ที่ต้องตรวจได้กี่รายการ หากระบบส่งเกิน Capacity ต่อให้แม่นพอใช้ก็ถูกละเลย เริ่ม Threshold ค่อนข้างเข้ม เก็บ Miss และค่อยปรับตามต้นทุน Failure วิธีนี้รักษาความเชื่อมั่นได้ดีกว่าปล่อย Alarm รัวแล้วขอให้ช่างอดทน
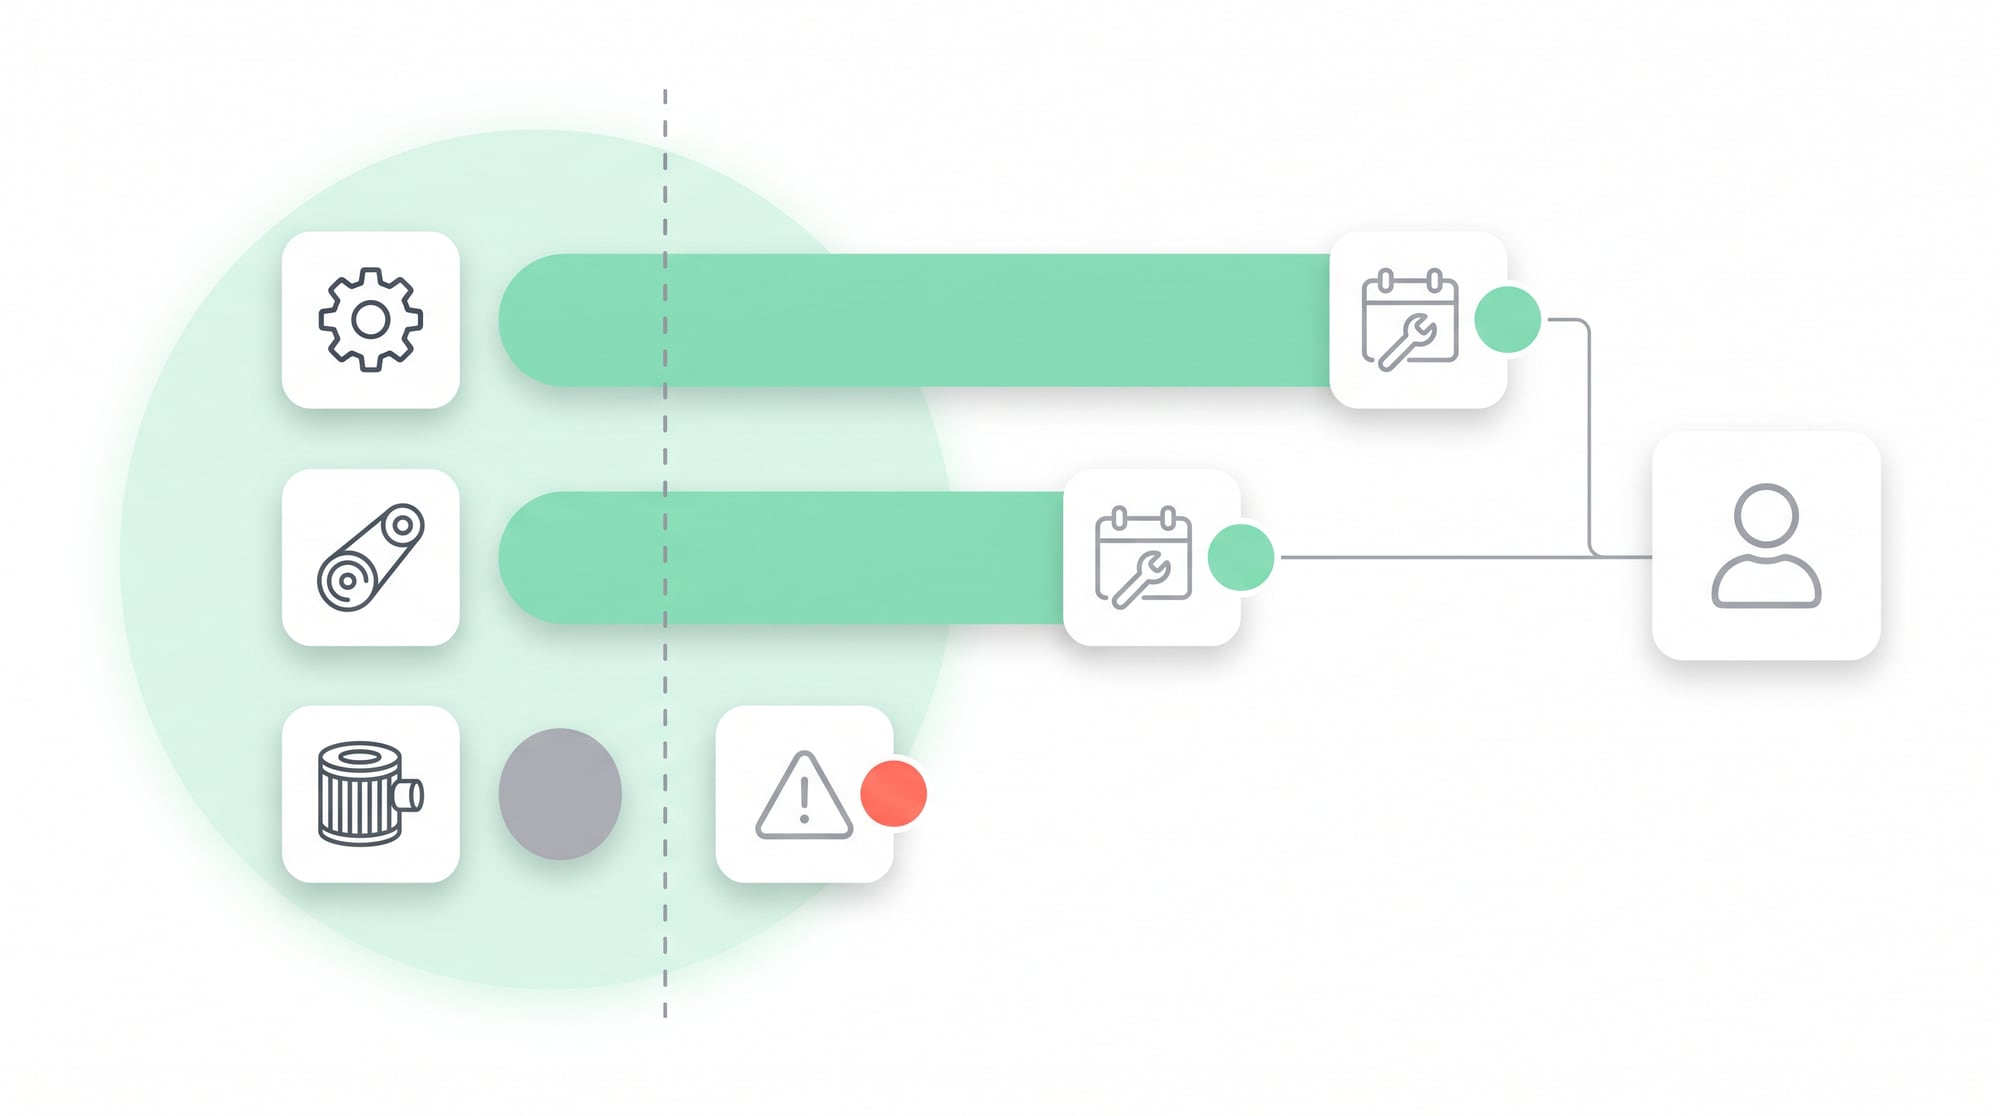
Alert Card ต้องมี 5 อย่าง
Asset, อาการ, หลักฐาน Trend, Operating Context และ Next Inspection พร้อมเวลาที่ควรทำ หากขาดข้อสุดท้าย Alert ยังไม่เชื่อมกับงานซ่อมบำรุง
Tip: ทุกครั้งที่ช่างกด False Alarm ให้มีตัวเลือกเหตุผล 4–6 แบบแทนช่องข้อความยาว คุณจะได้ข้อมูลปรับระบบที่สม่ำเสมอโดยไม่เพิ่มงานเอกสารมากเกินไป
จากความรู้สู่ระบบแก้ปัญหาที่ใช้งานได้จริง
แก่นของปัญหา
โมเดลทำนายไม่มีค่า หาก Alert ไม่ทัน Lead Time ไม่มีอะไหล่ หรือไม่เชื่อมกับ Work Order ที่ช่างใช้จริง
แนวทางแก้แบบเป็นขั้น
- เลือก Asset/Failure Mode จาก Criticality และ Actionable Lead Time
- ทำ Data Alignment ระหว่าง Sensor, Operating State และประวัติซ่อม
- สร้าง Alert Card, Threshold, Feedback และ CMMS Workflow ก่อน Scale
ทำให้ Alert เดินต่อไปถึงมือช่างและกลายเป็นงานที่จัดการได้
Predictive Maintenance ไม่จบตอนโมเดลพบความผิดปกติ เพราะช่างยังต้องรู้ว่าจะตรวจอะไร เมื่อใด และข้อมูลนั้นเชื่อถือได้เพียงใด DNA Maker ทำงานร่วมกับ Reliability Engineer และทีมซ่อมของลูกค้าเพื่อถอด Failure Mode, Operating Context และขั้นตอบสนองออกมาเป็น Alert Card กับ Workflow ที่ใช้จริง เราไม่วินิจฉัยเครื่องจักรแทนผู้เชี่ยวชาญ แต่ช่วยให้ความรู้ของเขาถูกส่งมาพร้อมข้อมูล Sensor และ Work Order ลดการเปิดหลายจอและลด Alert ที่ไม่มีเจ้าของ
Solution อาจเป็น Condition Monitoring Portal, Mobile Inspection App หรือ AI Agent ที่เชื่อม Time-series Data กับ CMMS สร้าง Inspection, รับ Feedback จากช่าง และติดตามสุขภาพของข้อมูล/โมเดล DNA Maker ช่วยออกแบบ Data Flow, UX หน้างาน, API, Edge/Cloud Architecture, Software Development และ Model Monitoring ร่วมกับทีม OT/IT ของลูกค้า หากองค์กรมีข้อมูลเครื่องจักรอยู่แล้วแต่ยังกลายเป็นงานซ่อมไม่ได้ เราพร้อมช่วยสำรวจช่องว่างตั้งแต่สัญญาณจนถึงการตัดสินใจ และสร้างต้นแบบที่ช่างทดลองได้ก่อนลงทุนขยาย
SOFTWARE ENGINEERING GLOSSARY
คลังคำศัพท์การพัฒนาซอฟต์แวร์
ตารางนี้ไม่ได้มีไว้ให้ท่องจำ แต่ช่วยให้ผู้บริหาร เจ้าของงาน และทีมพัฒนาคุยกันโดยไม่ตีความคนละแบบ อ่านทั้งความหมาย ตัวอย่าง และคำถามด้านขวา เพราะคำถามเหล่านี้มักเปิดเผยขอบเขต ความเสี่ยง และต้นทุนที่ซ่อนอยู่ก่อนเริ่มพัฒนา
| คำศัพท์ | คืออะไร | ตัวอย่างที่เข้าใจง่าย | คำถามที่ควรถามทีมพัฒนา |
|---|---|---|---|
| Anomaly Detection | การหาค่าที่ต่างจากรูปแบบปกติ | พบแรงสั่นผิดจากช่วง Load เดียวกัน | ความผิดปกติแบบใดนำไปสู่การกระทำได้จริง? |
| CMMS | ระบบจัดการงานซ่อมบำรุง | สร้าง Work Order จาก Alert | Alert จะกลายเป็น Work Order โดยไม่สร้างงานซ้ำอย่างไร? |
| Threshold | ค่าขอบเขตที่ใช้เริ่มการแจ้งเตือน | อุณหภูมิเกินเกณฑ์ต่อเนื่อง 10 นาที | ตั้งเกณฑ์จากความเสี่ยงหรือจากค่าเฉลี่ย และใครอนุมัติ? |
| Time-series Data | ข้อมูลที่เรียงตามเวลา | ค่าการสั่นทุกวินาที | เวลา หน่วย และ Operating State ตรงกันหรือไม่? |
| Model Monitoring | ติดตามว่าโมเดลยังทำงานดีหรือไม่ | แจ้งเมื่อข้อมูล Sensor เปลี่ยนรูปแบบ | ใครรับแจ้งเมื่อคุณภาพโมเดลหรือข้อมูลลดลง? |