
- 大多数公司一年只尝试几次新东西,因为每个想法都得先变成大项目,才能拿到预算。
- 把每次试验的成本降下来,能做的试验次数自然会增加。
- 要事先商定标准:什么算通过,什么该叫停,免得最后演变成办公室政治。
1. 从一年几个大项目,到持续不断地试验
如果公司里每个想法都要先批下一大笔预算才能试,一年也就试得了两三次,而且每次花费都大到没人敢说它行不通。公司其实有想法,缺的是一条让想法往前推进的路。
传统公司把预算和人手集中起来,只做少数几款产品,因为每一项研究、每一个原型都很贵。AI 可以帮忙总结客户的声音、生成备选方案、模拟使用体验、制作图片和销售页面,公司就能更频繁地从市场换回认知,不用每多一个想法就多招一批人。
写给开发团队 · 技术细节
要提高的是每月“得到答案的假设”的数量,推出多少完整产品并不重要。好的创新工厂以客户问题为输入(Input),经过阶段关卡(Stage Gate),输出四种结论之一:学习(Learn)、终止(Kill)、转向(Pivot)或规模化(Scale)。
2. 设计五个阶段的创新漏斗
解决办法是给每个想法设置清楚的关卡,写明要拿出什么证据才能进入下一步。标准清楚了,叫停某个想法就成了依据数据作出的判断,不牵涉谁输谁赢。
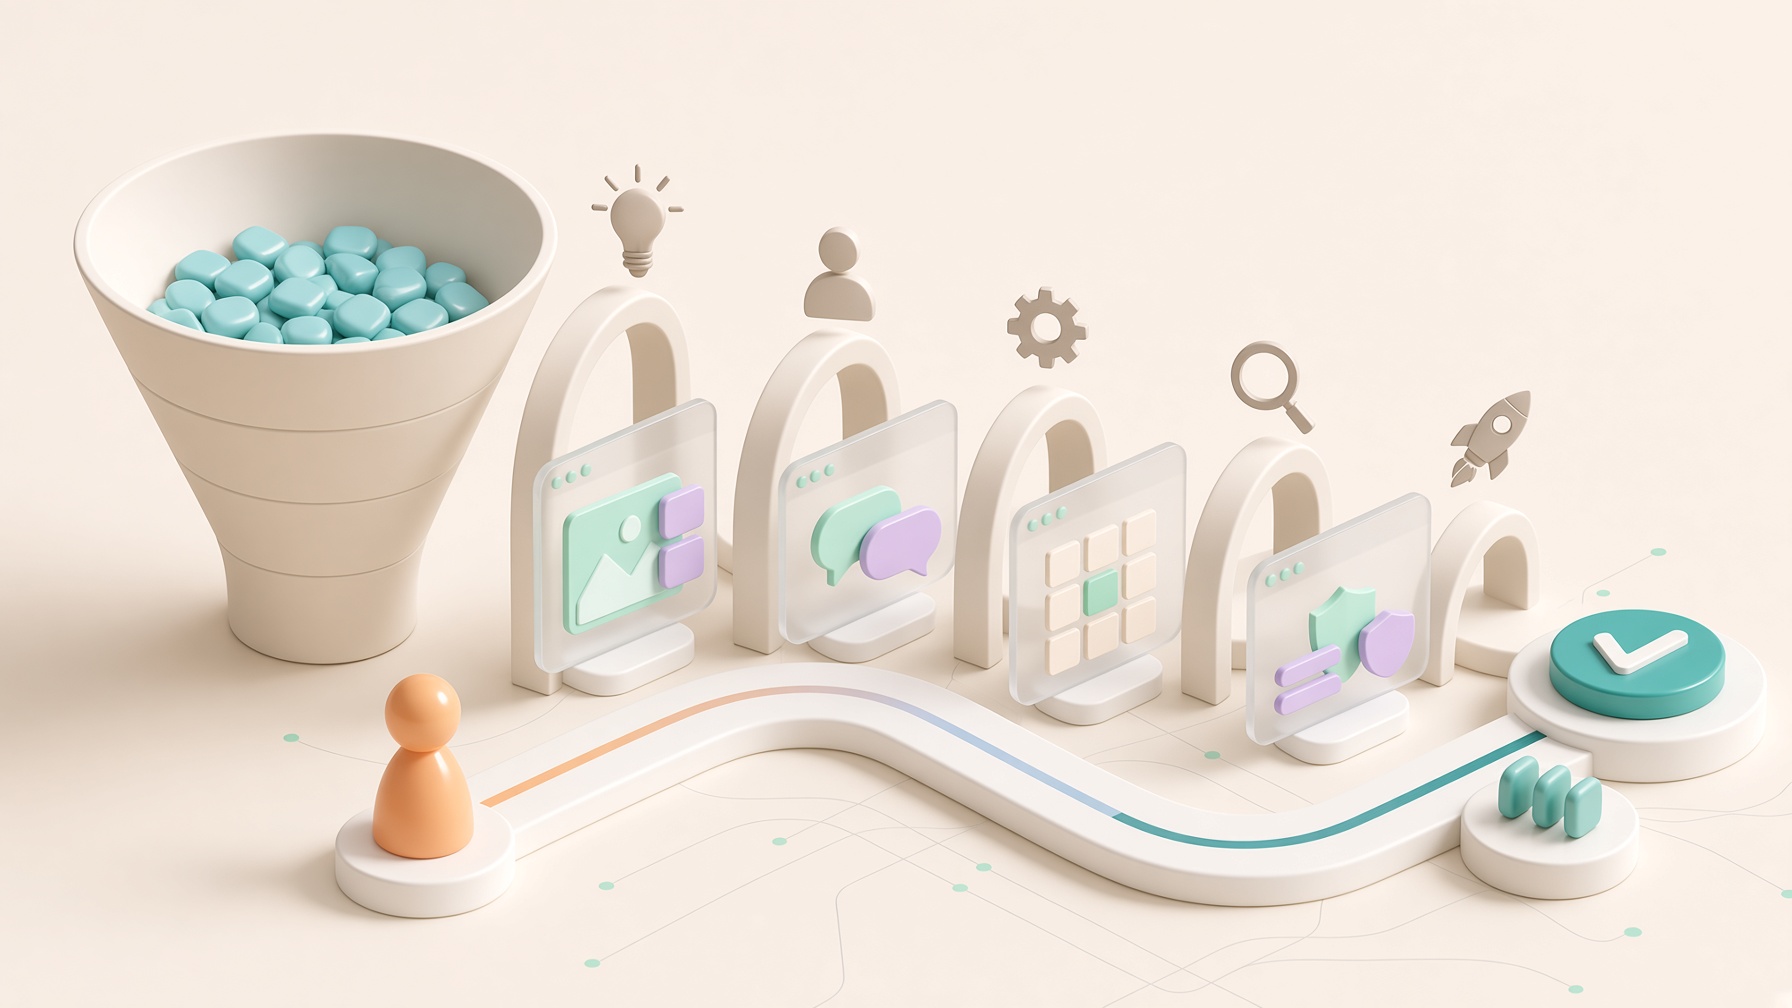
| 阶段 | 要回答的问题 | 通过关卡所需的证据 |
|---|---|---|
| 信号(Signal) | 问题或机会是否真实存在? | 反复出现的行为或投诉 |
| 问题(Problem) | 问题是否重要?谁手里有预算? | 访谈 + 问题造成的成本 |
| 提案(Offer) | 哪种提案能引起兴趣? | 预约、试用、留下联系方式 |
| 解决方案(Solution) | 能否交付预期的成果? | 原型 + 实际成效 |
| 规模化(Scale) | 经济账和重复使用情况是否健康? | 单位经济效益 + 留存率 |
每道关卡都要定好预算和时限。大量想法本来就应该在早期阶段停下来,这说明系统在正常运转,不能算失败。别让提出想法的人独自当裁判,要用看到结果之前就商定好的标准。
3. 用真实数据建一台发现机会的引擎
写给开发团队 · 技术细节
把工单(Ticket)、销售通话、搜索记录、用户评价、退货原因和外部趋势汇总到一起。AI 可以帮忙聚类、追踪随时间的变化、摘出典型的客户原话,但团队要核查数据来源和样本代表性,别让一个大客户的声音盖过整个市场。
写给开发团队 · 技术细节
建立机会待办清单(Opportunity Backlog),记录细分客群、出现频率、严重程度、现有解决方案、战略契合度和证据负责人。团队每月按评分挑选问题,不靠凭空头脑风暴起步。同时开放渠道,让员工提交信号并附上证据。
把趋势和需求分开看。一项新技术也许很有意思,却未必对应用户真正要完成的任务(Job-to-be-Done)。等问题通过关卡之后,再用 AI 去探索可行的做法;不要为了给 AI 找个用武之地去做产品。
4. 原型工厂:按要回答的问题选择逼真程度
写给开发团队 · 技术细节
测试文案和定价用落地页(Landing Page),测试操作步骤用可点击原型(Clickable Prototype),测试成果用人工代办的管家式服务(Concierge Service),实体产品则用实物模型(Mockup)或小批量试产。不要为了测试客户有没有兴趣就搭建完整系统。AI 能帮忙生成变体(Variant),但数量要控制在团队审得过来的范围内。
写给开发团队 · 技术细节
建立组件库(Component Library):调研模板、价值主张、品牌规范、设计系统(Design System)、落地页、问卷和数据分析。所有实验都用同一套标准,既缩短准备时间,结果也能互相比较。
5. 检验客户的实际投入,称赞不算数
设定一些要用户付出代价的行为作为衡量依据,比如预约时间、提交资料、拿真实工作来试用、付定金或预购。“挺有意思”这类回答分量很轻。获客测试和价值测试要分开做,因为广告能带来点击,产品却未必能产生效果。
按用户群组(Cohort)和细分客群分析,不要把不同客户群的结果混在一起。开始之前先定好标准,例如 50 个目标客户中至少 8 个约了面谈,或者 30% 的用户在两周内回来再次使用。客户拒绝的原因和人工交付的成本都要记录下来。
试验结束后,AI 可以帮忙总结规律,但终止、转向还是规模化,由产品负责人(Product Owner)决定并说明理由。要保留决策记录(Decision Log),这样人员变动后,团队也不会把同一个想法再试一遍。
6. 想法组合的经济账
预算按 70% 投向核心业务改进、20% 投向相邻领域、10% 投向变革性项目来分配。采用分批投资(Investment Tranche)的方式,证据越扎实,追加的预算越多,不要在概念阶段就批下全部预算。
写给开发团队 · 技术指标
衡量单次实验成本(Cost per Experiment)、拿到证据所需时间(Time to Evidence)、淘汰率(Kill Rate)、实验进入规模化的比例(Experiment-to-Scale)以及新产品带来的利润。淘汰率低,可能说明关卡把得太松,未必是团队每个想法都押对了。实验做了很多,却没有一款产品走到规模化,说明系统卡在了原型之后的环节。
7. 不拖慢速度的治理方式
把试验按风险分级(Risk Tier)。在内部测试文案,简单审批即可;涉及健康、金融、个人数据和对客户的承诺,就必须有专业人员把关。还没有真实客户的原型,不必套用生产环境的检查清单。同时要明令禁止编造虚假宣传,或在未获授权的情况下使用数据。
准备安全的沙箱、合成数据和经过批准的工具,让团队在护栏(Guardrail)之内快速试验。产出物的知识产权、所用素材的来源许可和客户数据,从一开始就要登记清楚。将来有机会规模化时,就不必回头把整套法律依据重新补一遍。
8. 90 天建成创新工厂
- 第 1–15 天:汇总信号,定义漏斗和关卡
- 第 16–30 天:搭建模板、组件和实验仪表盘
- 第 31–60 天:选 3–5 个想法,和真实客户一起跑冲刺(Sprint)
- 第 61–75 天:分析瓶颈,调整关卡和团队
- 第 76–90 天:选一个想法进入规模化验证,并建立每月一轮的节奏
总结:AI 让做原型变便宜了,但公司要把这份速度变成学习循环,才能真正占到优势。要建立信号引擎、阶段关卡、原型工厂,以及奖励证据、不奖励工作量的衡量机制。好的创新工厂既能产出新产品,也让公司有能力尽快停掉不划算的想法。
把试验新想法的成本降到每个月都做得起
值得试验的想法,来自贴近客户、身在一线的人,很少来自软件开发团队。我们常看到的情况是:公司想法很多,却没有让想法往前走的路,所以什么事都得先变成大项目才能拿到预算。DNA Maker 帮企业把这套机制理顺,把漏斗的每个阶段定义清楚:要有什么证据才能进入下一阶段,由谁决定,最多花多长时间。规则清楚了,叫停一个想法就只是按标准作出的判断,牵扯不到办公室政治。
既能快速试验、又不失控的结构
工具方面,我们开发能降低单次试验成本的东西,比如可以拆开重新组合的原型套件、能测出真实兴趣的落地页,以及把所有测试结果集中存放、方便跨想法比较的系统。我们用 AI 加快分析、起草原型和编写第一版代码,上线到正式系统之前一律由工程师审查。如果您的公司有好几个想法一直停留在会议上、还没人动手试过,我们可以帮您设计第一轮试验,并让它真正跑起来。
SOFTWARE ENGINEERING GLOSSARY
软件工程术语表
这组术语用于讨论怎样快速试验产品,并且衡量出结果。
| 术语 | 是什么 | 通俗示例 | 高管应问开发团队的问题 |
|---|---|---|---|
| Prototype | 用来检验想法的早期模型,还不是正式投入使用的系统 | 做一个模拟界面让客户试用,看他们能不能看懂 | 这个原型检验的是哪条假设?如果没通过,我们怎么知道? |
| MVP | 能在真实客户身上证明价值的最小产品 | 先只在一个城市开通服务,衡量需求有多大 | 哪些部分可以砍掉,同时仍能证明价值? |
| Feature Flag | 不必发布新版本就能开启或关闭某项功能的开关 | 先给一小部分客户开放新功能 | 功能出了问题,我们多快能关掉?由谁来关? |
| A/B Test | 让条件相近的两组用户分别使用两种方案,比较哪种效果更好 | 在同一个页面上测试两种文案 | 看到的差异是否已经显著到可以据此决策? |
| Backlog | 等待处理的工作或想法清单,标有优先级 | 已经通过筛选、等待进入下一轮试验的想法 | 待办清单(Backlog)由谁排优先级?依据什么标准? |