
- ระบบอัตโนมัติจะค่อย ๆ งอกขึ้นทั่วบริษัทโดยไม่มีใครนับ จนวันหนึ่งไม่มีใครตอบได้ว่ามีอะไรทำงานอยู่บ้าง
- สิ่งที่ต้องมีก่อนเพิ่มตัวถัดไปคือทะเบียนว่ามีอะไร ใครดูแล ใช้ข้อมูลอะไร และใช้เงินเท่าไร
- ทุกตัวควรมีปุ่มหยุด และมีวิธีทำงานสำรองเมื่อระบบใช้ไม่ได้
1. Agent Sprawl คือ Shadow IT รุ่นที่ลงมือแทนคนได้
เรื่องนี้เคยเกิดมาแล้วสมัยที่แต่ละแผนกแอบสมัครโปรแกรมใช้เอง จนบริษัทไม่รู้ว่าข้อมูลไปอยู่ที่ไหนบ้าง คราวนี้จะเกิดเร็วกว่าเดิม เพราะสร้างระบบอัตโนมัติหนึ่งตัวใช้เวลาไม่ถึงชั่วโมง
เครื่องมือ SaaS เดิมอาจเก็บข้อมูล แต่ Agent สามารถเรียก API ส่งข้อความ เปลี่ยน Record และทำงานต่อเนื่อง หากไม่มีทะเบียน บริษัทไม่รู้ว่าใครสร้าง ใช้ข้อมูลอะไร และยังจำเป็นหรือไม่ Agent ที่ Sponsor ลาออกอาจคง Credential และ Schedule ต่อไป
ความเสี่ยงเพิ่มเมื่อ Agent เรียก Agent อื่น ความผิดหนึ่งจุดอาจกระจายผ่าน Workflow เช่น สรุปข้อมูลผิดนำไปสู่ราคาและข้อความลูกค้าผิด การควบคุมต้องมอง Chain ทั้งเส้น ไม่ตรวจเฉพาะผลลัพธ์สุดท้าย
2. สร้างทะเบียนและวงจรชีวิต Agent
ลองถามตัวเองว่าตอนนี้ตอบได้ไหมว่าบริษัทมีระบบอัตโนมัติกี่ตัว ใครเป็นเจ้าของ และตัวไหนยังใช้อยู่ ถ้าตอบไม่ได้ นั่นคืองานชิ้นแรกที่ต้องทำ
สำหรับทีมพัฒนา · ตัวชี้วัดเชิงเทคนิค
Catalog ต้องค้นได้และเชื่อมกับ Identity ระบุ Owner, Sponsor, Version, Model, Knowledge, Tools, Environment, KPI, Cost และ Dependencies สถานะควรมี Draft, Testing, Approved, Suspended และ Retired พร้อมหลักฐานอนุมัติ
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
สร้าง Intake Process ให้ทีมเสนอ Use Case ตรวจ Agent ที่มีอยู่ก่อนอนุญาตสร้างใหม่ ใช้ Template และ Connector กลาง ลดการซ้ำ กำหนด Expiry หากไม่มีการใช้งานหรือ Sponsor ไม่ยืนยัน ระบบลดสิทธิ์หรือปิดอัตโนมัติ
| Lifecycle | Control | หลักฐาน |
|---|---|---|
| Create | Purpose, Sponsor, Risk | ทะเบียนและ Design |
| Test | Evaluation, Red Team | Test Report |
| Run | Identity, Log, Budget | Dashboard |
| Change | Version + Re-evaluate | Release Record |
| Retire | Revoke, Export, Delete | Closure Evidence |
3. Agent ต้องมี Identity เหมือนพนักงาน แต่ Guardrail มากกว่า
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
ห้ามใช้บัญชีร่วม สร้าง Identity เฉพาะให้ติดตามได้ว่า Action มาจาก Agent ใด กำหนด Sponsor ที่รับผิดและสิทธิ์ตาม Least Privilege แยก Agent Acting-on-behalf-of ผู้ใช้กับ Autonomous Agent ที่ไม่มีคนอยู่ใน Session
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
ใช้ Time-bound Access, Approval และ Conditional Policy Agent อ่านข้อมูลเท่าที่ Task ต้องใช้ ไม่ให้สิทธิ์ Admin เพียงเพื่อเชื่อมง่าย Secret ต้องอยู่ใน Vault และหมุนได้ เมื่อ Sponsor ย้ายงานต้องมีการโอนหรือระงับอัตโนมัติ
4. จัด Risk Tier เพื่อไม่ควบคุมมากหรือน้อยเกินไป
- Tier 1 Assist: อ่านข้อมูลไม่ลับและสร้าง Draft คนตรวจทุกครั้ง
- Tier 2 Internal Action: เขียนระบบภายในที่ย้อนกลับได้ มี Sampling และ Log
- Tier 3 External/Material: ติดต่อคน เปลี่ยนข้อมูลสำคัญ หรือมีผลการเงิน ต้อง Approval และ SLA
- Tier 4 High Impact: การจ้าง เครดิต สุขภาพ กฎหมาย หรือความปลอดภัย ต้อง Assessment และผู้เชี่ยวชาญเต็มรูปแบบ
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
Risk Tier กำหนด Evaluation, Monitoring, Approval และความถี่ Access Review งานสรุปประชุมไม่ควรผ่านกระบวนการเท่าการอนุมัติสินเชื่อ แต่ทุก Tier ยังต้องมี Owner และข้อมูลที่อนุญาต
5. Observability ต้องตอบว่า Agent คิดและทำอะไร
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
Log เชื่อม Request, Plan, Tool Call, Data Source, Policy Decision, Human Approval และ Outcome ใช้ Trace ID ตามงานข้าม Agent ห้ามเก็บข้อมูลลับเกินจำเป็นและกำหนด Retention ตาม Risk
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
Dashboard แสดง Success, Exception, Latency, Cost, Policy Violation และ Outcome Alert เมื่อ Agent ทำ Pattern แปลก ใช้ Tool มากผิดปกติ หรือคุณภาพ Drift สุ่ม Replay และทดสอบ Golden Cases ทุก Release
สร้าง Explainable Receipt สำหรับ Action สำคัญ: ทำอะไร เมื่อไร ในนามใคร ใช้ข้อมูลและ Policy ใด และย้อนกลับอย่างไร สิ่งนี้ช่วยทั้ง Support, Audit และความไว้วางใจผู้ใช้
6. ควบคุมต้นทุนแบบ FinOps สำหรับ Agent
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
Agent หลายขั้นอาจเรียกโมเดลและเครื่องมือซ้ำ ติด Budget ต่อ Task, Agent, Team และเดือน ใช้โมเดลเล็กกับ Classification/Extraction และโมเดลแพงเฉพาะ Reasoning ที่จำเป็น Cache ข้อมูลและจำกัด Loop
ทำ Chargeback หรือ Showback ให้ทีมเห็นต้นทุน Agent ที่ไม่มี Outcome หรือใช้ต่ำต้องถูกรวม/ปิด การลด Cost ไม่ควรทำให้คุณภาพและความปลอดภัยต่ำกว่า Guardrail
7. เตรียม Incident และ Business Continuity
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
กำหนด Playbook: Detect, Contain, Revoke, Rollback, Notify และ Learn มี Kill Switch ต่อ Agent/Tool และ Global Emergency Mode ทดสอบ Tabletop เช่น Agent ส่งข้อมูลผิดจำนวนมากหรือ Credential รั่ว
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
รักษา Manual Fallback และ Capacity ขั้นต่ำสำหรับ Workflow สำคัญ สำรอง Configuration, Prompt, Policy และ Data Lineage Vendor Outage ต้องไม่ทำให้บริษัทไม่รู้สถานะงาน ตั้ง RTO/RPO ตามผลกระทบ
8. Operating Model เมื่อ Agent เพิ่มถึงหลักร้อย
สำหรับทีมพัฒนา · รายละเอียดเชิงเทคนิค
ใช้ Federated Model: Central Platform/Security ดู Identity, Policy, Observability และ Catalog ส่วน Domain Team เป็นเจ้าของ Workflow, Knowledge และ Outcome ตั้ง AI/Agent Council สำหรับมาตรฐานกับความเสี่ยงสูง ไม่อนุมัติ Task รายวันทุกชิ้น
สำหรับทีมพัฒนา · ตัวชี้วัดเชิงเทคนิค
ทบทวน Portfolio รายไตรมาส Scale, Improve, Merge หรือ Retire วัด Coverage ของทะเบียน Access Review และ Incident รวมกับ Business Value สร้างทีม Red/Quality ที่ทดสอบ Agent สำคัญแบบอิสระจากผู้สร้าง
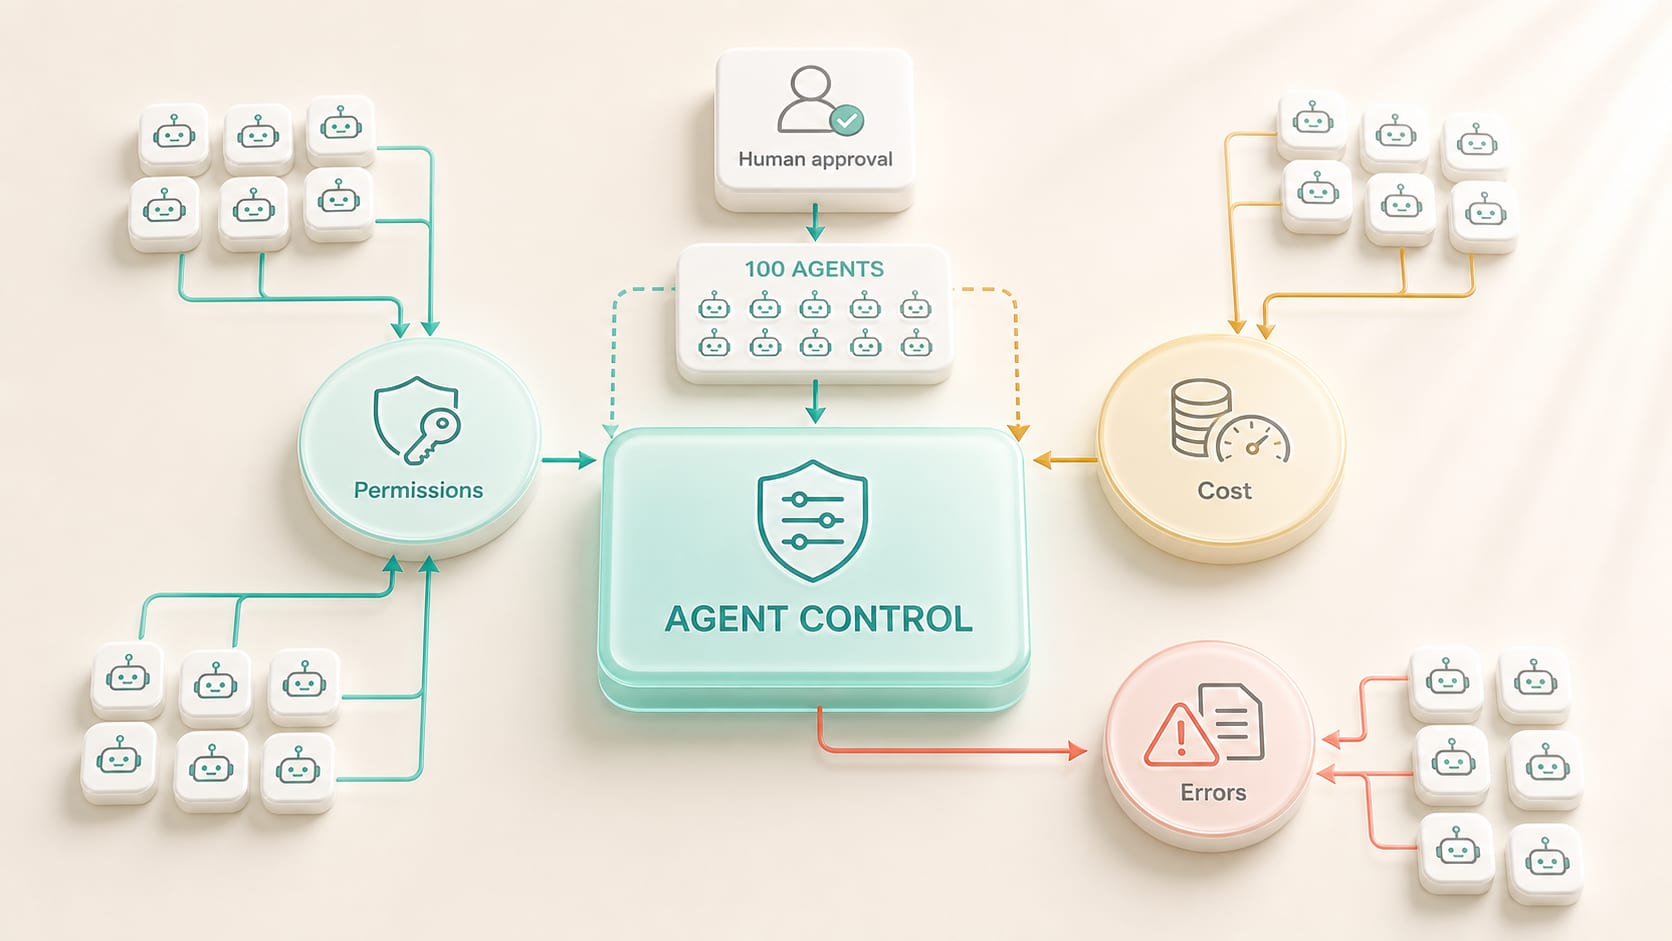
สรุป: Agent 100 ตัวต้องถูกบริหารเป็น Workforce ที่มี Identity, Sponsor, Lifecycle, Risk Tier, Cost และ Incident Control เริ่ม Control Plane ตั้งแต่จำนวนน้อย เพราะการย้อนหลังแก้ Credential และ Owner หลัง Sprawl มีต้นทุนสูง Governance ที่ดีไม่ชะลอการสร้าง แต่ให้ทีมสร้างเร็วบนรางที่ตรวจสอบได้
วางระบบทะเบียนและการควบคุมก่อนจำนวน Agent จะโตเกินคุม
ทีม IT และ Security ของคุณคือคนที่รู้ว่าองค์กรยอมรับความเสี่ยงระดับใดได้ และข้อมูลชุดใดห้ามออกนอกระบบ ส่วนหัวหน้าสายงานคือคนที่รู้ว่างานใดพลาดแล้วเสียหายมาก DNA Maker ทำหน้าที่รวบรวมสองมุมนี้ให้กลายเป็นกติกาที่บังคับได้จริงในระบบ ไม่ใช่แค่นโยบายในเอกสาร เราช่วยจัดทำทะเบียน Agent ที่ระบุว่าใครเป็นเจ้าของ ใช้ข้อมูลใด มีสิทธิ์อะไร ค่าใช้จ่ายเท่าไร และอยู่ใน Risk Tier ใด พร้อมวงจรชีวิตตั้งแต่ขออนุมัติจนถึงปลดระวาง
สิ่งที่ต้องมีก่อนเพิ่ม Agent ตัวถัดไป
ระบบที่ตามมาคือ Control Plane ที่รวมทะเบียน สิทธิ์ การตั้งงบต่อ Agent การเก็บ Log และหน้าจอที่ตอบได้ว่าตอนนี้มีอะไรทำงานอยู่ ใครเป็นเจ้าของ และใช้เงินไปเท่าไร เราวางระบบแจ้งเตือนเมื่อค่าใช้จ่ายหรืออัตราความผิดพลาดเกินเกณฑ์ พร้อม Kill Switch และแผนสำรองสำหรับงานที่หยุดไม่ได้ วิธีเริ่มที่ได้ผลคือทำทะเบียนของสิ่งที่มีอยู่แล้ววันนี้ก่อน แม้จะยังไม่ครบ ถ้าคุณตอบไม่ได้ว่าตอนนี้บริษัทมี Agent หรือ Automation กี่ตัวและใครดูแล นั่นคือสัญญาณให้เริ่ม
SOFTWARE ENGINEERING GLOSSARY
คลังคำศัพท์การพัฒนาซอฟต์แวร์
คำศัพท์กลุ่มนี้เกี่ยวกับการกำกับดูแลระบบอัตโนมัติจำนวนมากให้ยังปลอดภัย
| คำศัพท์ | คืออะไร | ตัวอย่างที่เข้าใจง่าย | คำถามที่ผู้บริหารควรถามทีมพัฒนา |
|---|---|---|---|
| Service Account | บัญชีสำหรับระบบหรือ Agent ใช้ทำงาน แยกจากบัญชีของพนักงาน | Agent ใช้บัญชีของตัวเองเข้าถึงระบบ ไม่ใช้บัญชีพนักงานร่วม | แต่ละระบบใช้บัญชีของใคร และถอนสิทธิ์ได้ทันทีหรือไม่? |
| Observability | ความสามารถในการรู้ว่าระบบกำลังทำอะไรและทำไมจึงได้ผลแบบนั้น | ย้อนดูได้ว่า Agent ตัวนี้เรียกข้อมูลชุดใดก่อนตอบผิด | เมื่อเกิดปัญหา เราใช้เวลานานแค่ไหนกว่าจะรู้สาเหตุ? |
| FinOps | การบริหารต้นทุนระบบให้เห็นและควบคุมได้เป็นรายหน่วยงานหรือรายงาน | ตั้งงบต่อเดือนให้ Agent แต่ละตัวและแจ้งเตือนเมื่อใกล้ชน | ต้นทุนต่อการทำงานหนึ่งครั้งคือเท่าไร และใครรับผิดชอบ? |
| Risk Tier | การจัดระดับความเสี่ยงของงาน เพื่อกำหนดว่าต้องควบคุมมากน้อยแค่ไหน | งานที่ส่งถึงลูกค้าถูกจัดระดับสูงกว่างานสรุปภายใน | เราจัดระดับด้วยเกณฑ์ใด และใครอนุมัติระดับสูงสุด? |
| Decommission | การปลดระวางระบบที่ไม่ใช้แล้วอย่างเป็นระบบ พร้อมเก็บข้อมูลและตัดสิทธิ์ | ปิด Agent ที่ไม่มีคนใช้และเก็บ Log ไว้ตามนโยบาย | ใครตัดสินใจปิด และข้อมูลที่เหลืออยู่จัดการอย่างไร? |